[논문리뷰] What Did I Just Say? Self-Listening for Full-Duplex Speech Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Xuanning Zhou, Junyi Ao, Xiaotong Liu, Tom Ko, Benyou Wang, Haizhou Li
1. Key Terms & Definitions (핵심 용어 및 정의)
- Anchoring: 모델이 중단(Interruption)된 시점에 자신이 실제로 사용자에게 출력(Play)한 음성 내용을 정확히 파악하고, 이를 바탕으로 후속 응답을 결정하는 능력.
- Self-Listening: 모델이 생성한 음성 중 사용자에게 실제로 재생된 부분을 모델의 입력 경로(Speech-input pathway)로 다시 공급하여, 모델이 자신의 재생 상태를 실시간으로 모니터링하게 하는 메커니즘.
- AnchorSpeech: 정교한 Anchoring 능력을 학습하고 평가하기 위해 구축된 시간 정렬(Time-aligned) 데이터셋으로, 학습 및 테스트를 위한 homogeneous split을 포함함.
- Full-Duplex: 모델이 음성을 생성함과 동시에 사용자 입력을 실시간으로 청취하여, 중단이나 백채널(Backchannel) 상황을 능동적으로 처리하는 상호작용 방식.
- Three-channel Interleave: 사용자 음성, 모델 텍스트, 그리고 모델이 이미 재생한 음성(Played model speech)을 시간 단위로 직렬화하여 모델에 입력하는 데이터 형식.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Full-Duplex 모델이 인터럽트 상황에서 자신이 실제로 발화한 내용을 인지하지 못하는 'Anchoring Gap' 문제를 해결하고자 한다. 기존의 Full-Duplex 시스템들은 텍스트 생성, 음성 합성(TTS), 오디오 재생이 비동기적으로 이루어지기 때문에, 모델의 내부 상태(생성된 텍스트)와 사용자에게 전달된 실제 음성 간의 불일치가 발생한다. 결과적으로 사용자가 중단 후 "어디까지 말했어?" 또는 "다시 말해줘"라고 요청할 때 모델이 정확히 대응하지 못하는 한계가 존재한다 [Figure 1]. 이러한 문제로 인해 구조화된 정보 전달이 필요한 내비게이션이나 튜터링 상황에서 모델의 응답 일관성이 크게 저하된다.
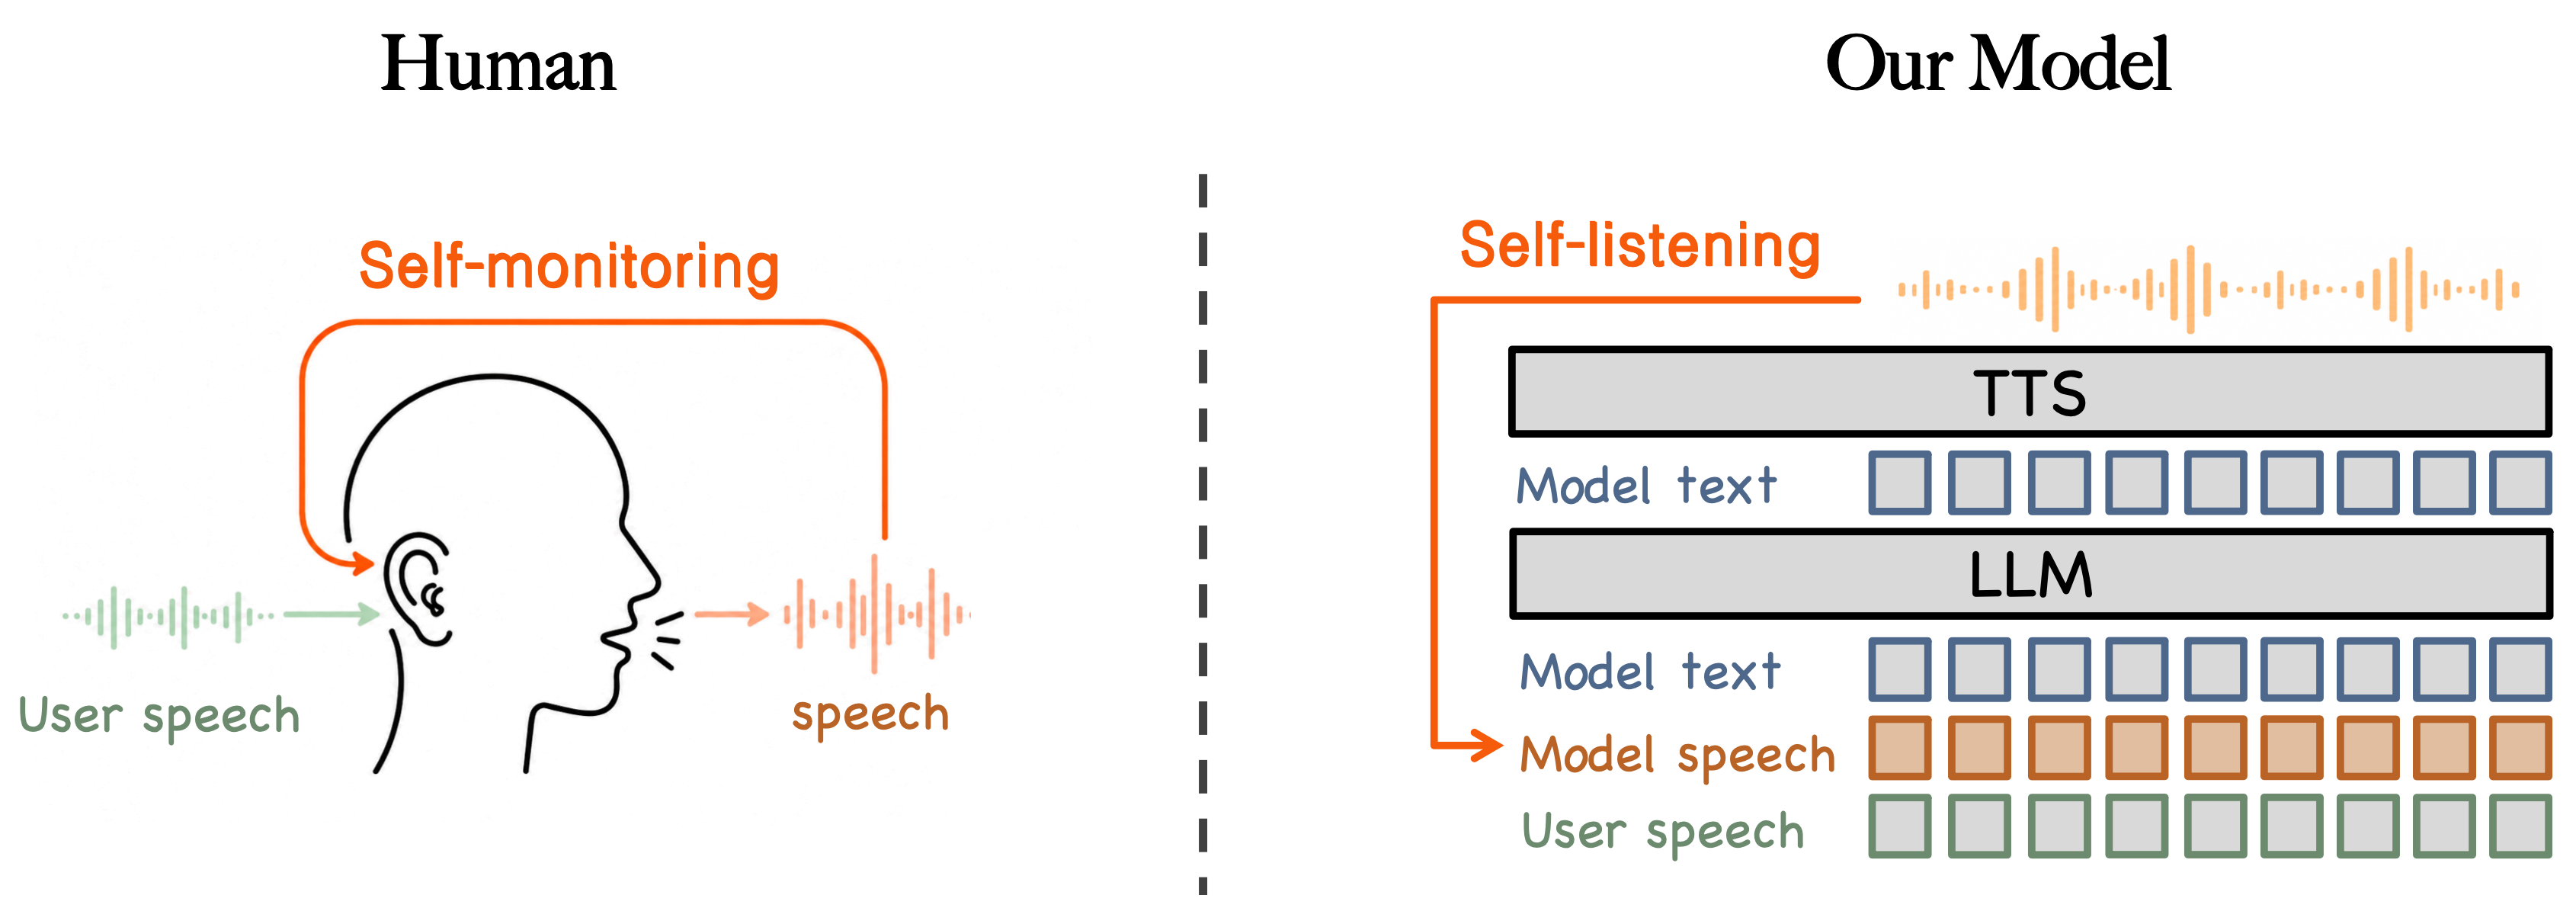
Figure 1 — 인간의 자가 청취 기반의 Self-Listening 개념도
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 재생된 음성을 모델 입력으로 다시 공급하는 Self-Listening 아키텍처를 제안한다 [Figure 3]. 이 방법론은 사용자 음성(User speech), 재생된 모델 음성(Played model speech), 그리고 모델 텍스트(Model text)를 시간 단위로 인터리빙(Interleave)하여 모델이 자신의 실시간 재생 범위를 Causally 파악하게 한다. 특히, AnchorSpeech 데이터셋을 통해 정교한 Anchoring 능력을 학습하며, LoRA 기반의 2단계 학습(Structural adaptation 및 Full-duplex adaptation)을 수행한다. 실험 결과, 제안 모델은 AnchorSpeech-test에서 73.0%의 Anchoring Accuracy를 달성하여 상용 baseline인 GPT-Realtime-2.1 대비 29.2%p 향상된 성능을 보였다 [Table 1]. 또한, Self-Listening 채널을 제거한 2-channel 모델과의 비교(7.8% vs 73.0%)를 통해, 해당 메커니즘이 65.2%p의 성능 향상을 직접적으로 견인함을 확인하였다. 마지막으로, Full-Duplex-Bench v1.5에서 서브 초 단위의 응답 Latency를 유지하며 실시간성을 확보하였다 [Table 2].
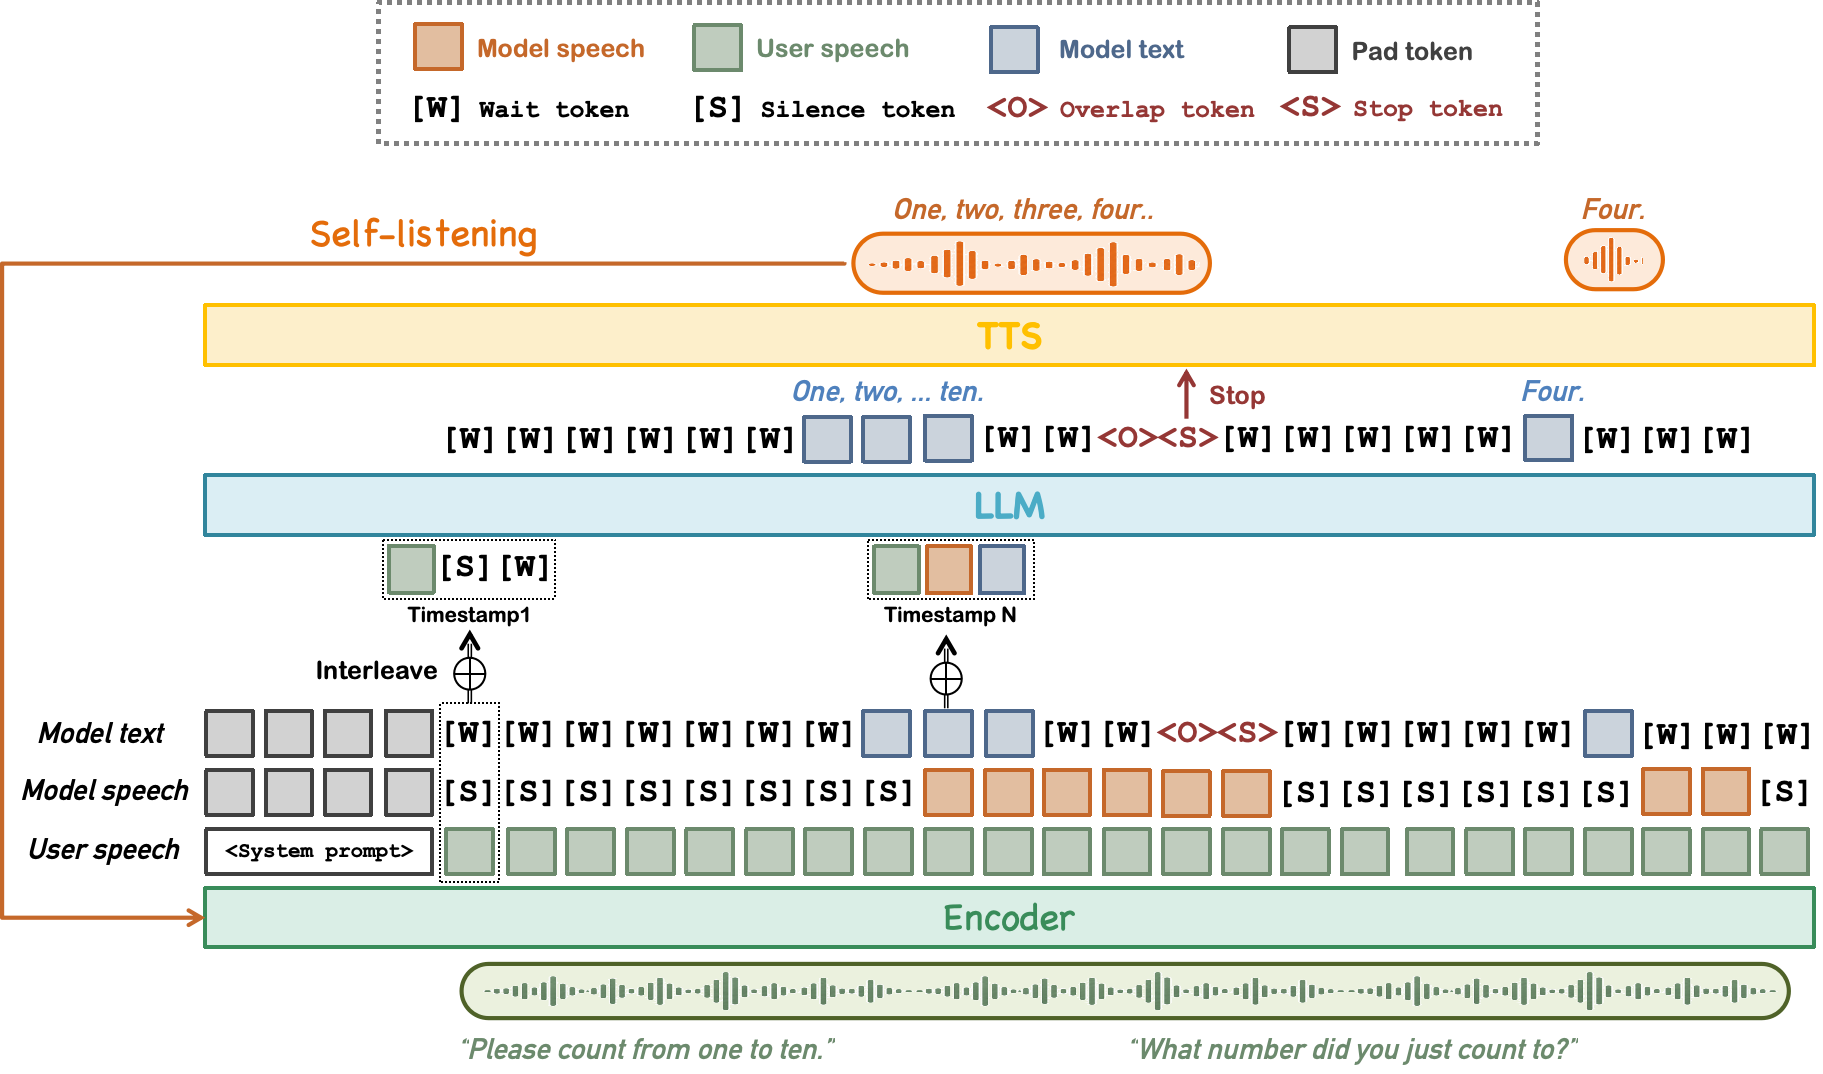
Figure 3 — Self-Listening 기반 전체 아키텍처
4. Conclusion & Impact (결론 및 시사점)
본 논문은 실시간 음성 상호작용에서 모델이 자신의 재생 상태를 인지하는 것이 핵심적인 기능임을 규명하고, 이를 위한 Self-Listening 기법을 성공적으로 도입하였다. 이 연구는 단순히 turn-taking 관리만을 수행하던 기존 Full-Duplex 모델의 한계를 극복하고, 모델이 자신의 발화와 재생 사이의 인과적 관계를 이해하게 함으로써 고품질의 대화형 AI 구현에 기여한다. 특히, 산업계에서 요구하는 구조화된 정보 제공 서비스의 신뢰성을 크게 높일 수 있는 기술적 토대를 마련하였다. 향후 연구에서는 Anchoring 능력과 기존의 능숙한 Turn management 간의 trade-off를 최적화하는 통합적 접근이 필요할 것으로 보인다.
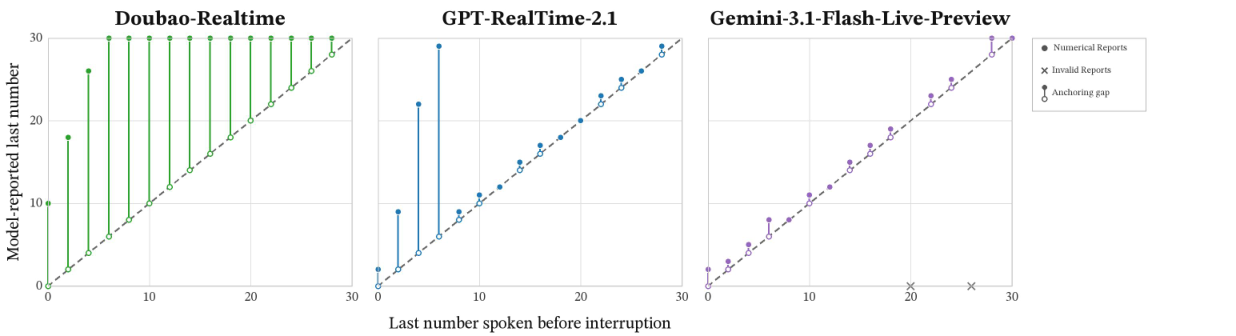
Figure 2 — 기존 모델의 Anchoring Gap 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] A Glance Is All You Need: Single-Pass Fine-Grained Image Captioning with SimLoss
- [논문리뷰] Thinking While Speaking: Inference-Time Knowledge Transfer for Responsive and Intelligent Conversational Voice Agents
- [논문리뷰] Duration Aware Scheduling for ASR Serving Under Workload Drift
- [논문리뷰] AdaCodec: A Predictive Visual Code for Video MLLMs
- [논문리뷰] Joint Agent Memory and Exploration Learning via Novelty Signals
Review 의 다른글
- 이전글 [논문리뷰] VidaForge: Open Research Infrastructure for Video Pretraining Data Recipes
- 현재글 : [논문리뷰] What Did I Just Say? Self-Listening for Full-Duplex Speech Models
- 다음글 [논문리뷰] What LLM Trading Agents Actually Do in Production: A Six-Month, Population-Scale Record from Two Fleets
댓글