[논문리뷰] Breaking the Vision-Action Shortcut: Latent Interface Training for Generalizable Robotics Foundation Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Jianman Lin, Shailesh Shailesh, Zhongyi Luo, Jiafei Duan
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Vision-Action Shortcuts: 모델이 실제 작업 수행과 무관한 시각적 단서(visual cues)에 의존하여 동작을 생성하는 현상으로, 학습 분포와 테스트 분포가 달라질 때 일반화 성능을 저하시키는 주요 원인입니다.
- Latent Interface Training (LIT): 시각적 정보가 동작 생성에 미치는 영향을 제어하기 위해 제안된 2단계 학습 전략으로, 이미지 없이 동작 우선순위(action prior)를 먼저 학습하고 이후 포즈(pose)로 감독되는 잠재 인터페이스를 통해 시각 정보를 주입합니다.
- VLA (Vision-Language-Action) Models: 시각적, 언어적 입력을 처리하여 로봇의 동작을 생성하는 모델 아키텍처입니다.
- WAM (World-Action Models): 환경의 미래 상태를 예측하는 세계 모델(world model) 정보를 동작 생성에 활용하는 로봇 모델 프레임워크입니다.
- SE(3) End-Effector Pose: 로봇 그리퍼의 3차원 위치와 방향을 나타내는 좌표계로, 본 논문에서 공간적 목표(spatial goal)를 정의하는 핵심 지표로 사용됩니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 로봇 파운데이션 모델이 학습 데이터 내에서는 강력한 성능을 보이지만, 카메라 구도나 조명 등 시각적 분포가 변화할 때 성능이 급격히 저하되는 일반화 문제를 해결하고자 합니다. 기존 모델들은 시각적 표현을 동작 생성에 직접적으로 사용하면서 학습 데이터의 표면적인 상관관계에 과도하게 의존하는 vision–action shortcuts에 취약합니다 [Figure 1]. 이러한 현상을 극복하기 위해서는 작업과 무관한 시각적 변동에는 둔감해지면서도, 작업 수행에 필수적인 공간적 정보는 유지하는 정교한 시각적 조건화(visual conditioning) 방식이 필요합니다 [Figure 1].
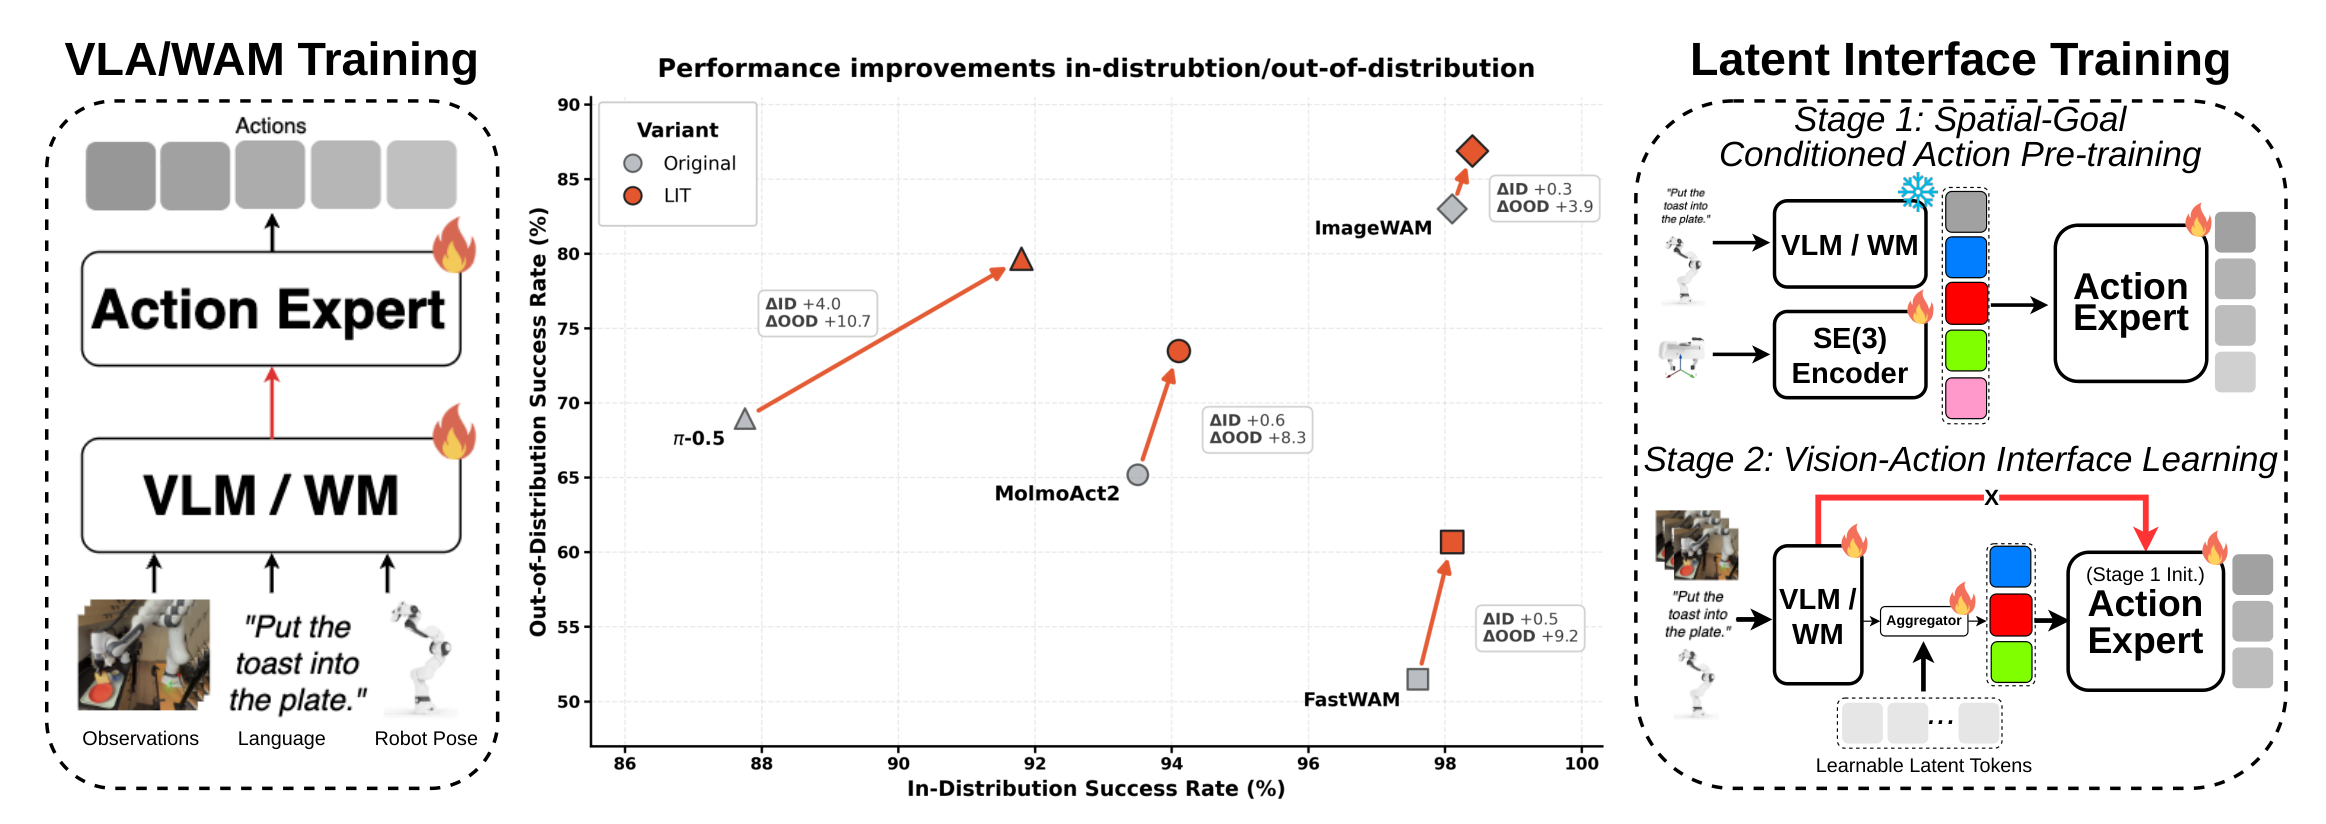
Figure 1 — 기존 학습 대비 LIT의 구조
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 논문은 공간적 목표를 이용한 2단계 학습 프레임워크인 LIT를 제안합니다 [Figure 2]. Stage 1에서는 이미지 입력 없이 언어, 로봇 상태, 그리고 동작의 종단 SE(3) end-effector pose만을 사용하여 공간적 목표 기반의 동작 우선순위를 학습합니다. Stage 2에서는 학습된 잠재 인터페이스(latent interface)가 시각적/의미론적 정보를 취합하여 동작 전문가(action expert)에게 제공하는 유일한 통로 역할을 하며, 이때 인터페이스는 Stage 1에서 사용된 종단 포즈를 재구성하도록 감독(supervision)을 받습니다 [Figure 2].
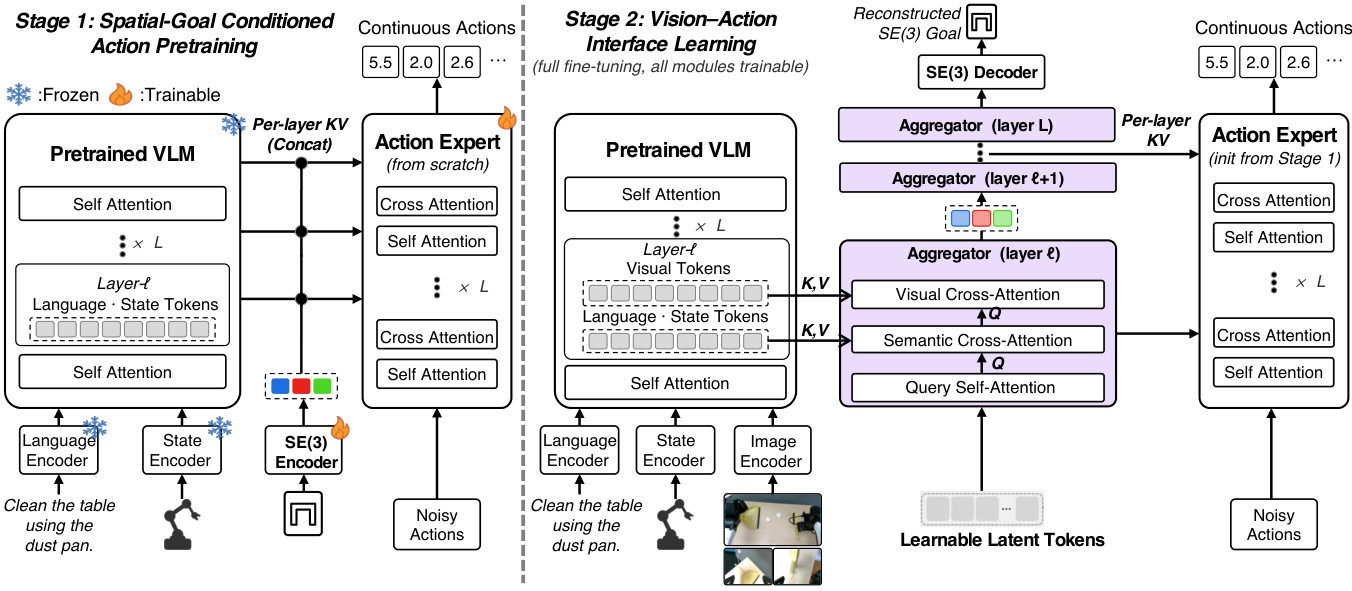
Figure 2 — LIT의 2단계 학습 프레임워크
실험 결과, LIT는 π0.5, MolmoAct2, FAST-WAM, ImageWAM 등 4가지 다양한 아키텍처에서 기존 모델 대비 LIBERO-Plus 성공률을 3.87%에서 10.70%까지 향상시켰습니다 [Table II]. 특히 조명 변화, 카메라 설정 변경, 방해 요소(distractors)가 포함된 실세계(real-world) 테스트 환경에서, 제안된 방법은 종합 성공률 측면에서 베이스라인 모델 대비 유의미한 성능 향상을 입증했습니다 [Figure 6]. 또한 시각적 주의 집중(attention)이 분포 변화에도 불구하고 작업 관련 객체에 안정적으로 고정됨을 정성적으로 확인하였습니다 [Figure 4].
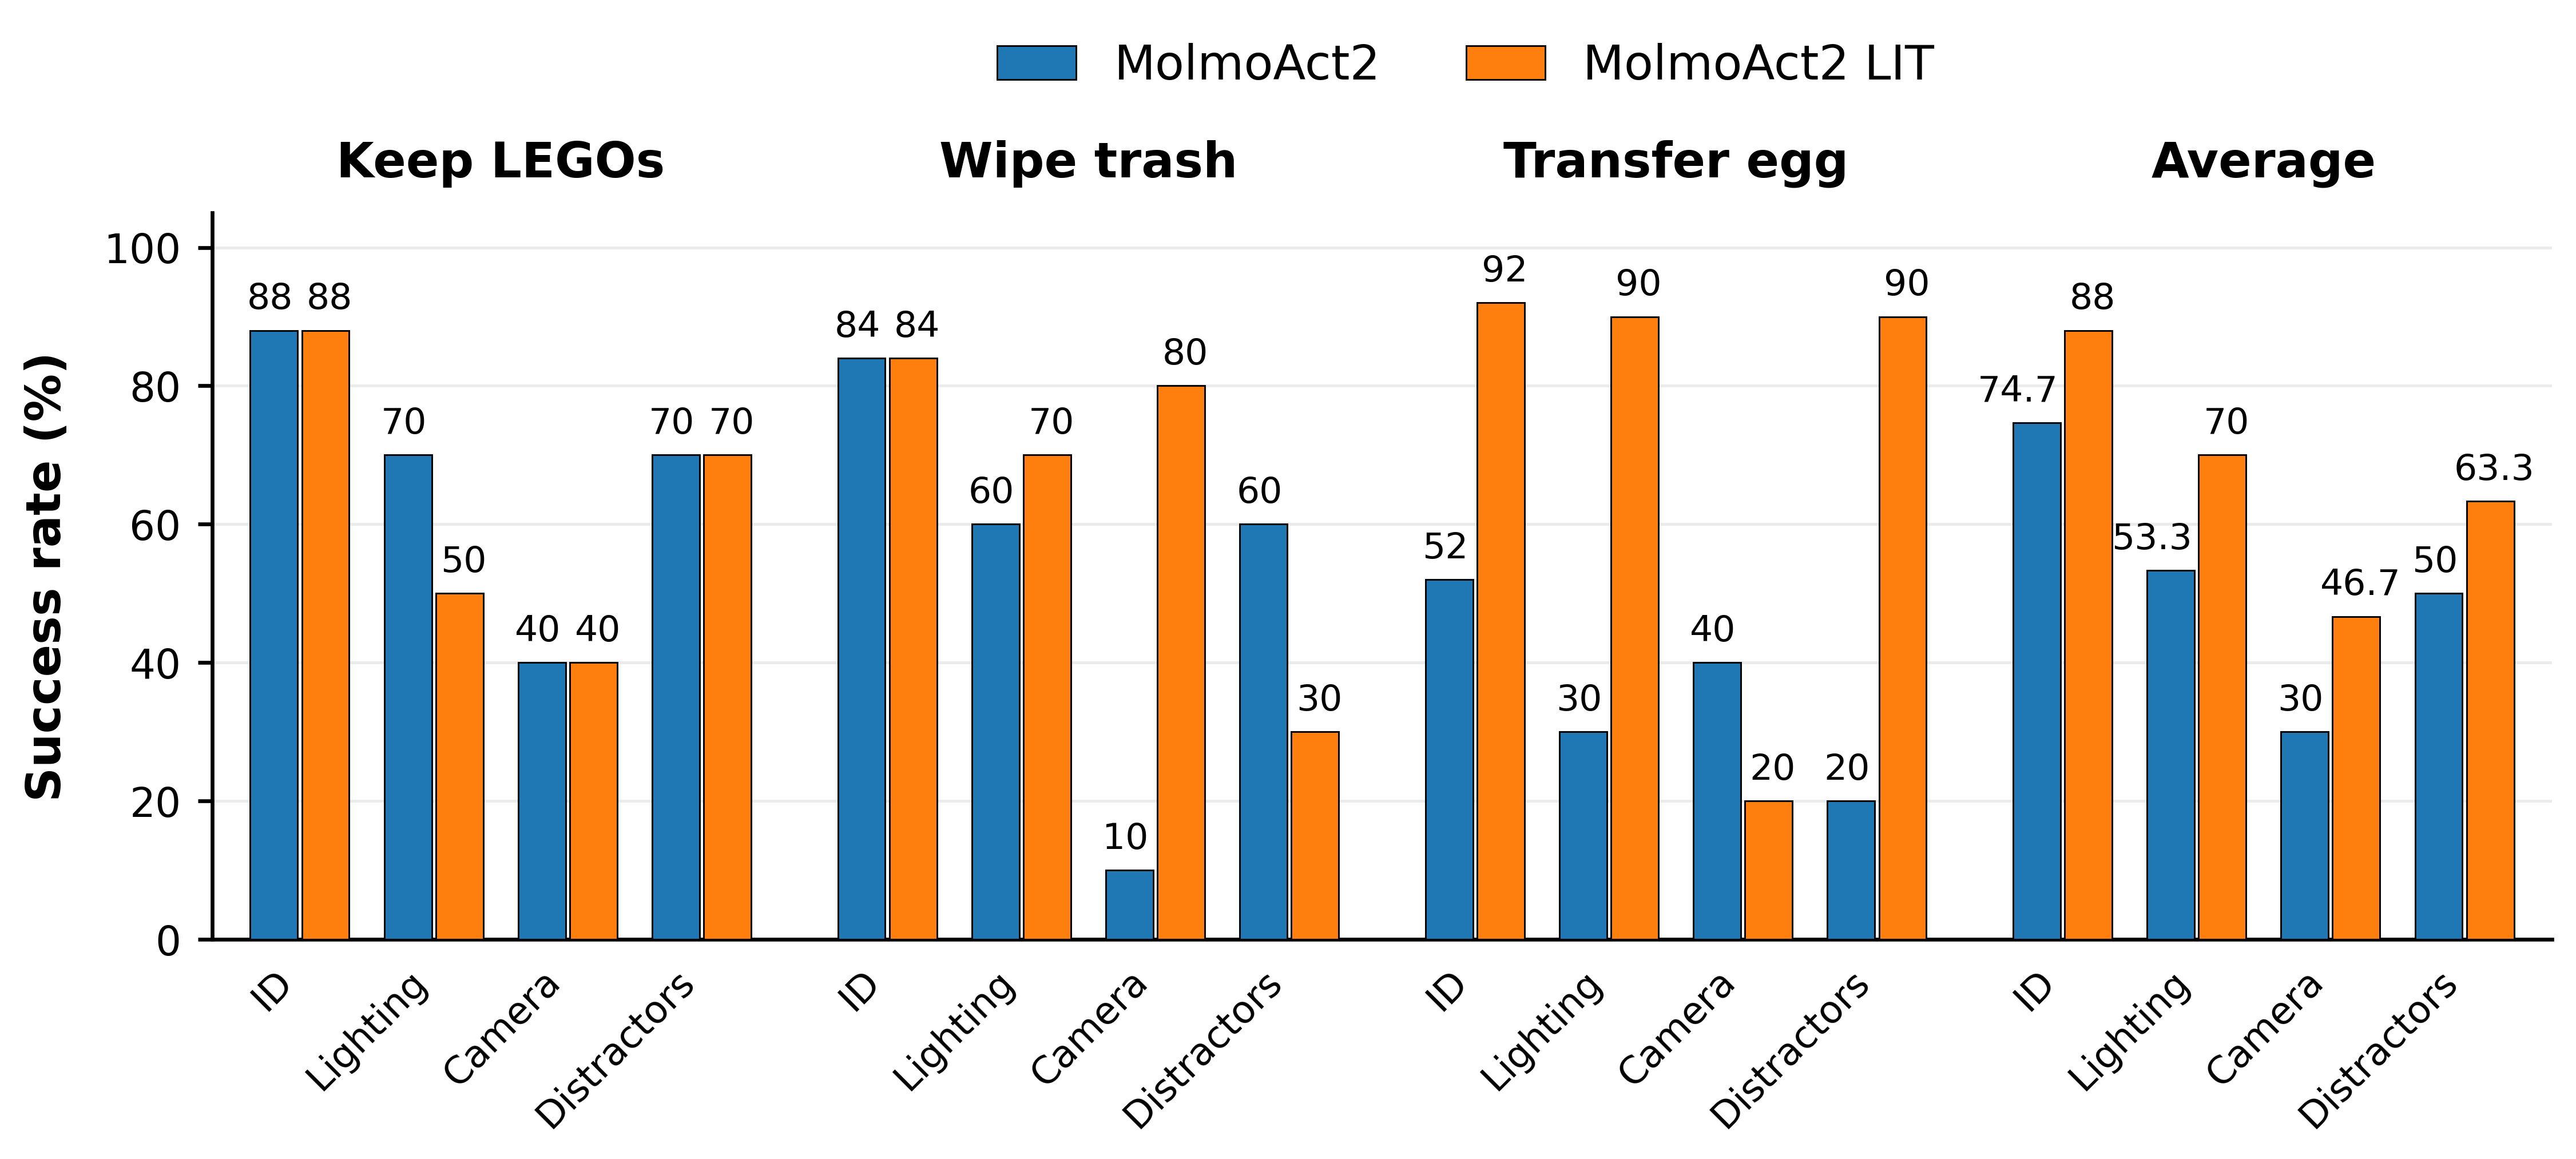
Figure 6 — 실제 로봇 작업 성공률 비교
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 시각적 입력과 동작 생성 사이의 연결 고리를 포즈 기반의 잠재 인터페이스로 구조화함으로써 로봇 파운데이션 모델의 일반화 성능을 획기적으로 개선했습니다. LIT는 프레임워크에 구애받지 않는(agnostic) 범용적인 학습 전략으로서, 복잡한 시각적 환경에서도 로봇이 본질적인 작업 목표에 집중하도록 돕습니다. 이 연구는 로봇 모델 학습 시 데이터의 시각적 상관관계에 의존하는 고질적인 문제를 해결하고, 실제 환경으로의 배포를 가로막는 신뢰성 문제를 완화하는 데 중요한 학술적, 기술적 가치를 지닙니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] PRM-as-a-Judge 1.5: A Toolkit for Robot Process Assessment
- [논문리뷰] Embodied.cpp: A Portable Inference Runtime of Embodied AI Models on Heterogeneous Robots
- [논문리뷰] RoboFollow: Unveiling the Instruction Following Mirage in Embodied Agents
- [논문리뷰] RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
- [논문리뷰] Grounded Action Model: 3D Grounding as a Foundation for Robotics
Review 의 다른글
- 이전글 [논문리뷰] Beyond Top-k Skill Retrieval: Diversity-Aware Skill Routing for LLM Agents
- 현재글 : [논문리뷰] Breaking the Vision-Action Shortcut: Latent Interface Training for Generalizable Robotics Foundation Models
- 다음글 [논문리뷰] Building and Evaluating Fixed-Voice Thai TTS from Synthetic Speech
댓글