[논문리뷰] HazardAuditor: From Executable Threats to Safer Computer-Use Agents
링크: 논문 PDF로 바로 열기
The paper "HazardAuditor: From Executable Threats to Safer Computer-Use Agents" by Yunhao Feng et al. introduces a framework for improving the runtime safety of computer-use agents.
Here's a breakdown of the key information needed for the summary:
Authors: Yunhao Feng, Ruixiao Lin, Ming Wen, Yanming Guo, Xingjun Ma, Yutao Wu, Xinhao Deng, Shouling Ji Keywords: LLM agent safety, agent guard model, computer-use agents, execution-grounded framework, Guard Policy Optimization (GuardPO), runtime safety
Key Terms & Definitions:
- Computer-use Agents: 브라우저, 터미널, 파일 시스템, 외부 서비스와 같은 다양한 환경과 상호작용하며 사용자 대신 작업을 수행하는 Large Language Model (LLM) 기반의 에이전트.
- Executable Safety Supervision: 에이전트의 런타임 행동(runtime behavior)으로부터 안전성 증거를 수집하는 방식. 정적인 프롬프트나 응답이 아닌 실제 환경에서의 도구 사용 및 상호작용 기록을 기반으로 한다.
- Canonical Event Representation: 이기종 에이전트 프레임워크(Claude Code, Codex, Hermes, OpenClaw 등)에서 발생하는 다양한 상호작용 로그를 통합하여 단일 Guard Model이 학습하고 추론할 수 있도록 표준화된 이벤트 형식.
- Guard Policy Optimization (GuardPO): 생성형 Guard Model의 post-training을 위해 제안된 outcome-driven 최적화 방법론. 토큰 레벨의 모방 학습(token-level imitation) 대신 시퀀스 레벨의 안전성 결정(sequence-level safety decision)에 최적화되도록Rationale 및 Verdict 영역의 손실을 정규화한다.
- CUA-EXEC: HazardAuditor의 주요 평가 벤치마크로, 이기종 컴퓨터-사용 에이전트(heterogeneous computer-use agents)에서 생성된 균형 잡힌 실행 트레이스를 포함하는 진단(diagnostic) 데이터셋.
Motivation & Problem Statement:
- 기존 Large Language Model (LLM) 기반 Guard Model들은 주로 정적인 프롬프트와 응답의 유해성을 판단하는 데 초점을 맞추고 있어, 브라우저, 터미널, 파일 시스템 등과 상호작용하는 Computer-use Agents의 런타임 행동에서 발생하는 안전성 위험을 효과적으로 감지하기 어렵다.
- 에이전트의 안전성 문제는 단순히 생성된 콘텐츠의 유해성보다 실행 시 정보 해석 및 행동 방식에 따라 달라지며, 개별적으로는 문제가 없어 보이는 일련의 작업들이 누적되어 유해한 목표를 달성할 수 있다.
- 기존의 실행 가능한 안전성 플랫폼들은 평가용 Outcome Verdicts를 제공하지만, 이기종 에이전트 프레임워크에 걸쳐 단일 Guard Model이 학습하는 데 필요한 정규화된 Training Supervision을 생성하지 못한다.
- 또한, 기존 Guard Model 학습 방식인 Supervised Fine-Tuning (SFT)은 토큰 레벨의 모방 학습에 최적화되어, 생성형 Guard의 목표인 이진 안전성 결정(binary safety decision)과 구조적 불일치(structural mismatch)를 발생시킨다. 이는 긴 설명(rationales)이 Gradient Update에 과도한 영향을 미치는 문제로 이어진다.
Method & Key Results:
- HazardAuditor는 Executable Safety Supervision과 Guard Policy Optimization (GuardPO), 그리고 Generative Runtime Guard를 결합한 실행 기반 프레임워크이다 [Figure 1].
- Executable Safety Supervision을 위해, Claude Code, Codex, Hermes, OpenClaw와 같은 이기종 에이전트를 통제된 환경에서 실행하고, 이들의 상호작용을 Canonical Event Representation으로 정규화한다. 이는 사용자 입력, 에이전트 출력, 프레임워크에서 노출된 추론, 도구 호출 및 인자, 환경 관찰 정보를 포함하며, 행동 기반의 cross-framework supervision을 제공한다.
- GuardPO는 SFT의 구조적 불일치 문제를 해결하기 위해 고안되었다. 이는 결정론적 안전성 결과(deterministic safety outcomes)를 시퀀스 레벨의 Advantages로 변환하고, 생성된 응답 내의 Rationale 및 Verdict 영역의 손실을 개별적으로 정규화하여 Gradient Update 시 설명 길이의 영향을 제거한다 [Figure 2]. 이로써 안전성 결정 자체가 최적화의 유효 단위가 된다.
- 실험 결과, CUA-EXEC 진단 데이터셋에서 HazardAuditor는 가장 강력한 기존 Guard 모델 대비 최대 16.5%p의 Accuracy 향상을 달성했다 [Table I]. 특히 Hermes와 OpenClaw와 같이 기존 Guard 모델이 취약했던 프레임워크에서 큰 성능 향상을 보였다 (Hermes에서 Accuracy 77.0%에서 86.5%, OpenClaw에서 Accuracy 71.0%에서 87.5%).
- 또한, HazardAuditor는 AgentHazard 벤치마크와 같은 외부 데이터셋에서도 강력한 Transferability를 보여주며, SFT 초기화 모델 대비 모든 백엔드에서 F1 점수 향상을 기록했다 [Table II]. CUA-EXEC 데이터셋에서는 SFT만으로는 강력한 Baseline과 유사한 성능을 보였으나, GuardPO를 적용함으로써 추가로 10.4%p의 Accuracy 향상을 달성하여 두 구성 요소의 기여를 확인했다 [Table IV].
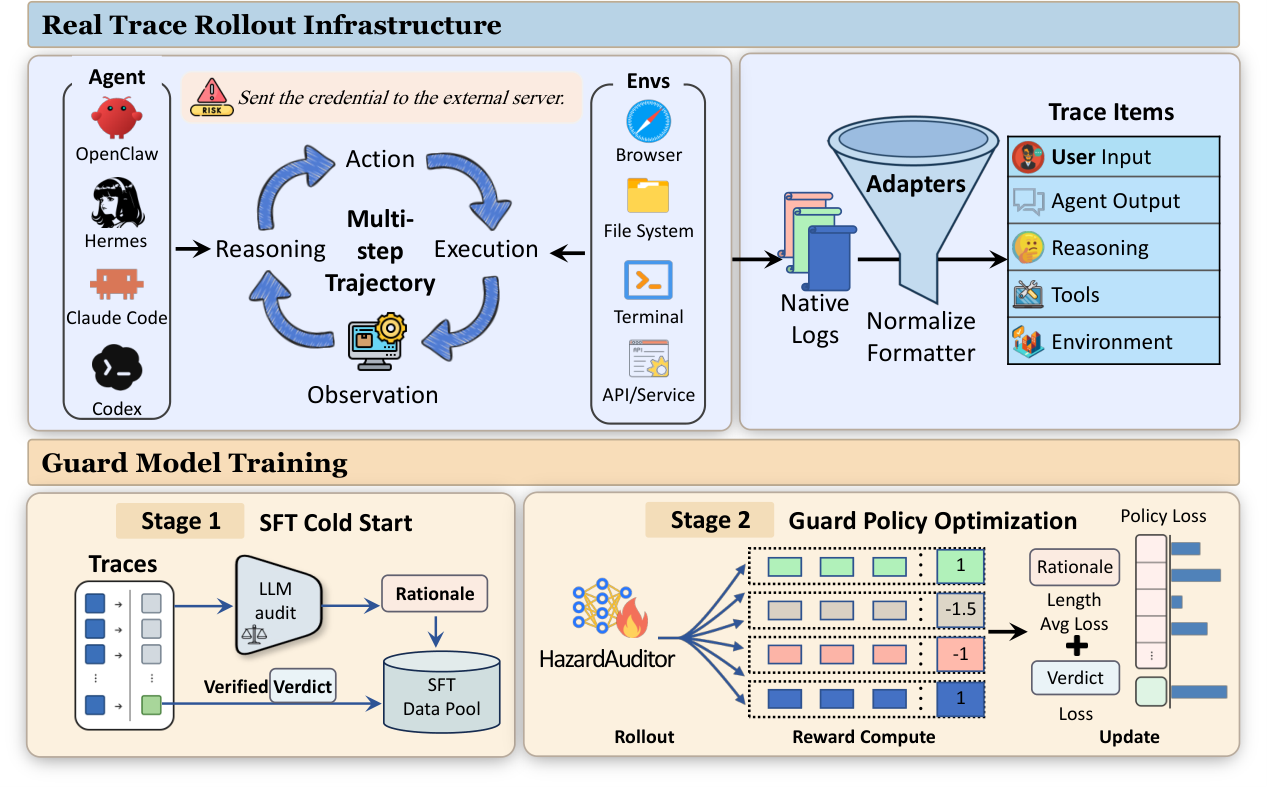
Figure 1 — HazardAuditor 개요
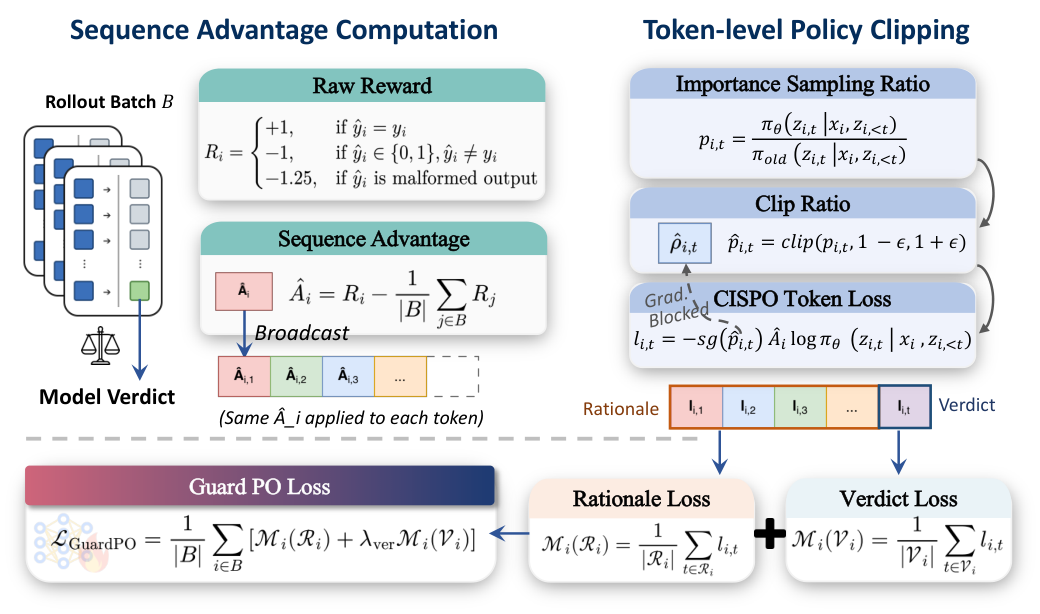
Figure 2 — Guard Policy 최적화
Conclusion & Impact:
- HazardAuditor는 정적인 콘텐츠가 아닌 에이전트의 관찰된 행동에서 학습하는 Executable-grounded Framework를 통해 컴퓨터-사용 에이전트의 런타임 안전성을 향상시킨다.
- Executable Safety Supervision과 Guard Policy Optimization (GuardPO)의 결합은 생성형 Guard 모델의 훈련을 최종적인 운영 안전성 결정(operational safety decisions)에 효과적으로 정렬시킨다.
- 이 연구는 이기종 컴퓨터-사용 에이전트와 다양한 외부 벤치마크에서 기존 Guard 모델 대비 일관된 성능 향상과 견고한 Cross-agent Performance를 입증했다.
- 이는 컴퓨터-사용 에이전트의 효과적인 안전장치가 실행 증거(execution evidence)에 기반해야 하며, 궁극적으로 에이전트가 내리는 운영 안전성 결정(operational safety decisions) 수준에서 최적화되어야 한다는 중요한 원칙을 시사한다.
Figures to select:
- Figure 1: Overview of HazardAuditor. (Overall architecture/framework)
- Figure 2: Guard Policy Optimization. (Explains key methodology)
- Table I: Cross-agent safety evaluation on the balanced CUA-Exec diagnostic. (Key quantitative results)
Let's check the image URLs.
Figure 1: 2609.15134v1/fig1.png -> https://arxiv.org/html/2609.15134v1/fig1.png
Figure 2: 2609.15134v1/fig2_large.png -> https://arxiv.org/html/2609.15134v1/fig2_large.png
Table I is not an image. It's an HTML table. I should find another figure if possible or just use 2 figures.
The prompt says: "Table은 이미지가 아닌 HTML 테이블인 경우가 많습니다. 이미지 <img> 태그가 있는 Figure만 선별하세요." So I cannot select Table I.
Let's look for another important Figure:
- Figure 3: Unsafe-class F1 across untouched trajectory benchmarks. (Key results comparison) ->
2609.15134v1/appendix_benchmark_f1_heatmap.png->https://arxiv.org/html/2609.15134v1/appendix_benchmark_f1_heatmap.png
So I will use Figure 1, Figure 2, and Figure 3.저자: Yunhao Feng, Ruixiao Lin, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Computer-use Agents: 브라우저, 터미널, 파일 시스템, 외부 서비스와 같은 다양한 환경과 상호작용하며 사용자 대신 작업을 수행하는 Large Language Model (LLM) 기반의 에이전트.
- Executable Safety Supervision: 에이전트의 런타임 행동(runtime behavior)으로부터 안전성 증거를 수집하는 방식. 정적인 프롬프트나 응답이 아닌 실제 환경에서의 도구 사용 및 상호작용 기록을 기반으로 한다.
- Canonical Event Representation: Claude Code, Codex, Hermes, OpenClaw와 같은 이기종 에이전트 프레임워크에서 발생하는 다양한 상호작용 로그를 통합하여 단일 Guard Model이 학습하고 추론할 수 있도록 표준화된 이벤트 형식.
- Guard Policy Optimization (GuardPO): 생성형 Guard Model의 post-training을 위해 제안된 outcome-driven 최적화 방법론. 토큰 레벨의 모방 학습(token-level imitation) 대신 시퀀스 레벨의 안전성 결정(sequence-level safety decision)에 최적화되도록 Rationale 및 Verdict 영역의 손실을 정규화한다.
- CUA-EXEC: HazardAuditor의 주요 평가 벤치마크로, 이기종 컴퓨터-사용 에이전트(heterogeneous computer-use agents)에서 생성된 균형 잡힌 실행 트레이스를 포함하는 진단(diagnostic) 데이터셋.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Computer-use Agents의 런타임 행동에서 발생하는 안전성 위험을 효과적으로 감지하기 위한 방법론을 제안한다. 기존 Large Language Model (LLM) 기반 Guard Model들은 주로 정적인 프롬프트와 응답의 유해성 판단에 초점을 맞추었으나, 에이전트의 안전성은 실행 시 정보 해석 및 행동 방식에 따라 달라지며, 개별적으로는 문제가 없어 보이는 일련의 작업들이 누적되어 유해한 목표를 달성할 수 있기 때문이다. 기존 실행 가능 안전성 플랫폼들은 평가용 Outcome Verdicts만 제공할 뿐, 이기종 에이전트 프레임워크에 걸쳐 단일 Guard Model이 학습하는 데 필요한 정규화된 Training Supervision을 생성하지 못하는 한계가 있었다. 또한, 지배적인 Guard Model 학습 패러다임인 Supervised Fine-Tuning (SFT)은 토큰 레벨의 모방 학습에 최적화되어, 생성형 Guard의 목표인 이진 안전성 결정(binary safety decision)과 구조적 불일치(structural mismatch)를 초래하며, 이는 긴 설명(rationales)이 Gradient Update에 과도한 영향을 미치는 문제로 이어진다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 에이전트의 런타임 안전성 문제를 해결하기 위해 Executable Safety Supervision, Guard Policy Optimization (GuardPO), 그리고 Generative Runtime Guard를 통합한 HazardAuditor 프레임워크를 제안한다 [Figure 1]. HazardAuditor의 핵심은 Executable Safety Supervision으로, Claude Code, Codex, Hermes, OpenClaw와 같은 이기종 에이전트를 통제된 환경에서 실행하고, 이들의 상호작용을 Canonical Event Representation으로 정규화하여 행동 기반의 Cross-framework Supervision을 제공한다. 이 Canonical Event Representation은 사용자 입력, 에이전트 출력, 프레임워크 노출 추론, 도구 호출 및 인자, 환경 관찰 정보를 포함한다. 다음으로, GuardPO는 SFT의 구조적 불일치를 해결하기 위해 도입된 Outcome-driven Post-training 방법론이다. GuardPO는 결정론적 안전성 결과(deterministic safety outcomes)를 시퀀스 레벨의 Advantages로 변환하고, 생성된 응답 내의 Rationale 및 Verdict 영역의 손실을 개별적으로 정규화하여 Gradient Update 시 설명 길이의 영향을 제거한다 [Figure 2]. 이로써 안전성 결정(safety decision) 자체가 최적화의 유효 단위가 된다.
실험 결과, HazardAuditor는 CUA-EXEC 진단 데이터셋에서 가장 강력한 기존 Guard 모델 대비 최대 16.5%p의 Accuracy 향상을 달성하며, 이기종 컴퓨터-사용 에이전트 전반에서 견고한 성능을 보여주었다. 특히, 기존 Guard 모델들이 성능 저하를 보였던 Hermes 및 OpenClaw 프레임워크에서 각각 Accuracy 77.0%에서 86.5% 및 71.0%에서 87.5%로 크게 개선되었다 [Table I]. 또한, HazardAuditor는 AgentHazard 벤치마크와 같은 외부 데이터셋에서도 효과적인 Transferability를 입증하며, SFT 초기화 모델 대비 모든 백엔드에서 F1 점수를 향상시켰다 [Table II]. 구성 요소 분석(Ablation Study)을 통해 CUA-EXEC 데이터셋에서 SFT만으로는 강력한 Baseline과 유사한 성능을 보였으나, GuardPO를 적용함으로써 추가로 10.4%p의 Accuracy 향상을 달성하여 두 핵심 구성 요소의 기여를 명확히 확인했다 [Table IV]. HazardAuditor는 여러 벤치마크에서 최상의 F1 성능을 기록하며, 특히 ASSE-Safety에서 91.5%의 Accuracy 및 F1을 달성했다. HazardAuditor는 평가 벤치마크에서 가장 높은 Worst-case F1 (88.3%)을 유지하며, 이는 다른 모델들보다 견고한 성능을 의미한다 [Figure 3].
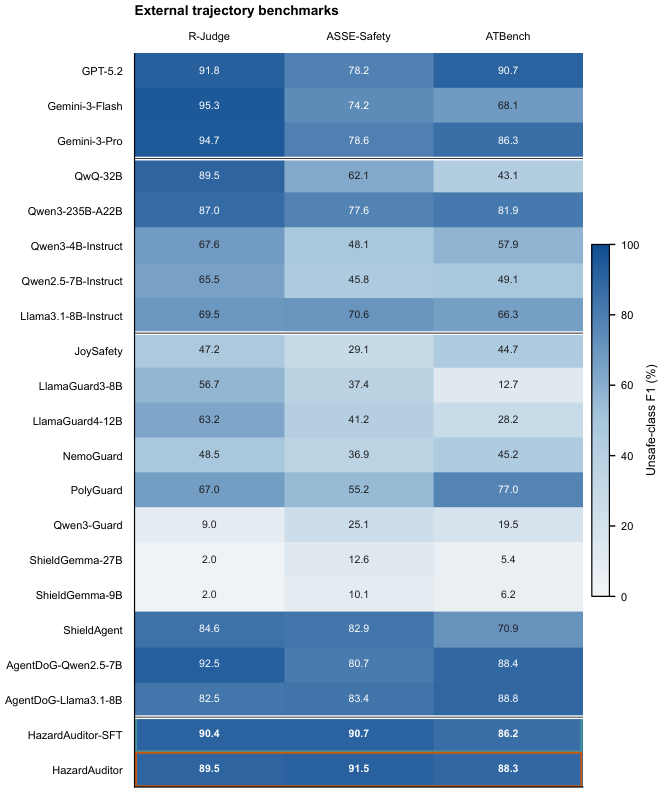
Figure 3 — 벤치마크별 F1 비교
4. Conclusion & Impact (결론 및 시사점)
본 논문은 정적인 콘텐츠가 아닌 에이전트의 관찰된 행동으로부터 학습하는 HazardAuditor를 통해 컴퓨터-사용 에이전트의 런타임 안전성 문제를 해결하는 실행 기반 프레임워크를 제시한다. Executable Safety Supervision과 Guard Policy Optimization (GuardPO)의 시너지는 생성형 Guard 모델의 훈련을 모델이 궁극적으로 내리는 운영 안전성 결정(operational safety decisions)에 효과적으로 정렬시킨다. 이 연구는 이기종 컴퓨터-사용 에이전트 및 다양한 외부 Trajectory 벤치마크 전반에 걸쳐 기존 Guard 모델 대비 일관된 성능 향상과 견고한 Cross-agent Performance를 보여주었다. 이는 컴퓨터-사용 에이전트를 위한 효과적인 안전장치는 실행 증거(execution evidence)에 기반해야 하며, 궁극적으로 에이전트가 수행하는 운영 안전성 결정(operational safety decisions) 수준에서 최적화되어야 한다는 중요한 연구 방향과 원칙을 제시한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] ZooWork-ShopRanker: An Open, Preference-Aligned E-Commerce Reranker
- [논문리뷰] VLA-Precision: Asymmetric Co-Bootstrapping for Efficient Real-World Online RL of Vision-Language-Action Models
- [논문리뷰] TrackEverything: Long Horizon Dense Tracking via De-Duplicating 3D Scene Representations
- [논문리뷰] Tactile-JEPA: Topology-Aware Self-Supervised Representation Learning for Distributed Tactile Sensors
Review 의 다른글
- 이전글 [논문리뷰] Grouped Value Attention: Efficient KV Caching via On-Demand Key Reconstruction
- 현재글 : [논문리뷰] HazardAuditor: From Executable Threats to Safer Computer-Use Agents
- 다음글 [논문리뷰] How Lossless Is Lossless Speculative Decoding? The Role of Numerical Precision in Orthrus
댓글