[논문리뷰] Assessing nnU-Net Generalization across Brain Tumor Populations in BraTS-GoAT 2026
링크: 논문 PDF로 바로 열기
메타데이터
저자: Tristan Kirscher, Vivian Metzger, Philippe Meyer, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- nnU-Net: 별도의 수동 튜닝 없이 데이터셋의 특성에 맞게 구성을 자동으로 최적화하는 딥러닝 기반 생의학 이미지 세그멘테이션 프레임워크입니다.
- BraTS-GoAT: 다양한 인구 집단(성인 신경교종, 수막종, 뇌 전이, 소아 뇌종양 등)에 걸쳐 모델의 일반화 성능을 평가하는 벤치마크 태스크입니다.
- DSC (Dice Similarity Coefficient): 예측된 세그멘테이션과 실제 라벨 간의 중첩도를 측정하는 지표로, 수치가 1에 가까울수록 성능이 우수함을 의미합니다.
- NSD (Normalized Surface Dice): 세그멘테이션 경계의 정확도를 정량화하는 지표로, 모델의 형태학적 정밀도를 평가하는 데 사용됩니다.
- TTA (Test-Time Augmentation): 추론 단계에서 입력 데이터를 변형(본 논문에서는 Mirroring 사용)하여 여러 예측 결과를 생성하고 이를 평균화하여 모델의 예측 안정성을 높이는 기법입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 고도로 최적화된 nnU-Net이 인구학적 특성이 크게 다른 다양한 뇌종양 데이터셋 환경에서 얼마나 효과적으로 일반화되는지 분석하는 것을 목적으로 합니다. 기존의 BraTS 챌린지가 단일 또는 유사한 데이터 분포를 다루었다면, BraTS-GoAT는 종양의 크기, 다중성, 외형 및 촬영 프로토콜이 상이한 여러 코호트를 포함하여 모델 강건성에 대한 새로운 도전 과제를 제시합니다. 특히, 고정된 nnU-Net 프로토콜을 사용했을 때 발생할 수 있는 잠재적 성능 하락과 그 원인을 OOF (Out-of-Fold) 분석을 통해 규명할 필요가 있습니다. [Figure 1]에서 확인할 수 있듯, 훈련 데이터와 검증 데이터 간의 분포 차이가 모델의 성능 예측에 미치는 영향을 체계적으로 검증하는 것이 필수적입니다.
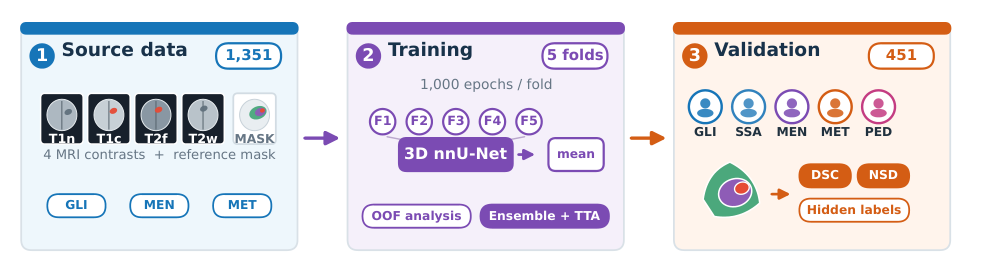
Figure 1 — 연구의 전체 흐름과 데이터 처리 과정을 나타내는 핵심 다이어그램
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 1,351개의 레이블링된 케이스를 사용하여 3D nnU-Net을 5-fold 교차 검증 방식으로 훈련하고, 별도의 하이퍼파라미터 튜닝 없이 test-time mirroring 및 모델 앙상블 전략을 적용했습니다. 실험 결과, 공식 검증 데이터셋에서 ET (Enhancing Tumor), TC (Tumor Core), WT (Whole Tumor)에 대한 DSC는 각각 0.7805, 0.8288, 0.8854를 기록하였습니다. [Table 1]에 따르면, TTA 적용 시 fold-0 단일 모델 대비 DSC 및 NSD가 유의미하게 향상되었으나, 5-fold 앙상블은 명확한 추가 개선 효과를 보여주지 못했습니다. 또한, Residual-L 아키텍처와의 비교에서도 성능의 우위는 나타나지 않았으며, OOF 실패 분석 결과 ET의 크기가 작고 다수의 불연속적인 컴포넌트로 구성될수록 모델의 세그멘테이션 성능이 크게 저하됨을 확인했습니다.
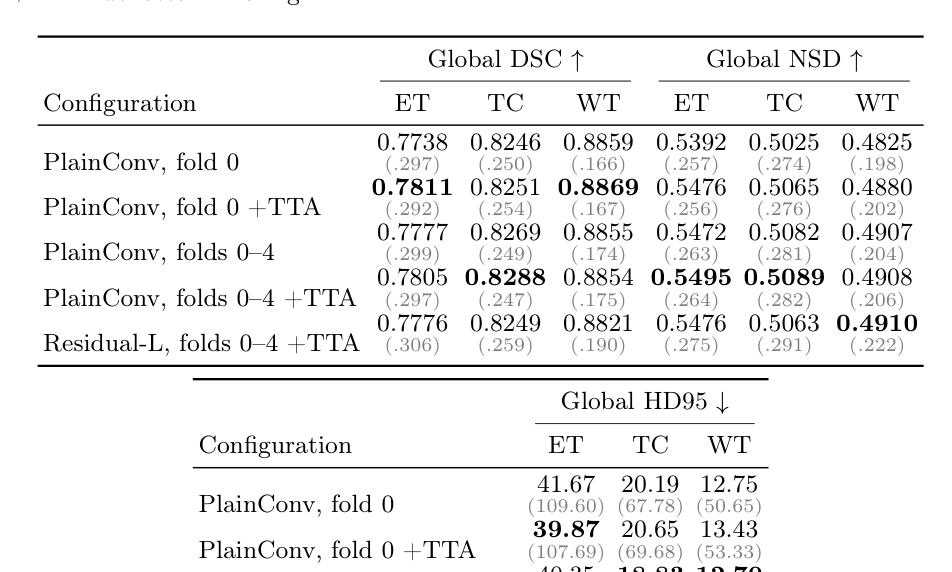
Table 1 — 각 모델 설정 및 기법에 따른 성능 지표를 상세히 비교한 결과 테이블
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 nnU-Net이 일반화 과정에서 특히 소형 및 파편화된 종양 영역에서 성능 제약을 겪으며, 추가적인 아키텍처 수정보다는 데이터 분포의 특수성이 성능에 더 큰 영향을 미친다는 점을 시사합니다. 연구를 통해 도출된 OOF 실패 원인 분석은 향후 일반화 성능을 향상시키기 위한 세그멘테이션 전략 수립의 가이드라인을 제공합니다. 이는 실제 임상 환경에서 다양한 프로토콜로 촬영된 환자 데이터에 딥러닝 모델을 적용할 때, 모델의 한계를 사전에 인지하고 대응 전략을 마련하는 데 중요한 학술적 근거가 될 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RoboFollow: Unveiling the Instruction Following Mirage in Embodied Agents
- [논문리뷰] RRSI: Regularized Recursive Self-Improvement of Agent Harnesses
- [논문리뷰] Grounded Action Model: 3D Grounding as a Foundation for Robotics
- [논문리뷰] Breaking the Vision-Action Shortcut: Latent Interface Training for Generalizable Robotics Foundation Models
- [논문리뷰] Harnessing CLIP and DINO: An Uncertainty-Aware Cascaded Fusion Network for Generalizable Deepfake Image Detection
Review 의 다른글
- 이전글 [논문리뷰] Agora: Git as Shared Memory for Collective AutoResearch
- 현재글 : [논문리뷰] Assessing nnU-Net Generalization across Brain Tumor Populations in BraTS-GoAT 2026
- 다음글 [논문리뷰] CERA-MoA: Co-Evolving Routing Mechanisms with Continually Learning LLM Agents
댓글