[논문리뷰] Beyond the Timeline: Augmenting Long-Video Memory with Grounded Entity Biographies
링크: 논문 PDF로 바로 열기
메타데이터
저자: Hui Ren, Lei Fan, Henry Pao, Han Guo, Zeeshan Zia, Ying Chen, Alexander Schwing, Gang Hua
1. Key Terms & Definitions (핵심 용어 및 정의)
- Grounded Entity Biographies (GEB): 시간적으로 분산된 동일한 물리적 객체(Physical Instance)의 관측치를 시각적으로 근거하여 연결하고, 각 순간의 문맥을 보존하는 장기 비디오 메모리 프레임워크입니다.
- Entity Correspondence: 서로 다른 시간대와 클립에서 나타나는 객체 관측치가 동일한 실제 물리적 대상에 해당하는지를 판단하는 과정입니다.
- Episodic Evidence: 특정 사건 발생 당시의 상황, 주변 환경, 관련 활동 등을 포함한 문맥적 정보로, GEB에서는 이를 biography와 연결하여 기억을 재구성합니다.
- Retrieval Controller: 사용자 질문을 해석하고, 메모리 그래프에서 적절한 biography와 episodic evidence를 탐색하여 answer model에 전달하는 구성 요소입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 장기 비디오 메모리에서 시간 흐름에 따른 사건 중심의 기록만으로는 동일 객체의 생애 주기(Biography)를 재구성하는 데 한계가 있다는 문제를 해결합니다. 기존의 chronological description이나 언어 기반의 entity 연결 방식은 서로 다른 객체를 동일한 것으로 간주하거나, 하나의 객체를 여러 이름으로 분리하는 식의 오류를 범하기 쉽습니다. 결과적으로 특정 객체와 관련된 질문을 받았을 때, 전체 타임라인에서 관련 사건을 완벽하게 추적하기 어렵다는 근본적인 문제가 발생합니다. 저자들은 단순한 사건 기록을 넘어, 객체의 물리적 일관성을 확보하여 검색과 추론의 정확도를 높이는 새로운 접근 방식이 필요하다고 지적합니다 [Figure 1].
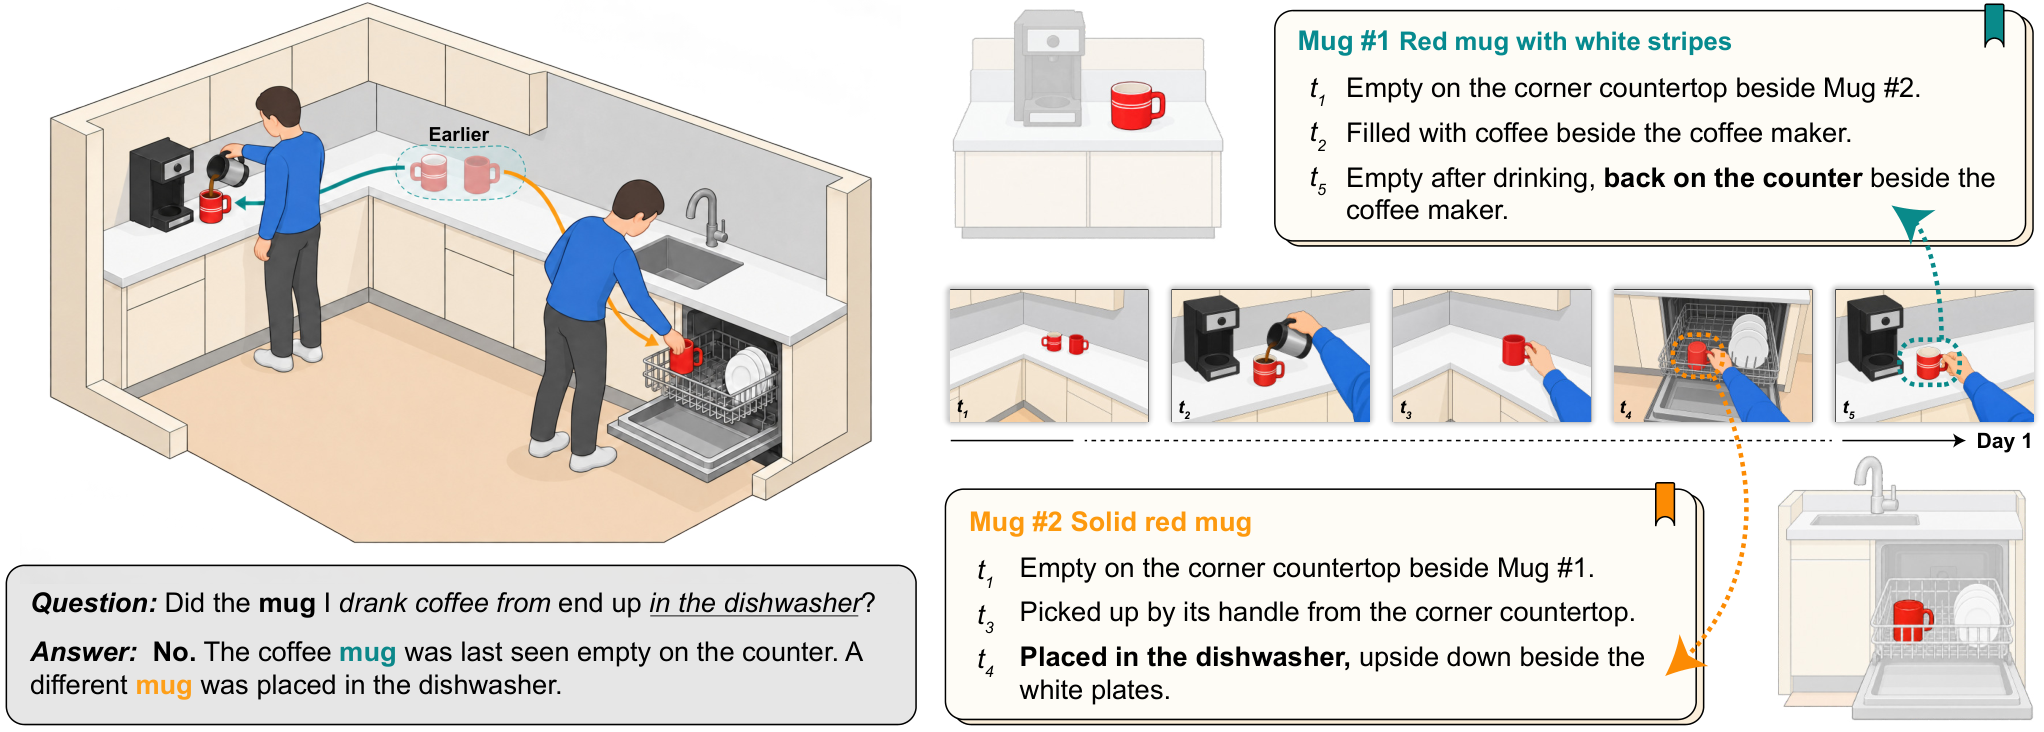
Figure 1 — 사건 중심과 객체 중심 메모리의 차이
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Grounded Entity Biographies (GEB) 프레임워크를 제안하여 시각적으로 근거가 있는 관측치들을 물리적 인스턴스 단위로 그룹화하고, 이들을 episodic memory와 연결합니다 [Figure 2]. 각 관측치는 시각적 정보와 문맥을 보존하며, 동일한 물리적 인스턴스라는 확신이 들 때만 연관 edge를 생성하는 보수적인 association 전략을 취합니다. 질문 수행 시, 검색 컨트롤러는 이 인스턴스 연결을 따라 관련 사건들을 효과적으로 순회하며, 연관된 biography excerpt를 answer model에 제공하여 추론을 돕습니다 [Figure 2].
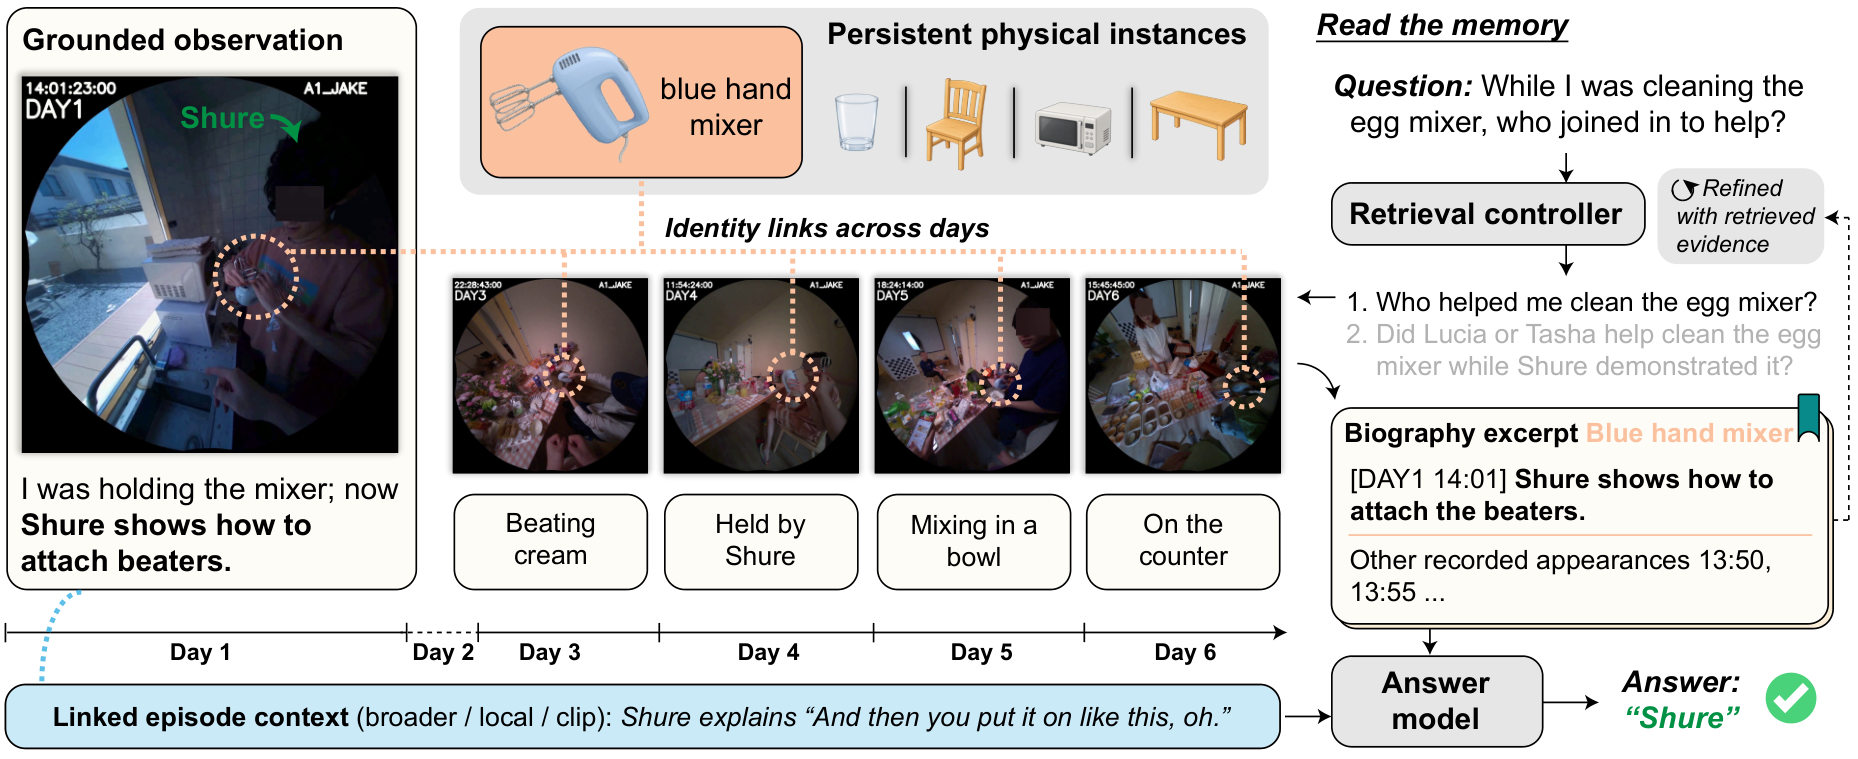
Figure 2 — GEB 프레임워크 전체 아키텍처
실험 결과, EgoLifeQA 벤치마크에서 72.0%의 정확도를 기록하며, 이전 최고 수준인 MAGIC-Video(67.6%) 대비 4.4%p 향상된 성능을 달성했습니다. 또한, MultiHop-EgoQA에서 증거 커버리지(Evidence Coverage)가 52.1%로 기존 대비 47%의 상대적 향상을 보였으며, 이는 복잡한 다중 사건 질문에 대해 증거를 확보하는 능력이 월등함을 입증합니다 [Table 1], [Table 3]. 아블레이션 연구를 통해 물리적 인스턴스 기반의 association과 biography text 독해가 모두 성능 향상에 필수적인 요소임을 정량적으로 확인하였습니다 [Table 4].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 장기 비디오 메모리에 물리적 객체의 생애 주기라는 개념을 도입함으로써, 기존의 사건 나열 방식이 가진 기억의 단절 문제를 성공적으로 해결하였습니다. GEB는 단순한 검색을 넘어 객체 중심의 문맥 파악이 가능하게 하여, 복잡한 비디오 질의응답 및 에이전트 시스템의 추론 능력을 비약적으로 향상시켰습니다. 본 논문의 방법론은 향후 장기 기억 기반의 로봇 공학이나 대규모 비디오 분석 시스템에서 개체 지속성(Object Persistence)을 다루는 핵심 아키텍처로 활용될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Seeing, Listening, Remembering, and Reasoning: A Multimodal Agent with Long-Term Memory
- [논문리뷰] ReflectWorld-MM: An Entity-Oriented Multimodal Memory System for Open-Ended Video Streams
- [논문리뷰] MementoGUI: Learning Agentic Multimodal Memory Control for Long-Horizon GUI Agents
- [논문리뷰] Memory-Augmented Vision-Language Agents for Persistent and Semantically Consistent Object Captioning
- [논문리뷰] VideoDetective: Clue Hunting via both Extrinsic Query and Intrinsic Relevance for Long Video Understanding
Review 의 다른글
- 이전글 [논문리뷰] Beyond Dyadic Memory: Interaction-Aware Multimodal Memory with Adaptive Agentic Retrieval for Multi-Party Spoken Conversations
- 현재글 : [논문리뷰] Beyond the Timeline: Augmenting Long-Video Memory with Grounded Entity Biographies
- 다음글 [논문리뷰] Chinese-Jev: Bringing System One Model to Chinese-Language Tasks
댓글