[논문리뷰] Systematically Exploring the Capabilities of GPT-6 Astra as Embodied Policies
링크: 논문 PDF로 바로 열기
저자: Galbot Team, Xuchuan Cheng, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- GPT-6 Astra: 본 논문에서 Embodied Policy로서의 성능을 평가받는 거대 언어 모델 기반의 추론 에이전트입니다.
- Direct Control: 외부 정책의 도움 없이 GPT-6 Astra가 직접 로봇 제어 명령을 생성하는 제어 방식입니다.
- Hybrid Control: GPT-6 Astra가 기존의 학습된 태스크 정책(Learned Task Policy)이나 전신 제어기(Whole-Body Controller)의 출력을 보정하거나 선택하는 협력적 제어 방식입니다.
- Inference Latency: 모델이 다음 동작을 추론하는 데 소요되는 시간으로, 실제 로봇 시스템의 실시간 제어 성능을 제한하는 핵심 요소입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 GPT-6 Astra가 고수준의 계획 수립을 넘어 실제 물리적 로봇 제어(Embodied Control)에서 어느 정도의 범용성을 갖는지 체계적으로 평가하고자 합니다. 기존 Vision-Language-Action(VLA) 모델들이 특정 태스크에서는 성과를 보였으나, 다양한 도메인에 걸친 물리적 정밀 제어와 상황 적응성에서 드러나는 한계점을 분석하는 것이 핵심입니다. 특히 태스크 성공 여부뿐만 아니라, 제어 인터페이스의 분할과 추론 자원 소모가 전체 시스템 성능에 미치는 영향을 규명하고자 합니다. 본 논문은 [Table 1]에서 정의한 6개 도메인을 통해 Astra의 능력 범위를 실험적으로 확인합니다.
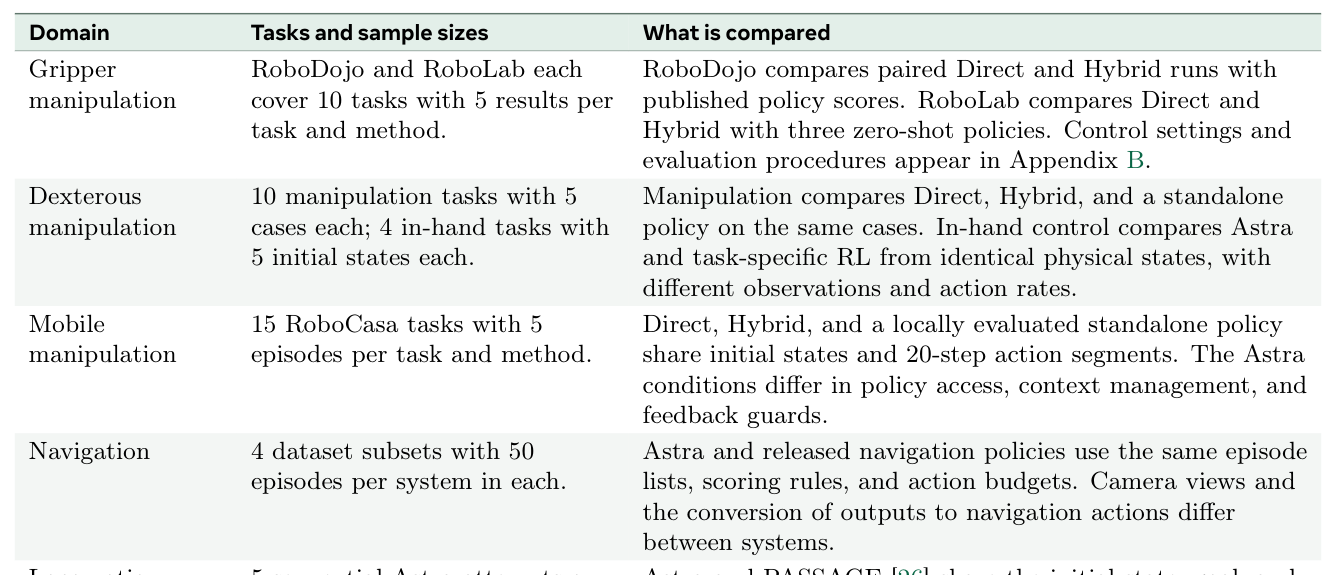
Table 1 — 연구의 도메인별 평가 범위와 비교 조건
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 Direct와 Hybrid 제어 경로를 통해 Astra의 Embodied Policy로서의 잠재력을 [Figure 1]과 같이 체계적으로 비교·검증합니다. 실험 결과, Astra는 RoboDojo와 같은 장기 호라이즌 Manipulation 태스크에서 Hybrid 방식을 통해 48%의 성공률을 달성하며 기존 방식 대비 우수한 성능을 보였으나, 개별 도메인별로는 성과가 불균일했습니다. 특히 [Figure 2]에 따르면 Hybrid 제어에서 전체 제어 스텝의 약 85.6%는 기존 정책이 수행하고 14.4%만이 Astra의 개입으로 이루어짐을 확인했습니다. Navigation 도메인에서는 별도의 고수준 지도 데이터 없이 92%의 성공률을 기록하여 뛰어난 공간 이해력을 입증했습니다. 반면, [Table 3]과 [Table 4]에서 알 수 있듯 고도의 정밀함이 요구되는 Dexterous Manipulation이나 Locomotion에서는 직접적인 제어만으로는 신뢰할 만한 안정성을 확보하기 어렵다는 점이 드러났습니다. 또한 추론 지연 시간(Latency)은 Locomotion 실행 시 물리 엔진을 일시 정지해야 할 정도로 커서, 실제 배포를 위한 고효율 최적화가 필수적임을 [Table 13]을 통해 분석했습니다.
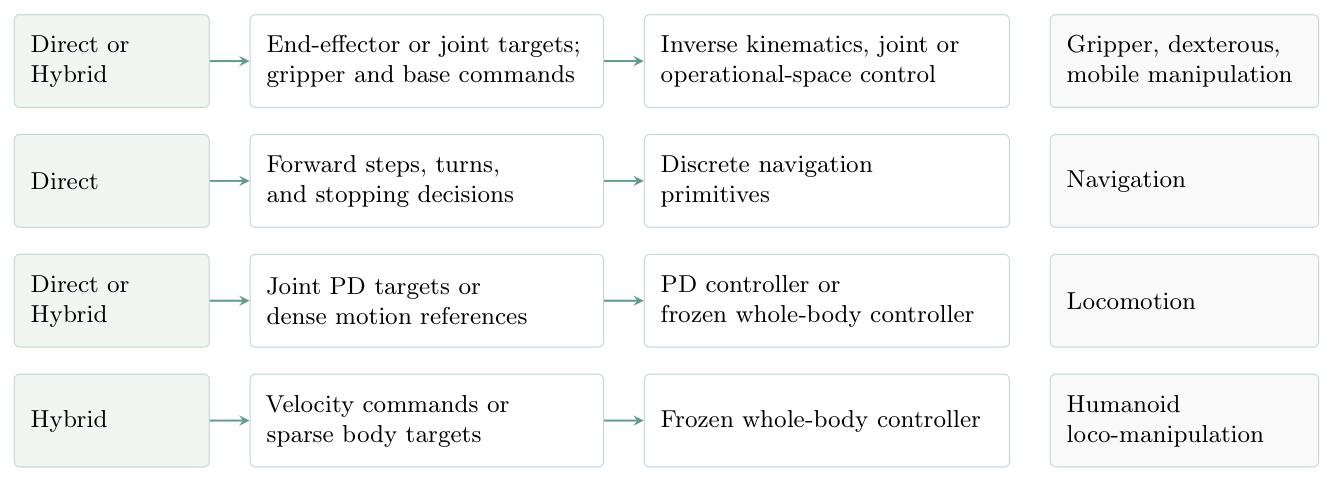
Figure 1 — Astra의 제어 방식을 정의하는 아키텍처 다이어그램
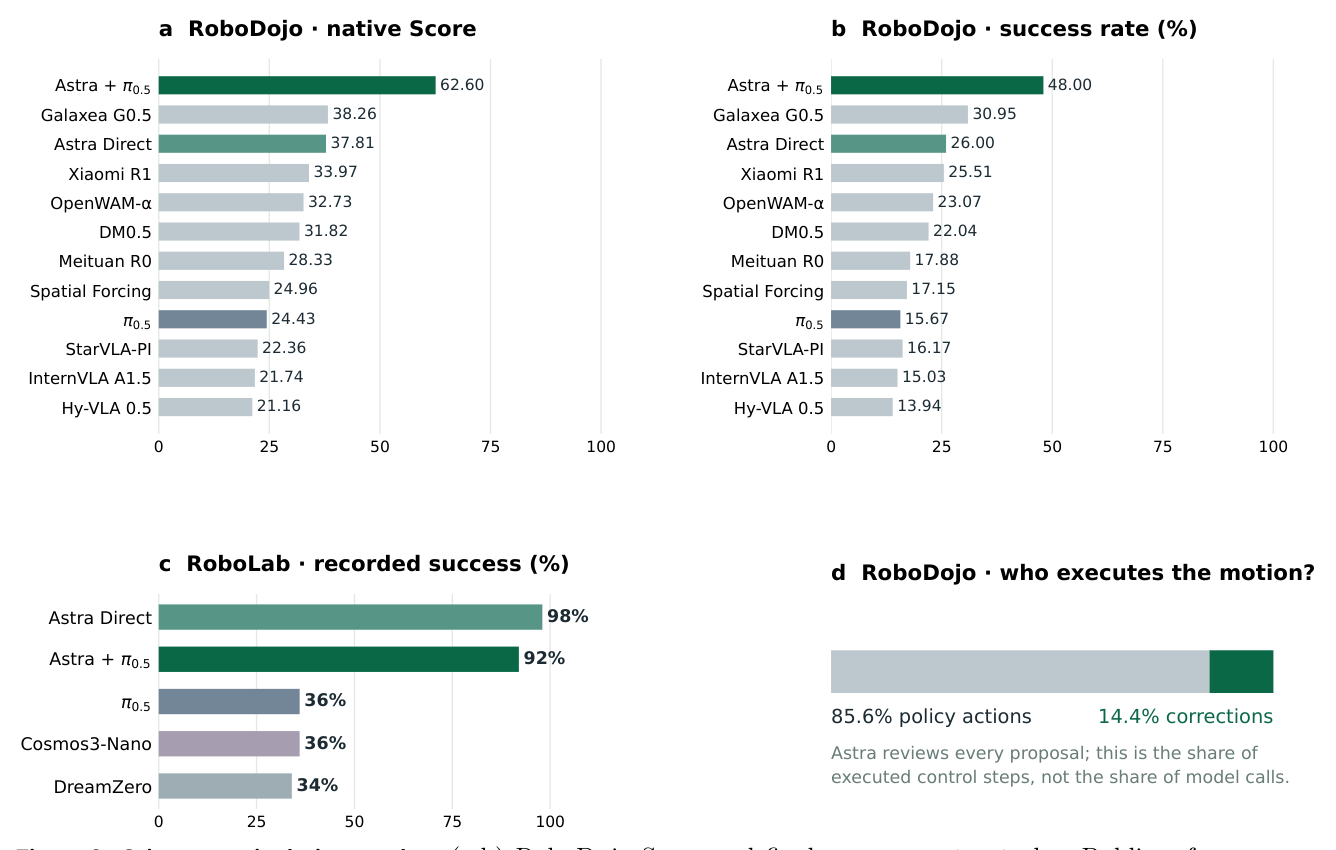
Figure 2 — Manipulaton 태스크에서의 핵심 성능 지표 비교
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 GPT-6 Astra가 Embodied Policy로서 복잡한 태스크를 이해하고 보정하는 강력한 능력을 갖추었으나, 물리적 정밀 제어와 실시간성 면에서는 여전히 한계가 있음을 결론짓습니다. Learned Policy와 결합한 Hybrid 전략이 범용 에이전트의 실질적인 구현을 위한 유효한 대안임을 보여주었으며, 이는 향후 로봇 에이전트 설계 시 추론형 모델과 전통적 제어기 간의 역할 분담이 핵심임을 시사합니다. 본 연구는 다양한 Embodied Task에서 언어 모델 기반 제어의 성능 경계치를 명확히 함으로써, 향후 자율 로봇 에이전트 발전을 위한 중요한 벤치마크 데이터를 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] UNITAS: A 3D-Native World Action Model for Embodied Manipulation
- [논문리뷰] VABench: Measuring Embodied Spatial Intelligence through Visual Demonstrations, Active Perception, and Metric Control
- [논문리뷰] Show-Harness: Just a VLM Agent Can Play Robots
- [논문리뷰] EVA-Client: A Unified Data Collection, Inference, and Deployment Framework for Embodied Policies on Real Robots
- [논문리뷰] ImageWAM: Do World Action Models Really Need Video Generation, or Just Image Editing?
Review 의 다른글
- 이전글 [논문리뷰] Synthetic Pre-pretraining Survives Scale, but Not as a Grammatical Prior
- 현재글 : [논문리뷰] Systematically Exploring the Capabilities of GPT-6 Astra as Embodied Policies
- 다음글 [논문리뷰] TERRA: Terrain-Aware Reconstruction, Retargeting and Control for Musculoskeletal Locomotion
댓글