[논문리뷰] ThinkV2V: Unleashing the Reasoning Capability of MLLMs for Instruction-Guided Video Editing
링크: 논문 PDF로 바로 열기
Part 1: 요약 본문
저자: Donghao Zhou, Haoyang He, Fan Zhang, Hao Yang, Guisheng Liu, Xin Gao, Zhongwei Wan, Xingyuan Bu, Jie Wang, Qiangpeng Yang, Shilei Wen, Chi-Wing Fu, Pheng-Ann Heng
1. Key Terms & Definitions (핵심 용어 및 정의)
- MLLMs (Multimodal Large Language Models): 비디오와 텍스트를 입력받아 Chain-of-Thought(CoT) 기반의 추론을 수행하고, 이를 바탕으로 비디오 편집을 위한 정교한 프롬프트 및 의미론적 특징을 생성하는 핵심 두뇌.
- DiT (Diffusion Transformer): Wan-2.1-5B를 백본으로 활용하여, MLLM으로부터 전달받은 고수준 편집 의도(Conditioning signals)와 원본 비디오 정보를 결합해 최종 편집된 비디오를 생성하는 실행 모듈.
- Learnable-Query Connector: MLLM의 가변적인 hidden states를 고정된 길이의 특징 시퀀스로 압축하여 DiT가 안정적으로 소비할 수 있도록 매핑하는 브리지 구조.
- Progressive Curriculum Training: 기본적인 편집 능력 학습부터 복잡한 추론 중심의 편집까지 단계적으로 학습 범위를 확장하여, 모델이 추론 기반 편집을 효율적으로 습득하도록 돕는 3단계 학습 기법.
- Inference-Time Thinking Scaling: 테스트 시점에 여러 개의 후보 프롬프트를 생성하고, 최적의 후보를 선정(Selection)하여 편집 결과의 정교함을 극대화하는 추론 단계의 후처리 기법.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 instruction-guided video editing 방식이 MLLM을 단순한 semantic encoder로만 사용하여, 사용자의 암묵적 의도(implicit intent)나 인과적 추론(causal reasoning)이 필요한 복잡한 편집 요청을 수행하는 데 한계가 있다는 점을 지적한다. 기존의 "black-box" 파이프라인은 표면적인 키워드에는 반응하지만, 시간적 역학 관계나 객체 간의 인과성을 이해해야 하는 고차원적 편집 상황에서는 성능이 저하된다 [Figure 1]. 이러한 문제 해결을 위해 저자들은 단순한 생성을 넘어, 비디오 편집 전에 명시적인 생각(Explicit thinking) 과정을 거치는 reasoning-driven 프레임워크인 ThinkV2V를 제안한다.
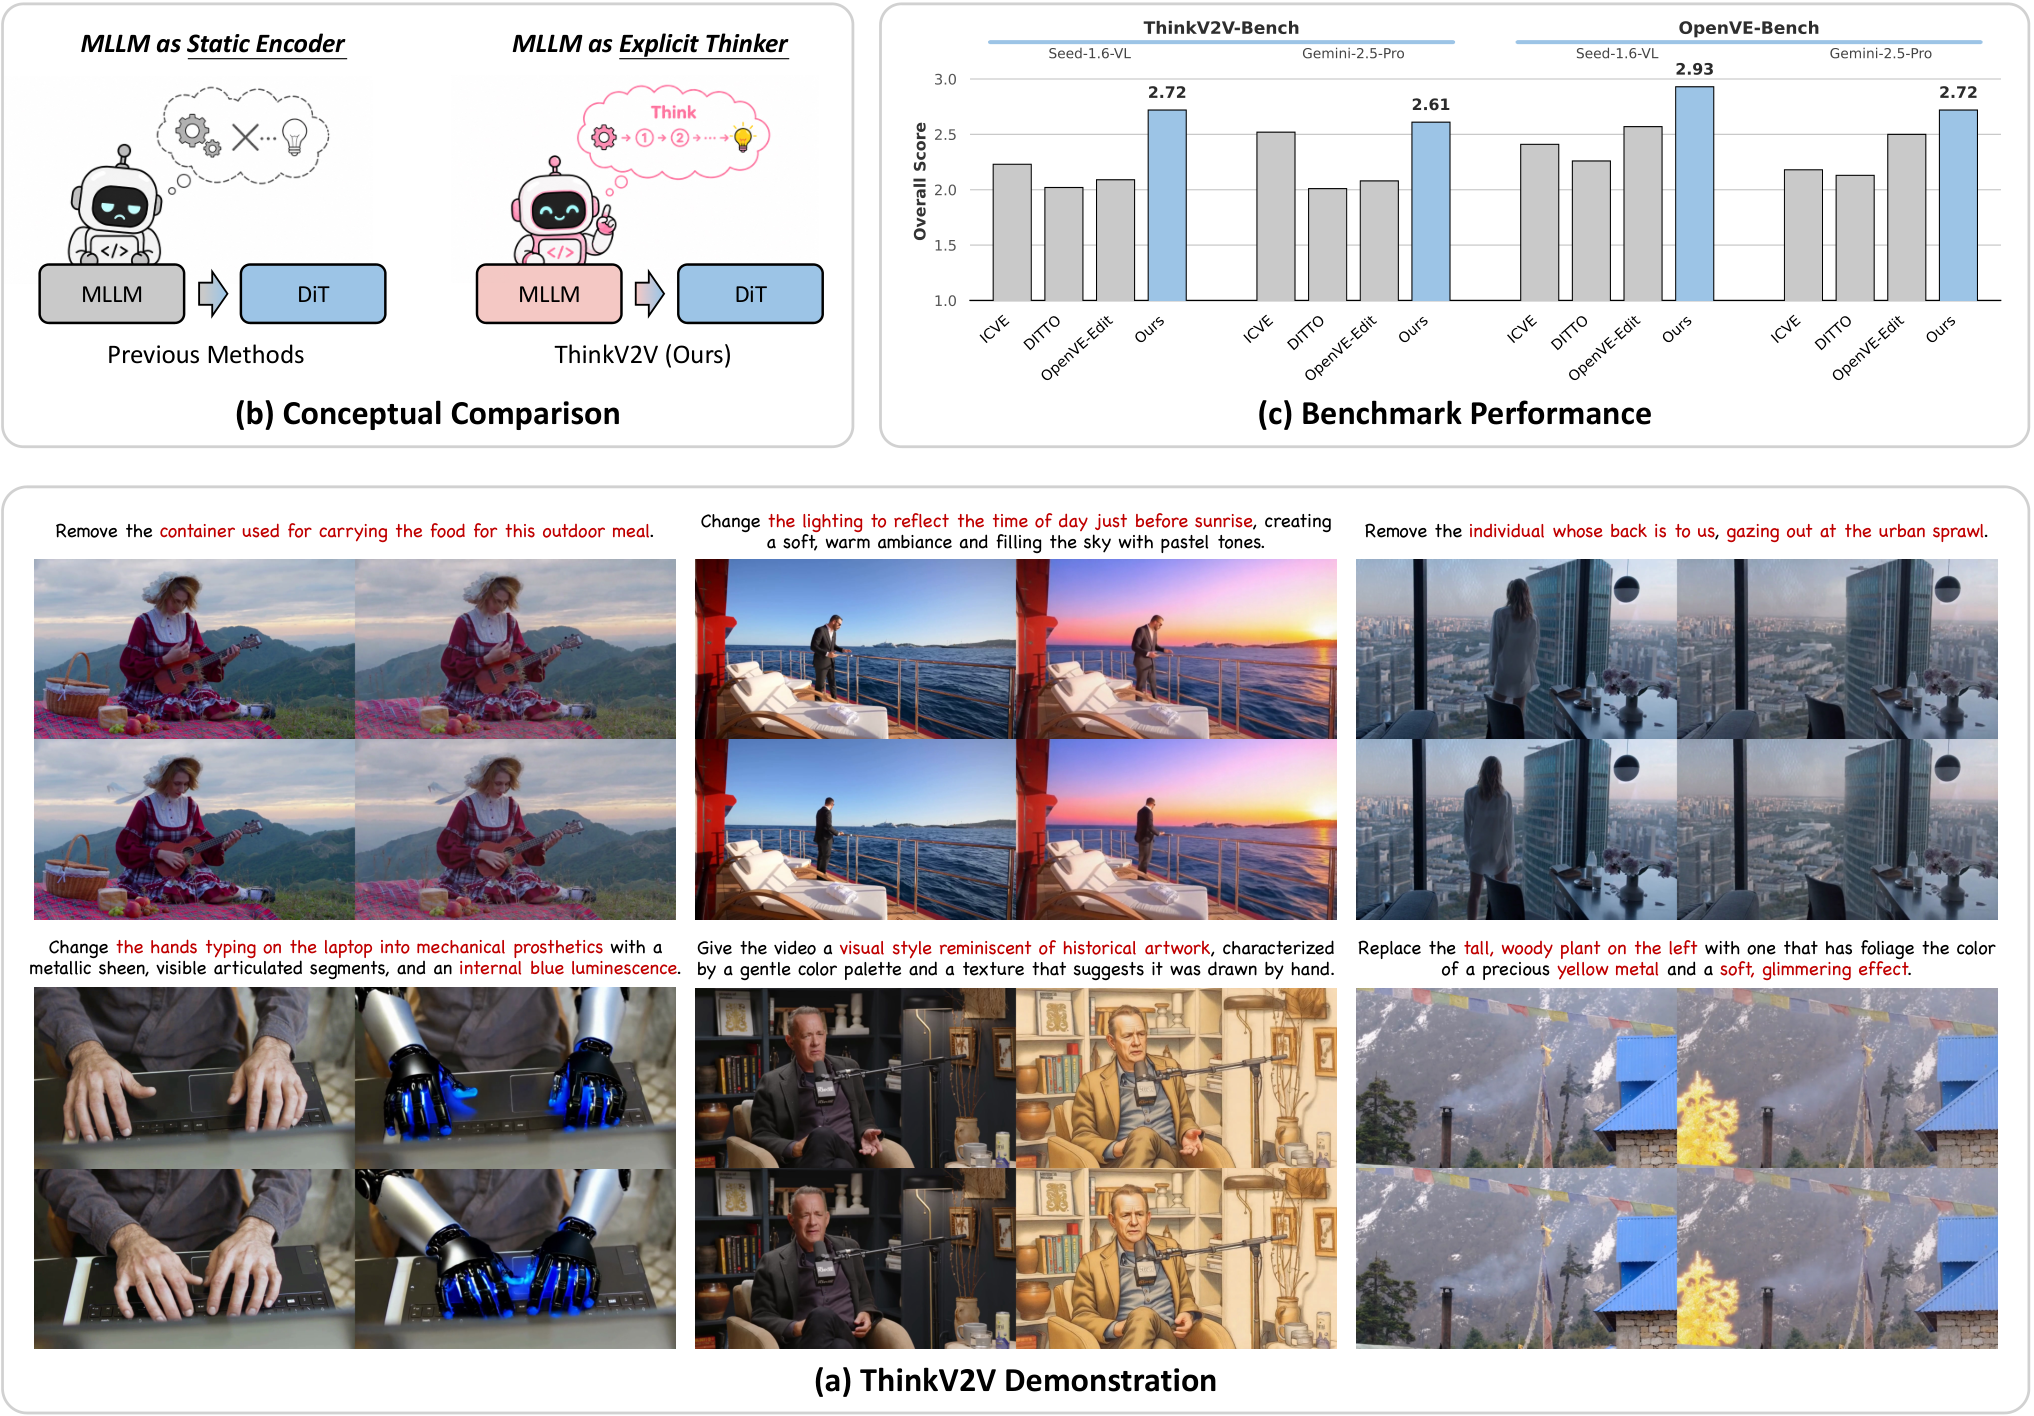
Figure 1 — ThinkV2V 개요 및 추론 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 MLLM의 추론 기능을 최대한 활용하기 위해 Thinking-then-refinement 아키텍처를 도입하고, 추론 중심의 학습 및 추론(Inference) 레시피를 구축하였다 [Figure 2]. 제안 모델은 Qwen3-VL-Thinking-8B를 통해 복잡한 명령어를 해석하고, Wan-2.1-5B 기반의 DiT가 이를 반영하여 비디오를 수정하도록 설계되었다 [Figure 2]. 성능 검증을 위해 저자들은 추론 기반 편집에 특화된 데이터셋인 ThinkV2V-150K와 평가 벤치마크인 ThinkV2V-Bench를 구축하였다 [Figure 3]. 실험 결과, ThinkV2V는 5B 파라미터 규모임에도 불구하고, 기존 10B 규모의 대형 베이스라인 모델들을 상회하는 우수한 성과를 보였다 [Table 1]. 특히, ThinkV2V-Bench와 표준 벤치마크인 OpenVE-Bench 모두에서 최신 SOTA 성능을 기록하며, 암묵적 의도 파악과 인과적 추론이 필요한 편집 시나리오에서 압도적인 효과를 입증하였다 [Table 1], [Figure 4].
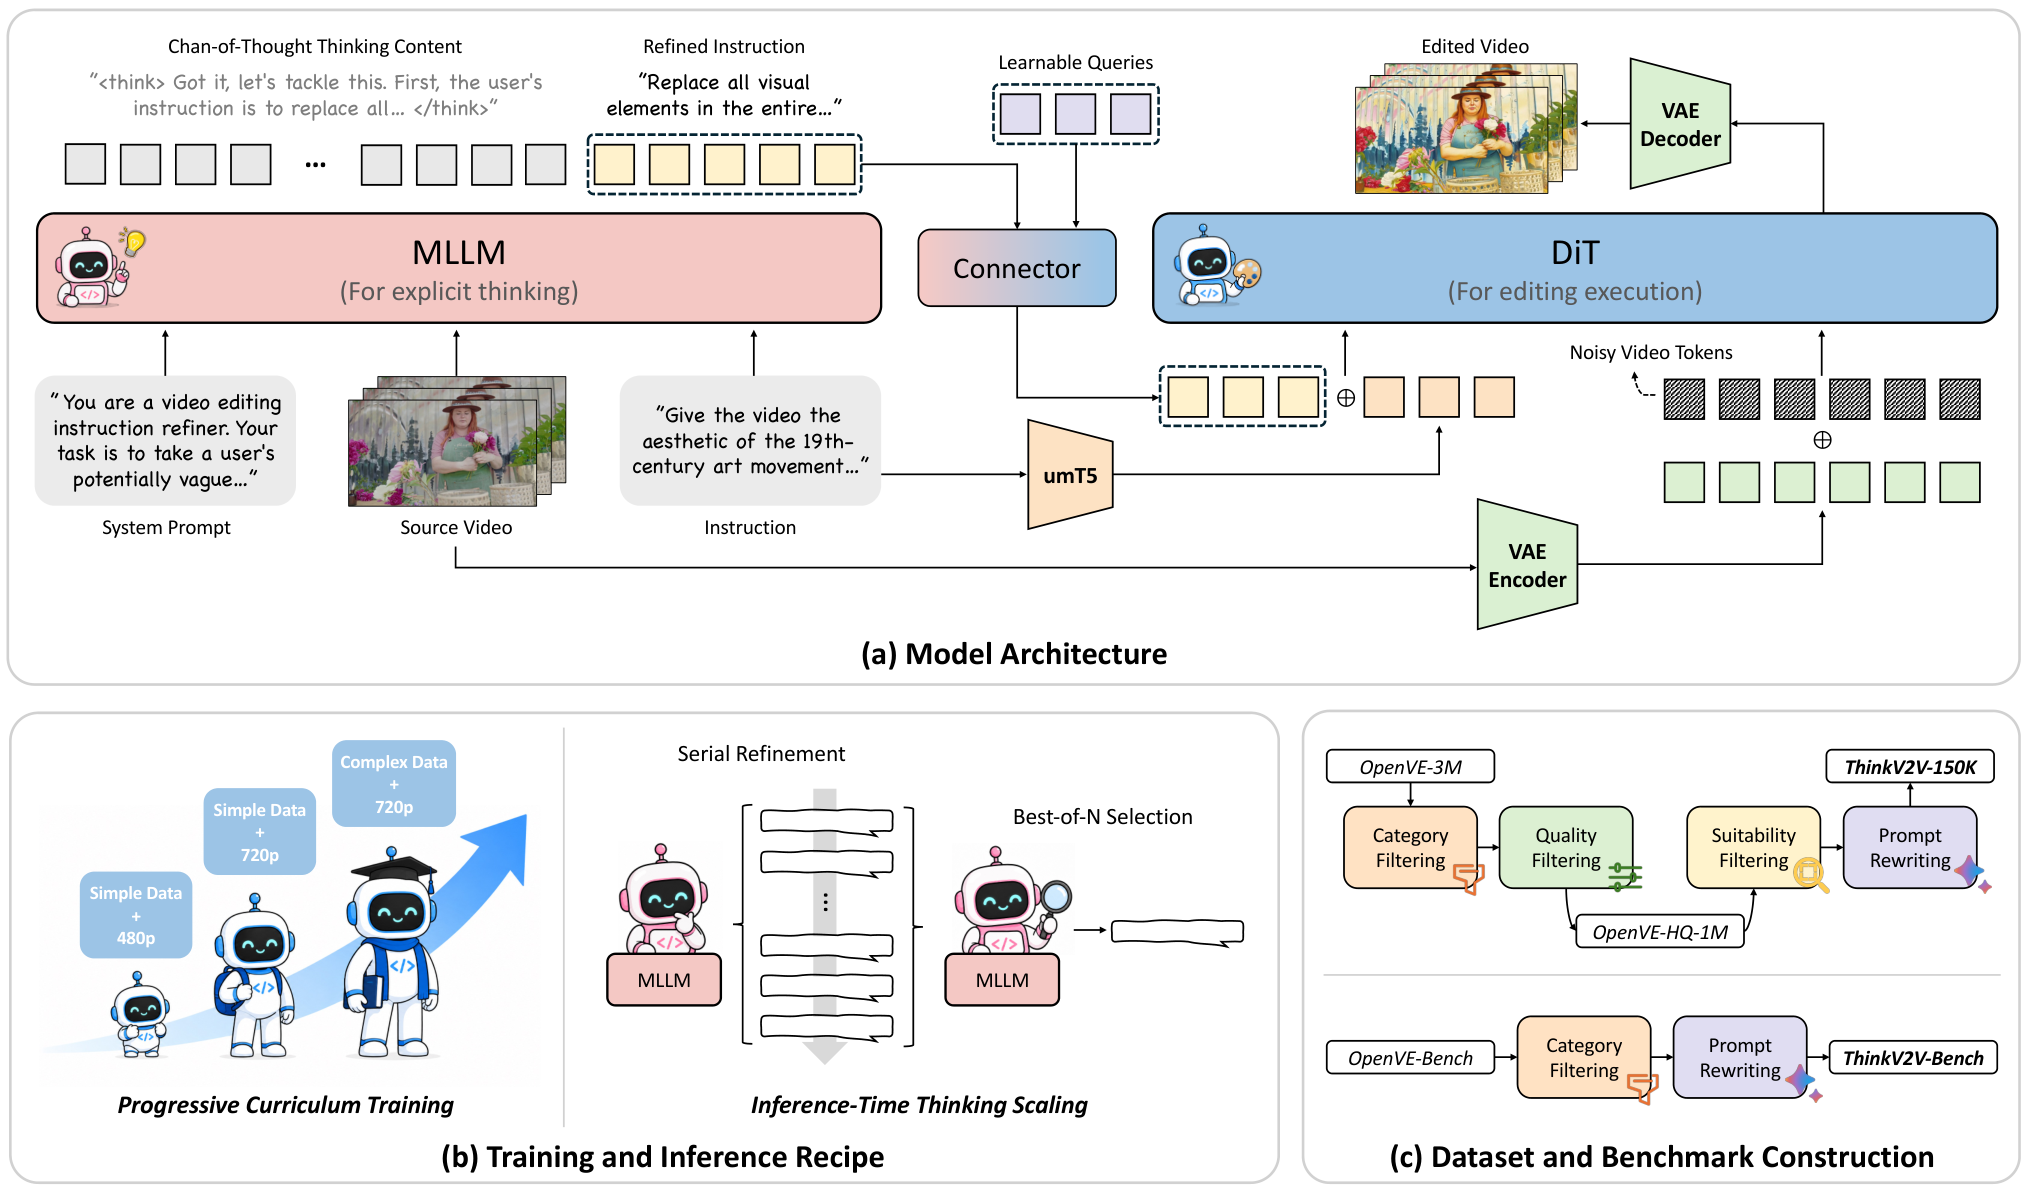
Figure 2 — ThinkV2V의 전체 파이프라인
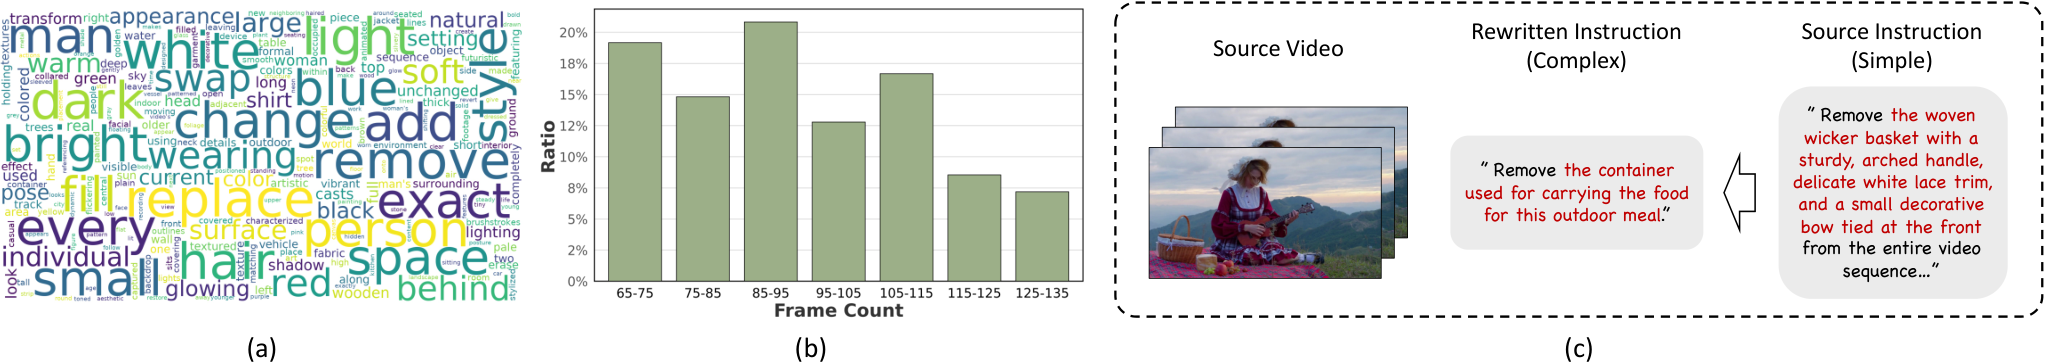
Figure 3 — 데이터셋 및 벤치마크 구성
4. Conclusion & Impact (결론 및 시사점)
본 논문은 instruction-guided video editing에서 모델의 성능을 결정짓는 핵심 요소가 단순한 편집 기술을 넘어 Explicit reasoning에 있음을 입증하였다. ThinkV2V 프레임워크는 MLLM의 논리적 사고 과정을 비디오 편집 조건으로 성공적으로 전환함으로써 학계와 산업계에 새로운 패러다임을 제시한다. 특히 복잡한 사용자 의도를 정확하게 해석하고 실행하는 능력을 강화함으로써, 실제 사용자 환경에서의 실용성을 크게 향상시켰다. 이 연구는 향후 더 효율적인 추론 기반 비디오 생성 시스템 구축을 위한 중요한 기반이 될 것이다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] VideoCoCo: Code-as-CoT for Physically-Consistent Video Generation via an Agentic Dual-Engine System
- [논문리뷰] EvalVerse: Pipeline-Aware and Expert-Calibrated Benchmarking for Professional Cinematic Video Generation
- [논문리뷰] UniUGP: Unifying Understanding, Generation, and Planing For End-to-end Autonomous Driving
- [논문리뷰] VChain: Chain-of-Visual-Thought for Reasoning in Video Generation
- [논문리뷰] Orbia: Do Generated Videos Form a Consistent 3D World?
Review 의 다른글
- 이전글 [논문리뷰] The Low-Rank Structure of VLA Reinforcement Learning
- 현재글 : [논문리뷰] ThinkV2V: Unleashing the Reasoning Capability of MLLMs for Instruction-Guided Video Editing
- 다음글 [논문리뷰] Thinking Outside the Box: Can Language Models Rely on External Guidance Selectively?
댓글