[논문리뷰] The Low-Rank Structure of VLA Reinforcement Learning
링크: 논문 PDF로 바로 열기
메타데이터
저자: Minjae Oh, Yoonah Park, Jongwon Lim, Yohan Jo
1. Key Terms & Definitions (핵심 용어 및 정의)
- VLA (Vision-Language-Action Models): 시각적 입력과 언어 지시를 바탕으로 로봇의 연속적인 행동(Action chunks)을 생성하는 모델로, 본 연구에서는 Flow-matching 기반의 action expert를 사용하는 아키텍처를 다룹니다.
- Timestep Modules: Time MLP와 AdaRMS로 구성된 컴포넌트로, 입력된 denoising timestep($\tau$)을 처리하여 모델의 hidden state를 변조하는 scale, shift, gate 벡터를 생성합니다.
- Update Rank (r95): 모델의 파라미터 변화량($\Delta W$)의 squared Frobenius norm의 95%를 설명하는 최소한의 singular direction 개수로, 파라미터 업데이트의 복잡성을 측정하는 지표입니다.
- AdaRMS (Adaptive RMS Normalization): Timestep Modules 내부에서 conditioning vector를 받아 hidden state를 스케일링하고 이동(shift)시키는 핵심 모듈입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Reinforcement Learning(RL)이 VLA 모델을 post-training 할 때 내부 파라미터를 어떻게 재구성하는지에 대한 근본적인 이해를 목표로 합니다. 기존 연구들은 LLM의 RL post-training이 파라미터 공간에서 LoRA와 같은 저차원 구조를 유도함을 밝혀냈으나, 이와 상이한 구조를 가진 Flow-based VLA에서의 학습 신호 전파 메커니즘은 거의 규명되지 않았습니다. 저자들은 RL이 단순히 모델 성능을 개선하는 것을 넘어, 특정 모듈에 파라미터 업데이트를 집중시킨다는 가설을 검증하고자 합니다. 특히 기존에 간과되었던 Timestep Modules가 모델의 지식을 인코딩하는 핵심임을 밝히는 것이 본 연구의 주요 과제입니다 [Figure 2].
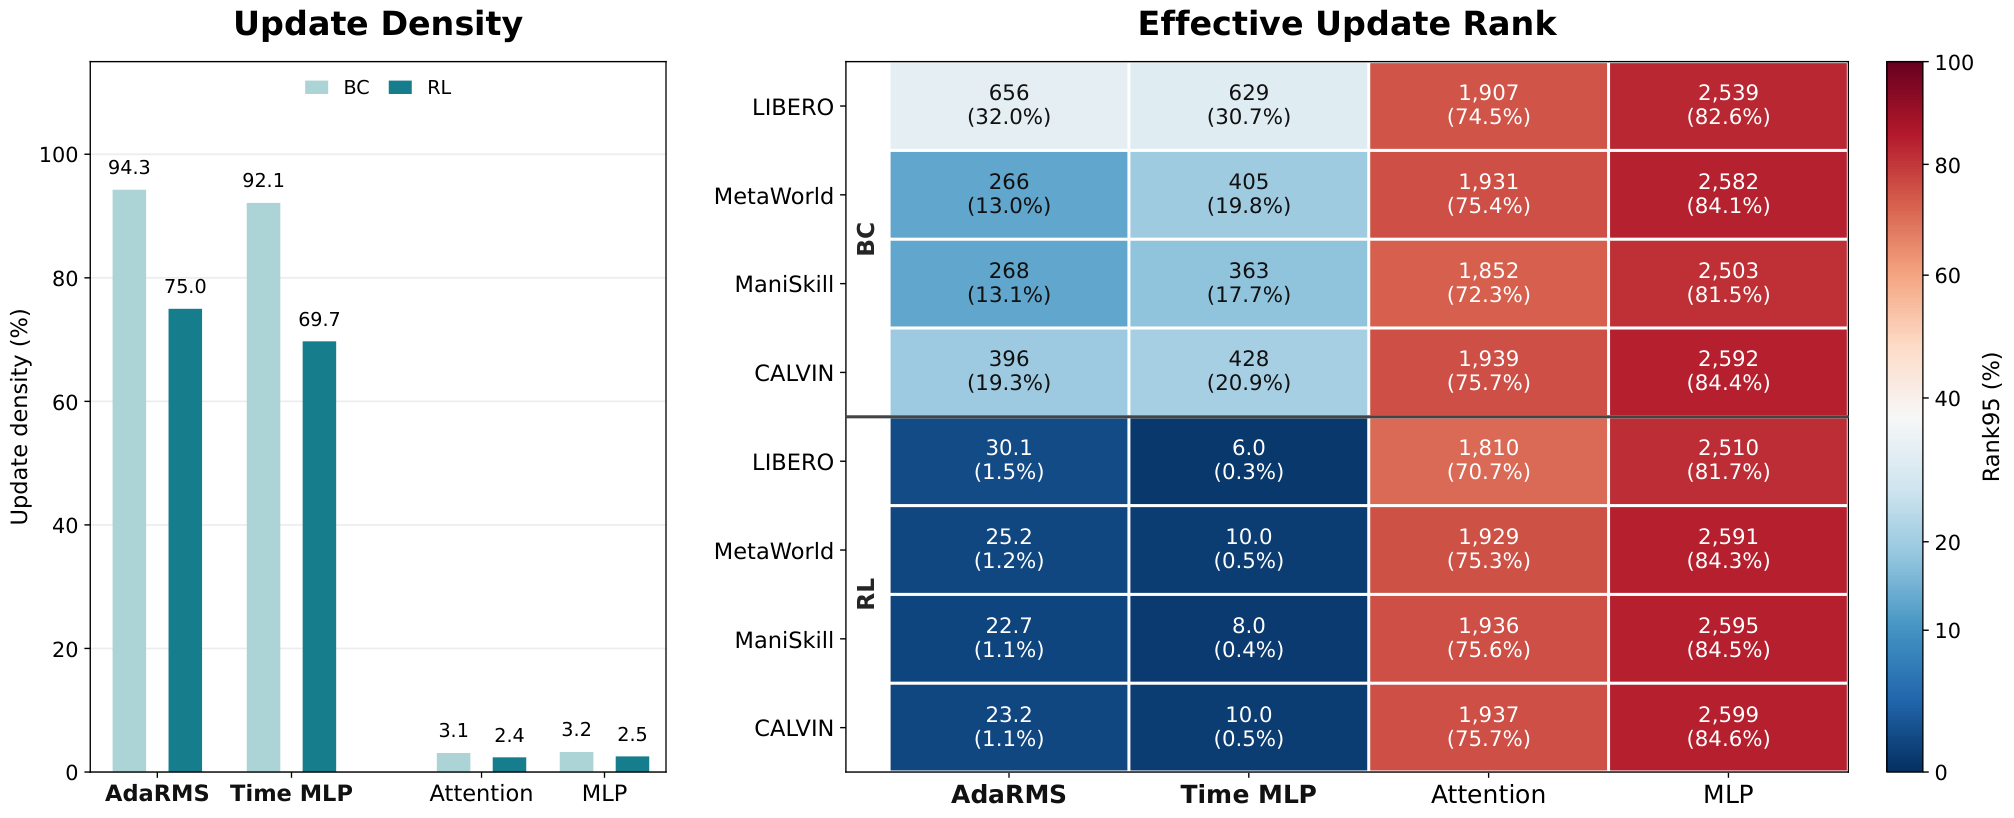
Figure 2 — RL 학습의 저차원 업데이트
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 $\pi_{0.5}$, GR00T 등 다양한 VLA 모델과 LIBERO, ManiSkill 등의 벤치마크를 활용하여 RL 학습 전후의 파라미터 변화를 분석했습니다. 실험 결과, RL은 Timestep Modules에 업데이트를 집중시키며, 이 모듈들의 업데이트는 BC(Behavior Cloning) 대비 훨씬 낮은 Effective Update Rank를 가짐을 확인했습니다 [Figure 2]. 모듈 대체 실험(Module-replacement)을 통해, 전체 파라미터 중 적은 비중을 차지하는 Timestep Modules만 RL로 학습해도 전체 성능의 상당 부분을 복구함을 입증했습니다 [Table 1]. 또한, RL은 AdaRMS의 연산을 특정 denoising timestep에 특화되도록 유도하며(Specialization), 그중에서도 shift vector가 작업 성공 여부를 예측하는 데 가장 중요한 정보를 담고 있음을 프로빙(Probing)을 통해 확인했습니다 [Figure 3]. 이를 활용하여 shift update 방향으로 정책을 Steering한 결과, 추가적인 RL 학습 없이도 작업 성공률이 모든 벤치마크에서 2.0%~4.0% 향상되었습니다 [Table 3].
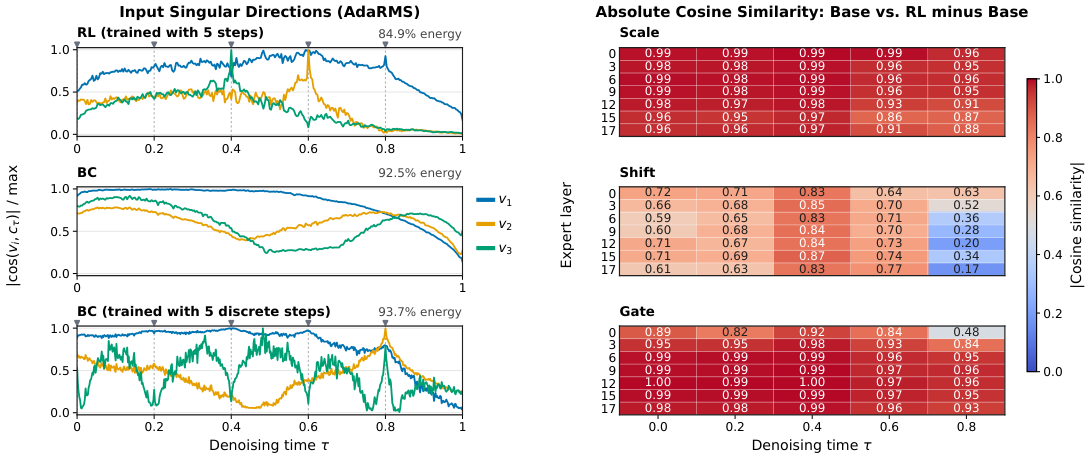
Figure 3 — AdaRMS 특화 및 Shift 벡터
4. Conclusion & Impact (결론 및 시사점)
본 연구는 VLA의 Reinforcement Learning이 모델을 저차원의 구조적 파라미터 업데이트로 재구성하며, 그 중심에는 Timestep Modules가 있음을 처음으로 규명했습니다. 연구 결과는 Timestep Modules가 작업 성공과 관련된 조절 신호를 인코딩하는 일종의 '제어 센터' 역할을 함을 보여줍니다. 이러한 발견은 향후 로봇 학습에서 Parameter-efficient adaptation 전략을 최적화하고, 작업 간 지식 전이 및 인터프리터블한 정책 설계를 위한 중요한 이론적 토대를 제공합니다.
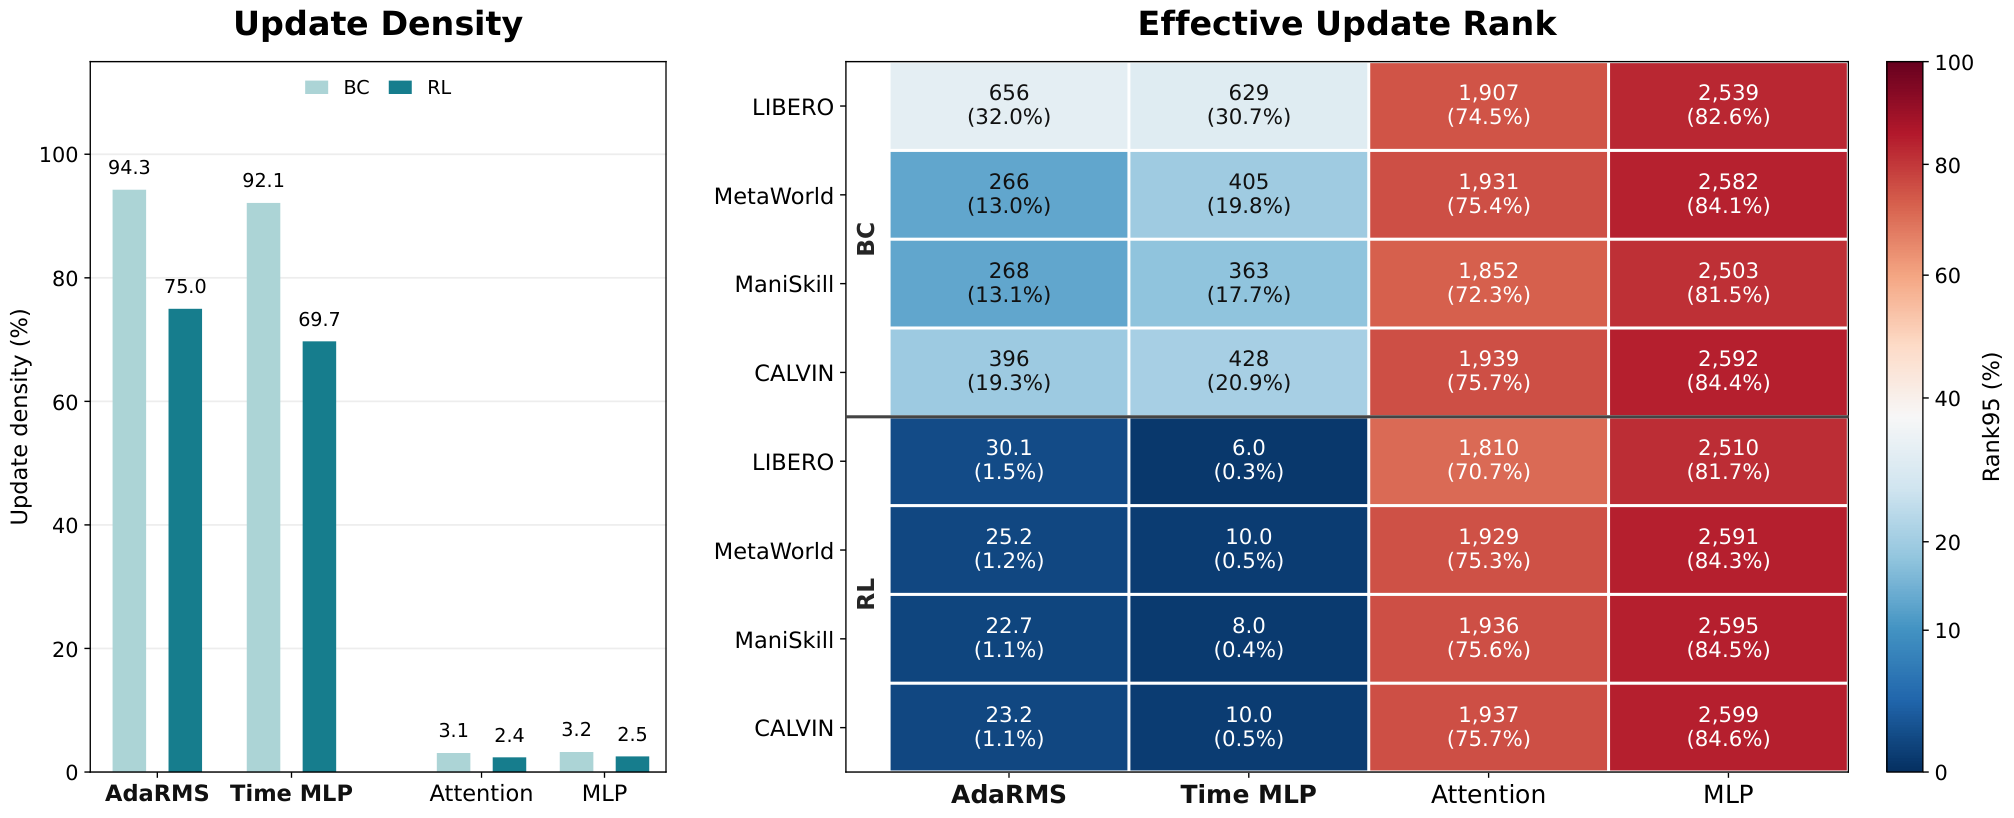
Figure 1 — Timestep Module 구조
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] EXIMO: VLM Guided Exploration of VLA Policies
- [논문리뷰] JoyNexus: Service-Oriented Multi-Tenant Post-Training for VLA Models
- [논문리뷰] Spectral Rewiring for Exploration, Purification, and Model Merging
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- [논문리뷰] SCOPE: Semantic Bounded Credit Optimization for Prompt Engineering in Text-to-image Generation
Review 의 다른글
- 이전글 [논문리뷰] The Evolution of Attention in Large Language Models: Mechanisms, Trade-offs, and Emerging Trends
- 현재글 : [논문리뷰] The Low-Rank Structure of VLA Reinforcement Learning
- 다음글 [논문리뷰] ThinkV2V: Unleashing the Reasoning Capability of MLLMs for Instruction-Guided Video Editing
댓글