[논문리뷰] UniEvo-VL: An On-policy Self-Distillation Training Recipe for Multimodal Model Self-improvement
링크: 논문 PDF로 바로 열기
메타데이터
저자: Fang Wu, Da Xing, Yanjie Huang, Junxi Wang, Ji Wang, Hejia Geng, Guancheng Wan, Bowen Zuo, Xiaomin Li, Shixiang Tang, Xinyu Xiang, Zehong Wang, Shiyi Du, Peng Xia, Shuangjia Zheng, Yining Hong, Li Erran Li, Jure Leskovec, Yejin Choi
1. Key Terms & Definitions (핵심 용어 및 정의)
- UniEvo-VL: Multimodal model이 생성한 이미지에 대한 self-critique를 학습 데이터로 변환하여 모델의 생성 성능을 자가 개선하는 프레임워크입니다.
- On-policy Self-Distillation (OPSD): 학생 모델(Student)이 원본 prompt로 생성하는 경로와, privileged information(교정 피드백)을 조건으로 하는 교사 모델(Teacher)의 경로 간의 분산(Divergence)을 최소화하는 학습 기법입니다.
- Corrective Conditioning: 모델이 생성한 이미지의 오류를 이해 모델(Understanding-mode)이 식별하고, 이를 바탕으로 기존 prompt를 수정한 revised prompt를 생성하여 생성 모델(Generation-mode)의 학습 조건으로 활용하는 과정입니다.
- Post-revision Verification: 수정한 prompt가 실제로 원래 의도한 결과를 생성하는지 검증하는 단계로, 생성된 이미지가 understanding-mode에서 다시 통과(Accept)되는 경우에만 학습 데이터로 선별합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 현대의 통합형 Multimodal Models(MMM)가 가진 생성 및 이해 능력을 활용하여 외부 감독 없이 모델 스스로 성능을 개선하는 효율적인 방법을 탐구합니다. 기존 연구들은 자기 생성 데이터를 학습에 활용하거나 명시적인 reflection에 의존하는 방식을 취했으나, 이러한 피드백이 생성 모델의 intermediate denoising 과정에 직접적으로 반영되지 않는다는 한계가 있었습니다 [Figure 1]. 저자들은 verification이 generation보다 상대적으로 쉽다는 점에 착안하여, 교정 피드백을 privileged information으로 활용해 생성 과정 자체를 개선하는 새로운 self-evolution 프레임워크가 필요함을 제안합니다.
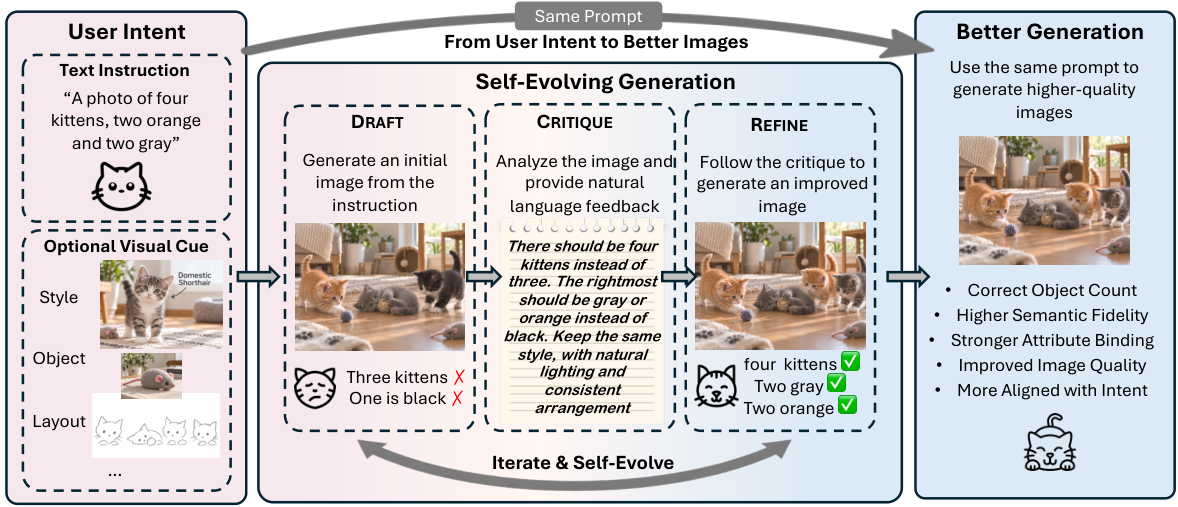
Figure 1 — 모델의 자가 진화 루프 개념도
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 corrective feedback을 생성 모델에 내부화하기 위해 critique-conditioned on-policy self-distillation을 제안합니다 [Figure 2]. 우선 understanding-mode 모델이 생성된 이미지의 오류를 파악하고, 이를 바탕으로 prompt를 수정한 뒤(Corrective Conditioning), 동일한 noise 하에 학생 모델(기본 prompt 사용)과 교사 모델(수정된 prompt 사용)의 생성 경로를 일치시키는 학습을 진행합니다. 이때, post-revision verification 단계를 거쳐 성능이 개선된 것으로 검증된 샘플만을 학습 데이터로 사용하여 효율적인 학습이 가능하게 했습니다.
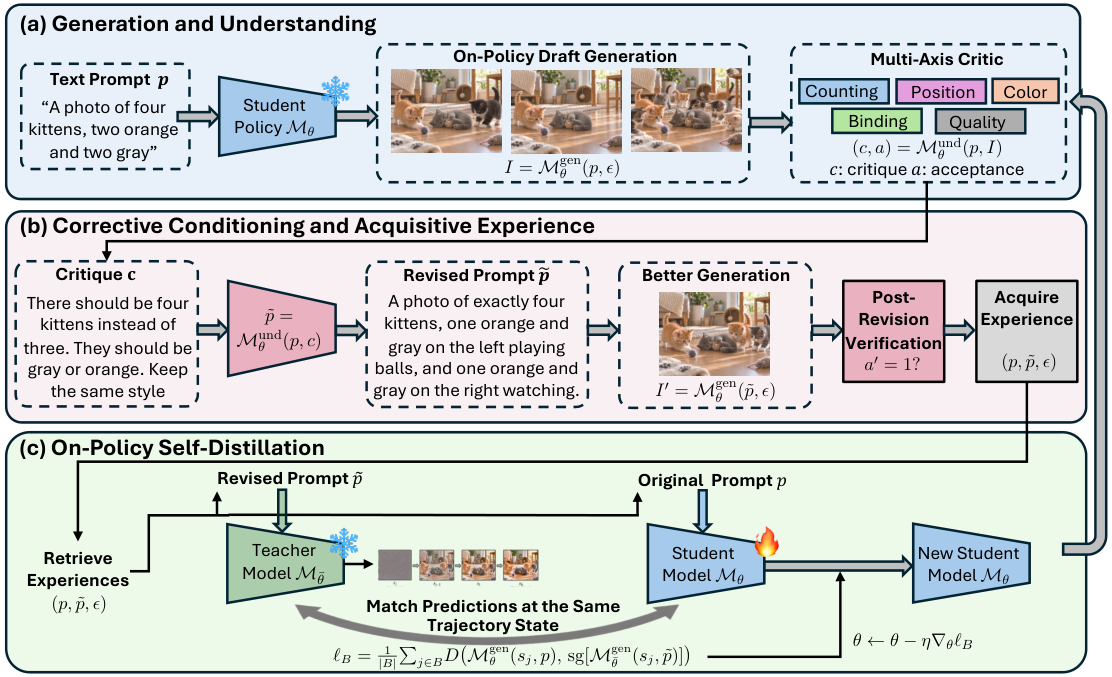
Figure 2 — UniEvo-VL 전체 학습 프레임워크
실험 결과, 제안 모델은 Qwen-Image-2512를 기반으로 GenEval 성능을 0.747에서 0.808로, GenEval2 Soft-TIFA 점수를 32.97에서 35.53으로 크게 향상시켰습니다 [Table 1]. 또한, 강력한 외부 critic(예: GPT5.6-Luna)을 사용할 경우 더욱 높은 self-evolving ceiling을 달성할 수 있음을 확인했습니다. 정량적으로는 compositional generation과 text rendering 분야에서 강력한 성능 우위를 보였으며, 특히 baseline 모델이 어려워하던 초기 low-scoring prompt 구간에서 괄목할만한 개선을 보였습니다 [Figure 4].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 corrective conditioning을 on-policy self-distillation과 결합하여 Multimodal Models의 자가 개선 성능을 극대화할 수 있음을 입증했습니다. 이 연구는 외부 감독 없이도 모델이 스스로의 실패를 학습하고 개선할 수 있는 기술적 토대를 마련하였으며, 생성과 이해라는 통합된 능력을 활용해 복잡한 추론 및 생성 task에서 모델의 실질적인 성능을 끌어올릴 수 있음을 보여줍니다. 특히 inference-time reflection의 혜택을 모델 파라미터 내부에 직접 내재화함으로써 효율적인 자가 진화 프레임워크를 제시했다는 점에서 학계와 산업계에 중요한 시사점을 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] PlanViz: Evaluating Planning-Oriented Image Generation and Editing for Computer-Use Tasks
- [논문리뷰] Sparse-LaViDa: Sparse Multimodal Discrete Diffusion Language Models
- [논문리뷰] VQ-VA World: Towards High-Quality Visual Question-Visual Answering
- [논문리뷰] Echo-4o: Harnessing the Power of GPT-4o Synthetic Images for Improved Image Generation
- [논문리뷰] Intern Lumina U2: A Multi-Codebook Diffusion Large Language Model for Omni-Visual Understanding and Image Generation
Review 의 다른글
- 이전글 [논문리뷰] Thinking Outside the Box: Can Language Models Rely on External Guidance Selectively?
- 현재글 : [논문리뷰] UniEvo-VL: An On-policy Self-Distillation Training Recipe for Multimodal Model Self-improvement
- 다음글 [논문리뷰] Unmask the State: When Does State Adaptation Matter for Masked Diffusion Language Models
댓글