[논문리뷰] Better Supervision Is Nearby: Neighborhood On-Policy Self-Distillation
링크: 논문 PDF로 바로 열기
저자: Xincheng Wei, Yifan Ding, Yoshua Li, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- OPSD (On-policy Self-distillation): Privileged teacher가 reference solution을 참고하여 student 모델의 next-token distribution을 지도하는 학습 방식입니다.
- Neighborhood Expert: 동일한 base checkpoint에서 파라미터가 미세하게 섭동(perturbation)된 모델들로, 원본 teacher가 제공하지 못하는 보완적인 supervision을 제공합니다.
- Filtered PTA (Positive Teacher Advantage): Reference solution을 활용하여 특정 시점에서 expert가 student 대비 어느 정도의 이득(correction)을 제공하는지를 정량화한 지표입니다.
- MaxPeak-Anchored Quantile Routing: 학생이 방문한 상태에서 최적의 expert를 선택하기 위해 가장 높은 확률을 제시하는 token을 anchor로 설정하고, 그에 따라 학습 목표를 배분하는 라우팅 기법입니다.
- SCGate (Student-Confidence Gate): 학생 모델의 예측 신뢰도가 낮은 지점만을 선택적으로 학습하여 supervision의 효율을 높이는 필터링 메커니즘입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 표준 OPSD가 단일 고정 파라미터 설정을 가진 Privileged Teacher에만 의존하여 잠재적인 보완 정보를 충분히 활용하지 못한다는 점을 지적합니다. 기존 방식은 고정된 teacher 설정이 모든 student-visited state에서 최선의 지도를 제공한다고 가정하지만, 실제로는 파라미터 공간의 인근 영역(neighborhood)에 더 유용한 정보가 존재할 수 있습니다. 저자들은 이 문제를 해결하기 위해 다양한 로컬 전문가(local experts)를 구성하고, 이들로부터 보완적인 corrections를 추출하여 학습에 활용하고자 합니다. [Figure 1]은 표준 OPSD와 제안하는 NEIGHBORHOOD OPSD의 차이를 명확히 보여주며, 왜 전문가 풀(expert pool)을 통한 state-wise routing이 필요한지를 제시합니다.
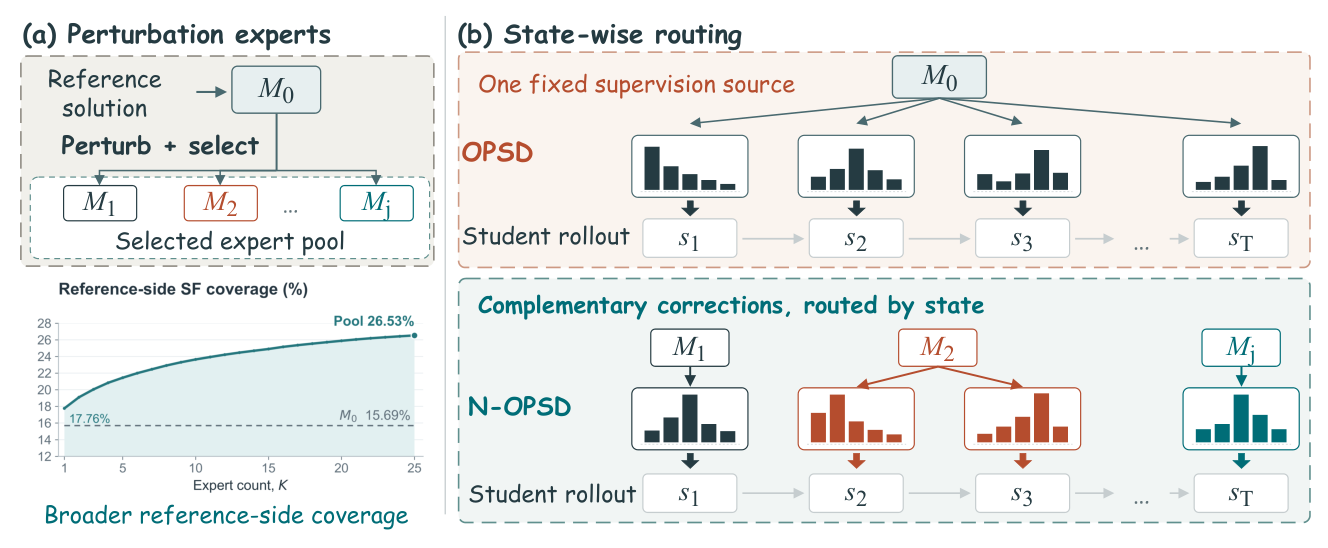
Figure 1 — 표준 OPSD와 NEIGHBORHOOD OPSD의 구조적 차이 및 전문가 라우팅 개념을 도식화한 핵심 다이어그램
3. Method & Key Results (제안 방법론 및 핵심 결과)
NEIGHBORHOOD OPSD는 오프라인 단계에서 Filtered PTA를 기준으로 보완적인 전문가 풀을 구성하고, 온라인 단계에서 학생의 현재 상태에 적합한 전문가를 동적으로 라우팅하는 프레임워크를 제안합니다. [Figure 2]는 오프라인 전문가 선정 및 온라인 라우팅 과정의 전체 아키텍처를 설명합니다. 핵심은 MaxPeak 기법을 통해 앵커 토큰을 결정하고, Quantile Selection을 통해 anchor-consistent한 전문가들 중 최적의 분포를 선택하는 것입니다. 실험 결과, 제안 방법론은 Qwen3-1.7B, 4B, 8B 모델에서 OPSD 대비 벤치마크 평균(Average@12)을 각각 2.75, 1.67, 1.94점 향상시키는 탁월한 성능을 보였습니다. [Table 1]은 세 가지 Qwen3 모델 스케일에서 본 방법론이 기존 SFT, GRPO, EOPD, PW-OPSD 대비 가장 높은 정확도를 기록했음을 정량적으로 입증합니다.
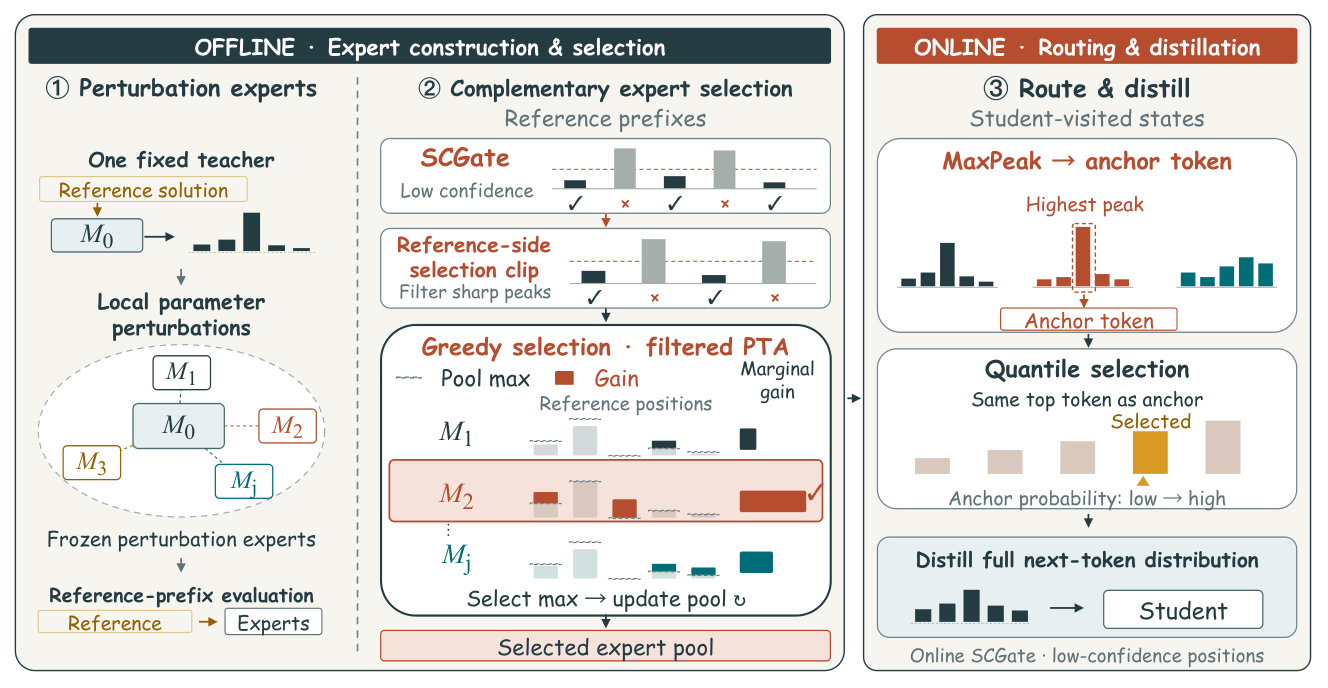
Figure 2 — 오프라인 전문가 선정부터 온라인 라우팅 및 증류 과정까지를 포함하는 전체 프레임워크 아키텍처
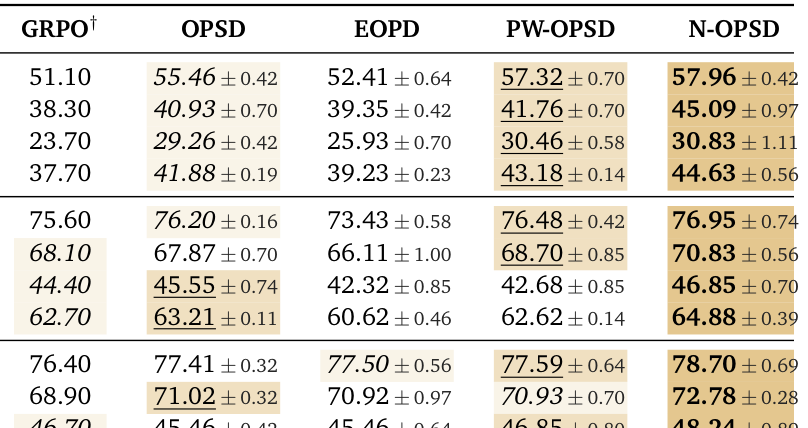
Table 1 — 다양한 모델 스케일에서 제안 방법론이 기존 SFT, GRPO, OPSD 대비 달성한 성능 우위를 보여주는 주요 결과 테이블
4. Conclusion & Impact (결론 및 시사점)
본 논문은 privileged teacher의 파라미터 인근(neighborhood) 영역이 풍부한 보완적 학습 신호를 포함하고 있음을 증명하고, 이를 활용한 NEIGHBORHOOD OPSD 프레임워크를 성공적으로 구축하였습니다. 이 연구는 모델의 파라미터 공간을 전문가 풀로 활용하는 새로운 최적화 전략을 제시함으로써, LLM의 수학적 추론 능력 향상을 위한 자기 증류(self-distillation) 분야의 성능 상한을 한 단계 높였습니다. 향후 코드 생성이나 멀티홉 질의응답과 같은 다양한 태스크로의 확장이 가능하며, 컴퓨팅 효율을 최적화한 풀 업데이트 전략 등은 학계와 산업계의 모델 최적화 연구에 중요한 기여를 할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- [논문리뷰] Semifactual Credit-Augmented Policy Optimization
- [논문리뷰] Questioning the Questions: Sustaining Self-Evolution in Reasoning Models
- [논문리뷰] DiffGate: Difficulty-Gated Teacher Guidance for On-Policy Distillation
- [논문리뷰] The Missing Primitive: Diagnosing and Repairing Mathematical Reasoning in Large Language Models
Review 의 다른글
- 이전글 [논문리뷰] Benchmarking and Enhancing Skill-Level Memory for Partially Observable Robotic Manipulation
- 현재글 : [논문리뷰] Better Supervision Is Nearby: Neighborhood On-Policy Self-Distillation
- 다음글 [논문리뷰] Beyond Memory: Harnessing Long-Horizon Agents with Explicit Belief States
댓글