[논문리뷰] PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion
링크: 논문 PDF로 바로 열기
메타데이터
저자: Lehan Yang, Daiqing Qi, Wenhao Zhang, Avery Li, Yiqing Yang, Yifan Li, Yu Kong, Haitian Zheng, Zhifei Zhang, Zhe Lin, Varun Jampani, Sheng Li
1. Key Terms & Definitions (핵심 용어 및 정의)
- REPA (REPresentation Alignment): Diffusion Transformer(DiT)의 중간 특징을 사전 학습된 고정 인코더(Teacher)와 정렬하여 학습을 가속화하는 기법입니다.
- PixelDense: Dense-prediction foundation model들을 활용해 의미론적(semantic) 및 기하학적(geometric) 정렬을 각각 분리된 stream으로 수행하는 제안 방법론입니다.
- Factorized Projection: 동일한 Denoiser 특징을 의미론적 stream과 기하학적 stream으로 분리하여 각 teacher bank가 독립적인 subspace에서 학습되도록 하는 기술입니다.
- Weight-space Orthogonality Penalty: 두 stream의 투영 가중치 간의 상관관계를 강제로 낮추어, 의미론적 gradient와 기하학적 gradient가 Denoiser 내부에서 서로 간섭(competition)하지 않도록 하는 규제 방식입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Diffusion 모델 학습 시 고정된 인코더로부터 정렬 신호를 받는 REPA 방식이, 단순히 의미론적 teacher에만 의존할 때 발생하는 한계를 해결하고자 합니다. 기존 연구들은 DINOv2와 같은 모델을 사용해 왔으나, 정작 이미지의 구조적 정보를 담는 dense-prediction 모델(SAM2, Depth Anything v2 등)의 활용은 미흡했습니다 [Figure 2]. 저자들은 단순히 여러 teacher를 하나의 Denoiser에 합치는 경우, 의미론적 invariance와 기하학적 invariance가 서로 충돌하여 오히려 성능이 저하되는 '음의 전이(negative-transfer)' 현상을 발견했습니다. 따라서, 서로 다른 성격의 구조적 정보를 효율적으로 Denoiser에 주입하기 위한 새로운 representation routing 메커니즘이 필요합니다.
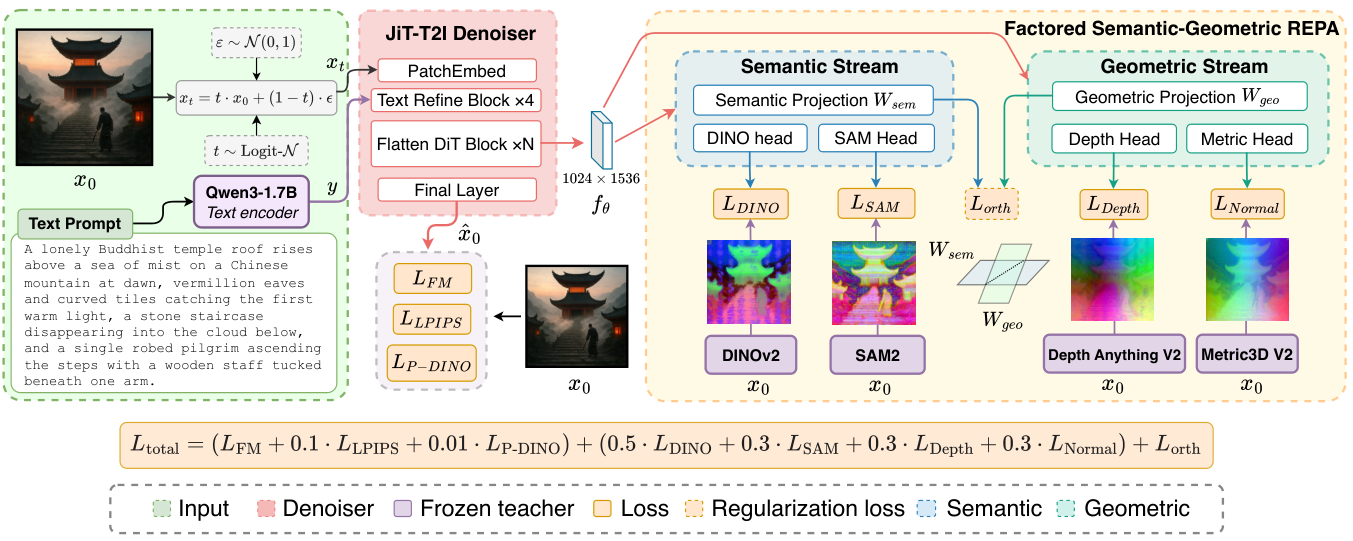
Figure 2 — PixelDense 전체 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 DINOv2 및 SAM2를 의미론적(semantic) stream으로, Depth Anything v2 및 Metric3D v2를 기하학적(geometric) stream으로 분리하여 학습하는 PixelDense를 제안합니다 [Figure 2]. 이 두 stream은 weight-space orthogonality penalty를 통해 Denoiser의 서로 다른 subspace를 점유하게 되며, 이를 통해 teacher 간의 경쟁을 방지하고 상호 보완적인 구조 정보를 학습합니다. 모든 teacher 모델은 학습 중에만 사용되고 추론 시에는 제거되어 Inference Cost가 전혀 발생하지 않습니다. 실험 결과, PixelGen-XXL 백본에 적용 시 GenEval Overall 지표가 0.7927에서 0.8093으로 향상되는 성과를 거두었습니다 [Table 1]. 또한, 부분 노이즈 복원(partial-noise reconstruction) 실험에서 기존 대비 Panoptic PQ 점수가 최대 53.1% 증가하고, Depth AbsRel 오류율이 최대 36.0% 감소하는 등 구조적 일관성 측면에서 우월한 성능을 입증했습니다 [Table 2].
4. Conclusion & Impact (결론 및 시사점)
본 논문은 다양한 dense-prediction teacher 모델들을 독립적인 subspace로 routing함으로써 Diffusion 모델의 학습 효율과 구조적 정확도를 동시에 향상시켰습니다. 제안된 PixelDense는 별도의 Inference 비용 없이도 compositional generation 성능을 극대화하며, 다양한 Pixel-space Diffusion 아키텍처에 범용적으로 적용 가능하다는 강점을 가집니다. 이 연구는 고도화된 dense-perception 기초 모델들이 생성 모델의 제어력과 정밀도를 높이는 데 핵심적인 역할을 할 수 있음을 학계와 산업계에 시사합니다.
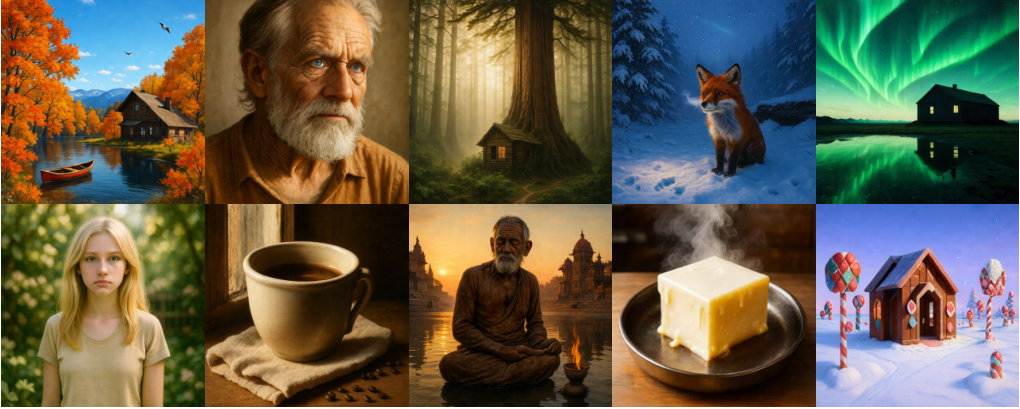
Figure 1 — PixelDense 생성 예시
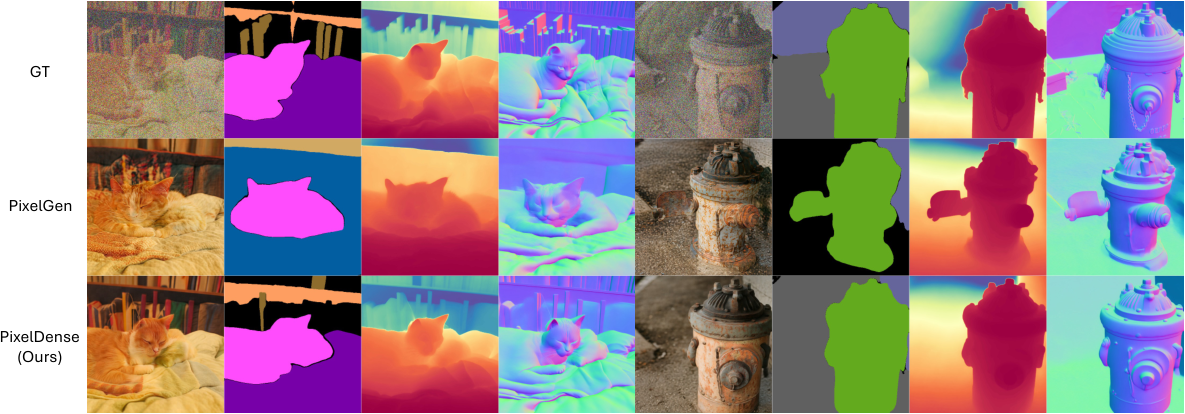
Figure 3 — 기하학적 복원 품질 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ReFlowSET: Representation-Aligned Latent Flow Matching for SAR-to-EO Image Translation
- [논문리뷰] From Prompting to Composing: A Spatial Canvas Interface for Poster Generation
- [논문리뷰] Iris-3B: Going Beyond the Latent with Pixel-Space Diffusion Training, Conversion and Fine-Tuning
- [논문리뷰] GRACE: Generation-aware latent compression for efficient video generation
- [논문리뷰] Learning to Read the Contextual Tokens in Diffusion Transformers
Review 의 다른글
- 이전글 [논문리뷰] PhysVista: Benchmarking Physical Intelligence in VLMs via a Perception-Reasoning-Assessment Loop
- 현재글 : [논문리뷰] PixelDense: Dense Prediction as Representation Alignment for Pixel Diffusion
- 다음글 [논문리뷰] Pretrain Once, Route Anywhere: Towards a Foundation Model for LLM Routing
댓글