[논문리뷰] On-Policy Parameter Update Direction Underlies Generalization in LLM Post-Training
링크: 논문 PDF로 바로 열기
The paper "On-Policy Parameter Update Direction Underlies Generalization in LLM Post-Training" by Shufan Shen et al. focuses on the parameter update behaviors in LLM post-training.
Here's a breakdown to construct the summary:
Authors: Shufan Shen, Zhongni Hou, Junshu Sun, Yufei Zhang, Wei Lin, Guojun Yin, Qingming Huang, Shuhui Wang
Keywords (from abstract and introduction): on-policy post-training, supervised fine-tuning (SFT), generalization, parameter update direction, LLM, optimization principles, OPSFT, training efficiency, high-quality trajectories.
Part 1: Summary Body
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- On-Policy Post-Training: 모델이 자기 생성(self-generated)한 응답을 사용하여 LLM을 최적화하는 패러다임으로, 다양한 태스크에서 강력한 Generalization 성능을 달성한다.
- Supervised Fine-Tuning (SFT): 고정된 Ground-Truth 응답을 사용하여 모델을 최적화하는 Off-Policy 패러다임으로, On-Policy 방식 대비 Generalization 성능이 낮다는 한계가 있다.
- Parameter Update Direction: LLM의 각 Parameter가 업데이트되는 방향(location 및 sign)으로, 본 논문에서는 On-Policy Paradigm의 핵심 Generalization 원리로 제시된다.
- OPSFT (On-Policy direction-constrained Supervised Fine-Tuning): On-Policy Paradigm에 의해 식별된 Parameter Update Direction에 SFT 업데이트를 제약하여 SFT의 Generalization 성능을 향상시키는 제안 방법론.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 On-Policy Post-Training Paradigm의 뛰어난 Generalization 성능의 근본적인 원인을 Parameter Update Behavior에서 찾고자 한다. 기존 연구들은 On-Policy Training 과정에서 관찰되는 Update Behavior를 단순한 부산물로 취급하며, 이를 SFT와 같은 다른 Paradigm의 Generalization 성능 개선을 위한 Optimization Principle로 활용하는 데 한계가 있었다. 특히, SFT는 Training 과정에서 Parameters를 일관된(consistent) 방향으로 업데이트하는 반면, On-Policy Paradigm은 Training 중 Update Direction을 지속적으로 조정한다 [Figure 1]. 이러한 차이점과 기존 연구가 Update Location에 집중하고 Update Direction의 기여를 간과했다는 문제점을 해결하기 위해, 저자들은 On-Policy Paradigm의 Parameter Update Direction이 SFT의 Generalization을 개선할 수 있는지 탐구한다.
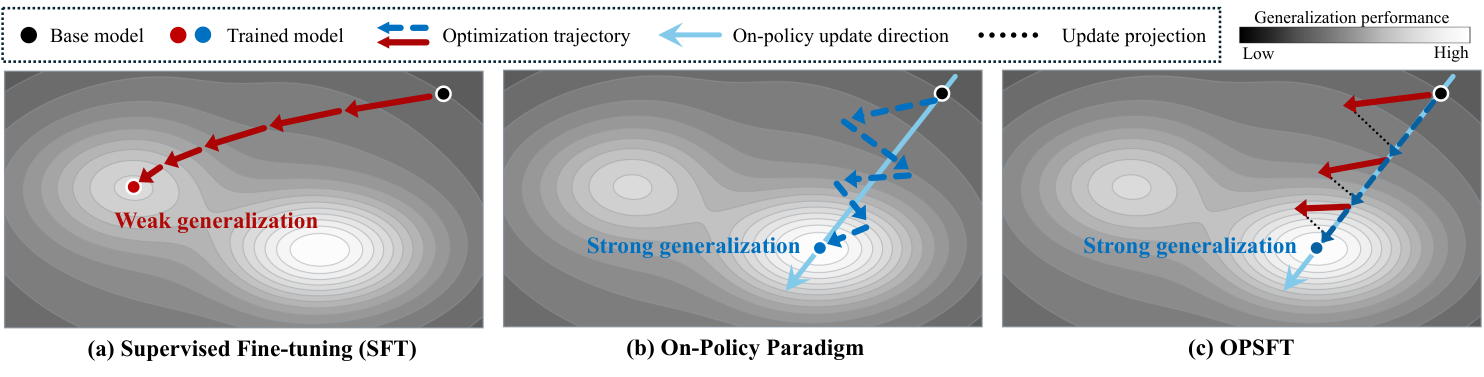
Figure 1 — SFT와 On-Policy Update 방향 비교 및 OPSFT 개념
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 저자들은 On-Policy Paradigm의 Cumulative Update Direction이 SFT의 Generalization Advantage를 Transfer할 수 있는 효과적인 Optimization Principle이 될 수 있음을 제안하며, 이를 검증하기 위해 OPSFT (On-Policy direction-constrained Supervised Fine-Tuning)를 도입한다. OPSFT는 On-Policy Paradigm(예: GRPO)으로 식별된 Cumulative Update Direction (𝜽on−𝜽base의 sign vector)에 SFT의 Parameter Updates를 제약한다. 즉, SFT Gradient가 이 방향과 일치하지 않는 경우 해당 Gradient 요소를 Masking하고, Optimizer Step 이후에도 Parameter의 Cumulative Displacement가 지정된 방향과 다른 경우 초기 값으로 복원하는 2단계 제약을 적용한다. [Listing 1].
실험 결과, OPSFT는 Qwen3-1.7B/4B/8B 및 DeepSeek-R1-Distill-Llama-3-8B 모델과 DeepMath, DAPO, Eurus-RL-Code 데이터셋에서 Vanilla SFT 대비 상당히 뛰어난 성능 향상을 보였으며, On-Policy Paradigm (GRPO)과 비슷한 수준의 Generalization 성능을 달성했다 [Figure 3]. 예를 들어, Qwen3-4B 모델에서 DeepMath 데이터셋으로 Training 시, OPSFT는 Vanilla SFT (34.22% Mean Accuracy)보다 높은 41.14%의 Mean Accuracy를 기록했으며, GRPO (38.96%)보다도 우수했다 [Table A11, Table 2]. 특히, Out-of-Domain 벤치마크 (IFEval, ARC, HaluEval 등)에서도 OPSFT는 Vanilla SFT와 GRPO를 능가하는 최고 Mean Accuracy (예: Qwen3-4B에서 74.11%)를 보였다 [Table 1]. 또한, OPSFT는 GRPO 대비 50% 이상 Training 시간을 단축하면서도 동등하거나 더 나은 성능을 달성하여 높은 Training Efficiency를 입증했다 [Table 2]. Parameter Precision 관련 Ablation Study에서는 FP32 환경에서 OPSFT가 GRPO와 유사한 약 9%의 Sparse Update를 유지하면서도, Vanilla SFT (약 90% Update)보다 우수한 성능을 보였다 [Table 6]. 이는 On-Policy Update Direction이 SFT의 Generalization Advantage를 효과적으로 Transfer할 수 있음을 강력히 시사한다.
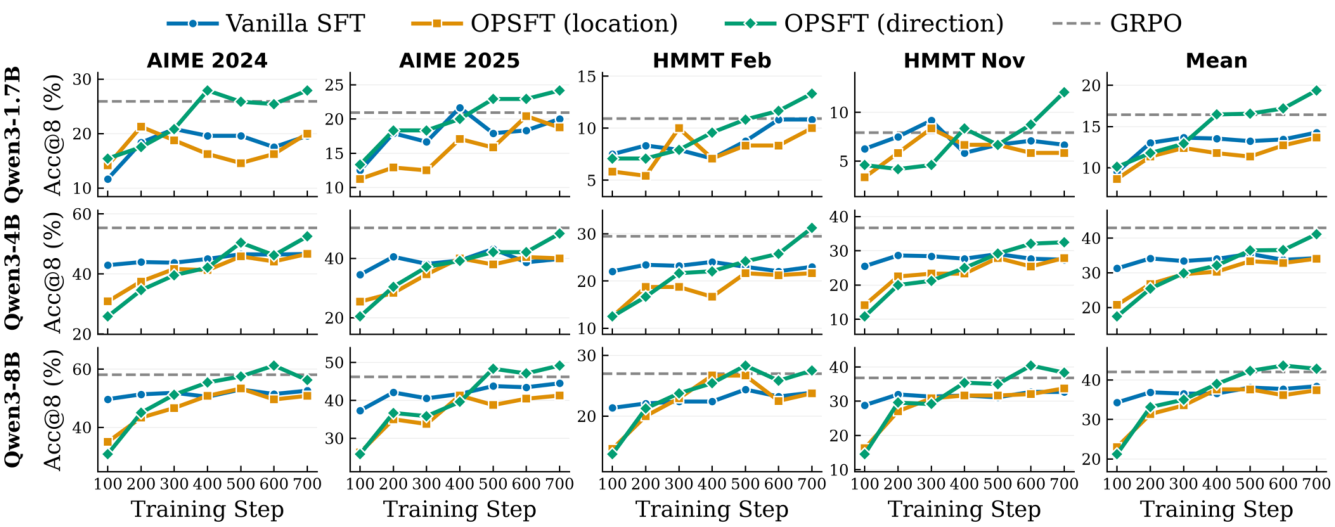
Figure 3 — 모델 및 벤치마크별 성능 비교
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 On-Policy Paradigm의 Parameter Update Direction이 LLM Post-Training의 Generalization 성능에 있어 핵심적인 역할을 한다는 것을 밝혔다. 특히, On-Policy Paradigm이 Training 중 Update Direction을 지속적으로 조정하는 경향이 있음을 이론적 및 실험적으로 분석했다. 이러한 통찰을 바탕으로 제안된 OPSFT는 SFT의 Parameter Update를 On-Policy Paradigm에서 식별된 Update Direction으로 제약함으로써, Vanilla SFT의 성능을 크게 뛰어넘고 On-Policy Paradigm과 유사한 Generalization 성능을 달성할 수 있음을 입증했다. 이 연구 결과는 "SFT는 Memorize하고 RL은 Generalize한다"는 기존 통념에 도전하며, On-Policy Update Direction이 SFT의 Generalization Capability를 향상시키는 효과적인 Optimization Principle임을 제시한다. 이는 On-Policy Paradigm의 강력한 Generalization과 SFT의 높은 Training Efficiency 및 고품질 Trajectory 활용 능력을 결합하여, LLM Post-Training Pipeline을 개선하는 데 중요한 시사점을 제공한다.
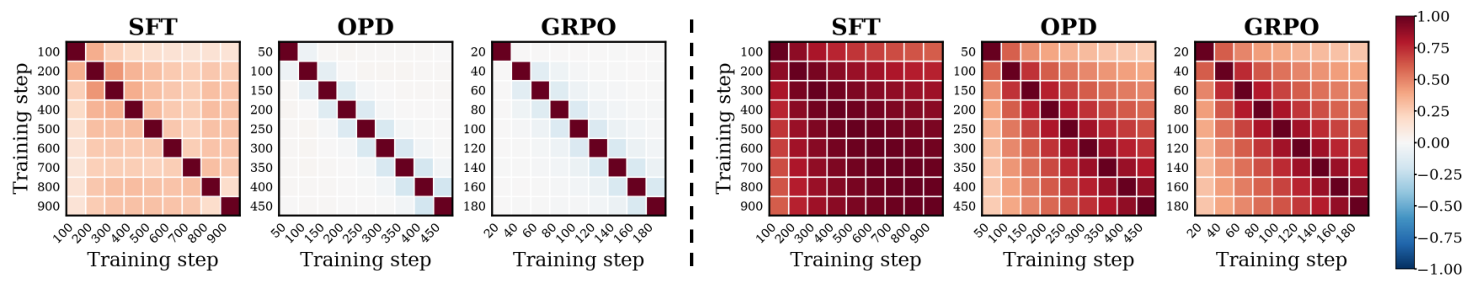
Figure 2 — SFT와 On-Policy Update 방향 유사성 비교
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] WorldCast: Exploring Intelligent Visual Generation in World State Prediction
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- [논문리뷰] Virtual Head Attention
- [논문리뷰] VLA-Δ: Learning Physical State Transition for Vision-Language-Action Models
Review 의 다른글
- 이전글 [논문리뷰] Native Action-Prior Learning from Videos for World Action Models
- 현재글 : [논문리뷰] On-Policy Parameter Update Direction Underlies Generalization in LLM Post-Training
- 다음글 [논문리뷰] PDE-JEPA: Predictive Representation Learning of Latent Dynamics Modeling for Parametric PDEs
댓글