[논문리뷰] Science or Slop?: Benchmarking and Mitigating Scientific Slop in AI-Generated Papers
링크: 논문 PDF로 바로 열기
저자: Yerim Oh, Young-Jun Lee, Jaewoo Ahn, Gunhee Kim, Dongyeop Kang et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Scientific Slop: 논문 내에서 과학적 추론의 연결이 반복적으로 실패하여 독자가 논문의 과학적 논리를 따라가기 어렵게 만드는 현상. 이는 텍스트의 표면적 품질과 내용의 실질적인 결함 사이의 간극을 의미한다.
- SciSlopBench: AI 생성 논문과 이에 매칭되는 인간 작성 논문을 비교하여 전체 논문(whole-paper) 수준에서 AI detection을 평가하기 위해 구축된 벤치마크. 이 벤치마크는 390쌍의 AI 및 인간 작성 논문으로 구성된다.
- SciSlopHarness: 과학적 slop을 줄이기 위해 LLM이 slop 진단을 반복적인 revision 가이드로 변환하고, 변경 사항을 실험 기록과 원고에 기반하여 검증하는 harness-level 프레임워크.
- Cross-section references: 논문의 다른 섹션에서 전혀 참조되지 않는 섹션 또는 레이블이 지정된 객체를 측정하여 구조적 연결 실패를 파악하는 slop measure.
- Macro redundancy: 이전 섹션에서 8-gram 단위로 절반 이상 복사된 문장을 측정하여 논문의 매크로 구조 내에서 중복성을 나타내는 slop measure.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 AI-generated content, 즉 AI slop이 학계를 포함한 여러 분야에서 증가하는 가운데, 특히 AI 생성 과학 논문의 slop이 기존의 token-based AI detector로는 쉽게 탐지할 수 없는 복잡한 패턴을 가진다는 문제에 주목한다. 이러한 논문은 각 부분이 개별적으로는 그럴듯해 보이지만, 부분들을 연결하는 과학적 추론이 붕괴되어 독자들이 작업을 평가하는 데 오해를 유발할 수 있다. 기존의 AI detection 방법론들은 주로 텍스트의 표면적인 특징이나 토큰 확률에 의존하여, 과학 논문에서 섹션, 주장, 인용, 증거, 아티팩트 간의 관계가 손상되는 것과 같은 전체 논문(whole-paper) 수준의 실패를 포착하기 어렵다는 한계를 가진다. 또한, 이러한 과학적 slop 패턴은 단순히 paraphrasing을 통해 제거될 수 없으며, 근본적인 과학적 내용을 변경하지 않고 누락된 관계를 복구해야 하므로 신뢰성 있는 방법으로 완화하기 어렵다는 과제를 안고 있다. 따라서 저자들은 과학적 추론의 연결 실패를 체계적으로 측정하고, 검증된 증거에 기반하여 완화할 수 있는 새로운 접근 방식의 필요성을 제기한다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 과학적 slop을 'STRUCTURE', 'ARGUMENT', 'ARTIFACTS' 세 가지 영역에 걸쳐 과학적 추론 연결의 반복적인 실패로 정의하며, 이를 측정하기 위한 여섯 가지 지표를 제안한다. 이 지표들은 Cross-section references, Macro redundancy, Argument graph, Citation isolation, Figure exposition, Evidence gap으로 구성된다. 이러한 slop을 체계적으로 연구하기 위해, 저자들은 연구 문제 및 기여 유형별로 매칭된 390쌍의 AI-generated paper와 human-written paper로 구성된 전체 논문(whole-paper) 벤치마크인 SciSlopBench를 구축했다. 이 벤치마크는 AI 생성 논문의 slop 패턴을 인간 작성 논문과 비교 분석한다.
실험 결과, 제안된 과학적 slop 측정 지표는 AI 생성 논문을 인간 작성 논문과 구별하는 데 매우 효과적임을 입증했다. SciSlop은 PairAcc 0.859를 달성하여, 가장 강력한 token-level 탐지기인 Binoculars의 0.687 대비 탐지 에러율을 55% 감소시켰다. 특히, 개별 측정치 중 Cross-section references는 PairAcc 0.905를 기록하며 AI 논문 65%를 5% FPR에서 식별했다. 이는 기존 token-level 검출기가 읽지 못하는 "전체 논문"의 관계를 측정함으로써 가능하다. 또한, 과학적 slop 측정치는 인간 평가와 높은 상관관계를 보여, ICLR 리뷰 점수가 낮을수록, 그리고 불합격 논문일수록 높은 slop 점수를 보였다.
slop 완화를 위해 저자들은 SciSlopHarness라는 harness-level 프레임워크를 제안한다. 이는 slop 진단을 LLM의 반복적인 revision 가이드로 변환하고, 제안된 변경 사항을 원고 및 실험 기록에 기반하여 엄격하게 검증하는 방식으로 작동한다. SciSlopHarness는 모든 6가지 측정 지표에서 인간 수준에 가장 근접하게 slop을 감소시켰으며, 가장 강력한 revision baseline인 Claude Code 대비 AI-human gap을 63% 줄이는 효과를 보였다. 이는 human reference target 없이 달성되었으며, 일반적인 revision 방식이 남기는 slop과 직접적인 slop-aware revision이 유발하는 보상 해킹(reward hacking) 문제를 효과적으로 해결한다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 과학적 slop을 논문의 각 부분을 연결하는 과학적 추론의 측정 가능한 붕괴로 정의하고, 이러한 slop이 AI 생성 논문의 특징적인 약점임을 성공적으로 입증했다. 제안된 SciSlop 측정치는 AI 생성 논문을 인간 작성 논문과 효과적으로 구별할 뿐만 아니라, ICLR 리뷰의 soundness, presentation, contribution, overall rating 등 네 가지 평가 차원 모두에서 낮은 점수와 유의미하게 연관되어, 인간 평가가 간과할 수 있는 논문의 구조적, 논증적 약점을 명시적이고 정량적으로 분석할 수 있는 기반을 제공한다. 또한, SciSlopHarness는 식별된 결함을 활용하여 논문 자체의 실험 결과 및 코드와 같은 과학적 기록을 기반으로 검증된 revision을 안내함으로써, 기존 방법론보다 훨씬 효과적으로 slop을 완화하고 human-level에 근접하게 한다. 이 연구는 AI 생성 과학 논문이 전체적인 추론 연결 방식에 근본적인 흔적을 남기며, 책임감 있는 완화는 단순한 텍스트 개선을 넘어 엄격한 증거 기반의 grounding이 요구됨을 강력히 시사한다. 이는 학계에서 AI의 책임감 있는 활용 및 평가 기준 강화에 중요한 기여를 할 것으로 기대된다.
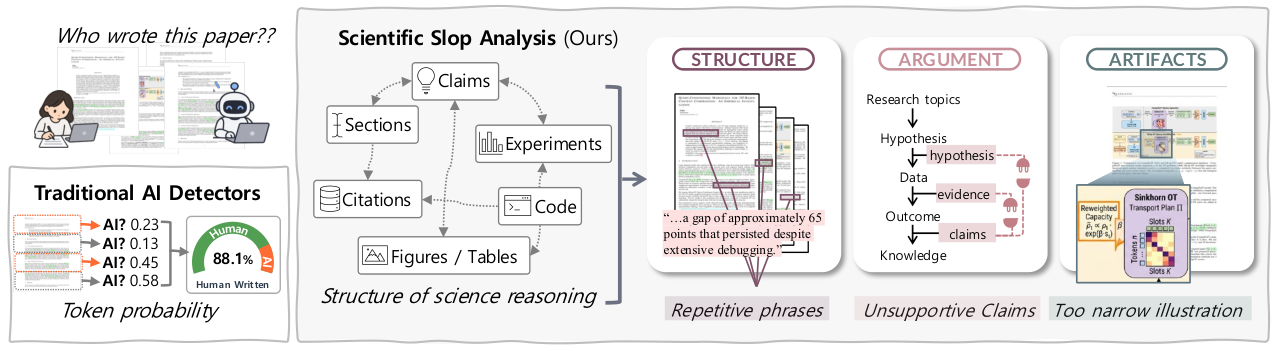
Figure 1 — 과학적 슬롭의 개념
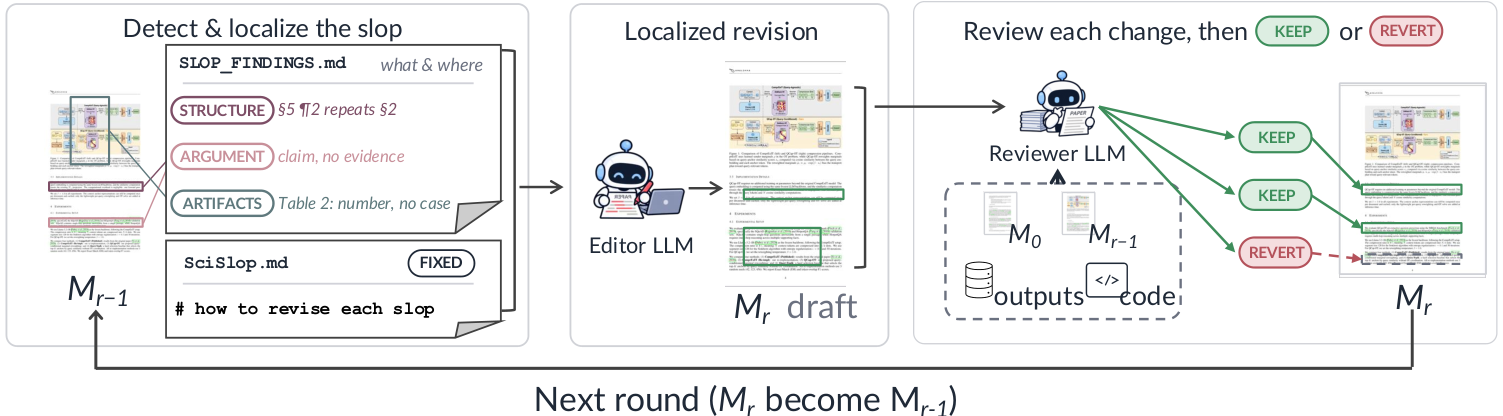
Figure 3 — SciSlopHarness 파이프라인
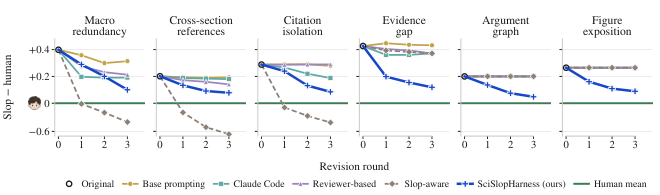
Figure 5 — 슬롭 완화 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Sci-VBench: Evaluating Knowledge- and Reasoning-Intensive Video Generation in Science Domains
- [논문리뷰] ATLAS: A High-Difficulty, Multidisciplinary Benchmark for Frontier Scientific Reasoning
- [논문리뷰] ExpVid: A Benchmark for Experiment Video Understanding & Reasoning
- [논문리뷰] CMPhysBench: A Benchmark for Evaluating Large Language Models in Condensed Matter Physics
- [논문리뷰] Orbia: Do Generated Videos Form a Consistent 3D World?
Review 의 다른글
- 이전글 [논문리뷰] Science Utopia? Closed-Loop LLM Simulation of Academic Research Ecosystems
- 현재글 : [논문리뷰] Science or Slop?: Benchmarking and Mitigating Scientific Slop in AI-Generated Papers
- 다음글 [논문리뷰] SimuVerity: Benchmarking Agents for Engineering-Grade Simulink Model Generation
댓글