[논문리뷰] SimuVerity: Benchmarking Agents for Engineering-Grade Simulink Model Generation
링크: 논문 PDF로 바로 열기
저자: Ruiqi Zhang, Jiahao Wang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
본 논문에서 다루는 핵심 용어 및 정의는 다음과 같습니다.
- Simulink: MATLAB 환경 내에서 동적 시스템의 모델링, 시뮬레이션, 분석 및 제어를 위한 그래픽 기반의
Model-Based Design환경. - Engineering-Grade: 단순히 모델이 실행되는 것을 넘어, 특정
engineering requirements및 운영 조건에 따라 정확하고 견고하며 신뢰할 수 있는 성능을 제공하는 모델의 품질 수준을 의미합니다. - Executable-System Profile: 참조 시스템의
native run을 통해 도메인 전문가가 구축한 프로파일로, 시스템 경계, 인터페이스,engineering relations,operating ranges, 및dynamics를 포착합니다. - Prerequisite Gates:
SimuVerity평가 프레임워크의 초기 단계로, 모델이multidimensional performance evaluation으로 진행하기 전에 반드시 통과해야 하는 세 가지 검사(Artifact Delivery, Native Executability, Engineering Qualification)입니다. - Multidimensional Performance Evaluation:
SimuVerity의 핵심 평가 방식으로,Accuracy(A),Output Quality(Q),Mechanistic Fidelity(M),Control and Causal Integrity(C),Operating-Domain Robustness(R),Dynamic Response and Recovery(D)의 여섯 가지engineering dimensions에 걸쳐 모델의 성능을 정량적으로 측정합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 LLM-based agents가 natural-language requirements로부터 executable .slx models를 생성하는 능력이 발전함에도 불구하고, 기존 Simulink benchmarks가 engineering-grade 모델 생성 여부를 적절히 평가하지 못하는 핵심 문제를 해결하고자 합니다. 기존 벤치마크들은 주로 생성된 모델이 컴파일되거나 실행되는지, 또는 참조 모델과 구조적으로 유사한지를 평가하는 데 그쳤습니다. 그러나 이러한 기준은 모델이 실제 engineering requirements를 만족하는지 여부를 검증하지 못하는 한계가 있습니다. 예를 들어, artifact delivery 및 technical execution 기준은 모델이 존재하고 실행됨만을 확인할 뿐, engineering requirements를 충족하는지 여부는 검증하지 못합니다. 또한, structural and functional similarity에 의존하는 방식은 유효한 구조적 대안이 존재하거나 참조 모델 자체에 오류가 있을 수 있다는 점을 간과합니다. 따라서 저자들은 task-specific native simulation scenarios와 multidimensional performance criteria를 통해 engineering requirements에 대한 후보 모델의 준수 여부를 평가하는 cross-domain benchmark의 필요성을 제기합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 engineering-grade Simulink model generation의 benchmarking을 위해 SimuVerity라는 새로운 native-simulation benchmark를 제안합니다. SimuVerity는 10개 engineering domains에 걸친 101개 text-to-executable Simulink model-generation tasks로 구성됩니다. 각 task는 executable-system profile과 4가지 families의 task-specific simulation scenarios를 포함하며, 이들은 operating-envelope, interaction and fault, temporal-process, mechanism and causal-check scenarios입니다.
평가는 hierarchical multidimensional performance evaluation framework를 따릅니다. 먼저, 모델은 세 가지 Prerequisite Gates를 통과해야 합니다: artifact delivery, native executability, 그리고 engineering qualification (G-pass). 이 게이트들을 통과한 모델만이 6가지 engineering dimensions (A: Accuracy, Q: Output Quality, M: Mechanistic Fidelity, C: Control and Causal Integrity, R: Operating-Domain Robustness, D: Dynamic Response and Recovery)에 걸쳐 점수를 부여받습니다 [Figure 2, 3].
SimuVerity로 6개 agent systems을 평가한 결과, Opus 4.8 + Claude Code가 42.86점으로 가장 높은 overall score를 기록했습니다 [Table 2]. 하지만 이는 engineering requirements를 완전히 충족하는 수준에는 크게 못 미치는 결과입니다. 가장 좋은 성능을 보인 에이전트의 artifact delivery 성공률은 94.72%, native executability는 86.47%, engineering qualification (G-pass) 성공률은 76.90%였습니다 [Table 2]. 이는 단순히 모델을 생성하고 실행하는 것을 넘어 qualified engineering implementation을 만드는 데 어려움이 있음을 시사합니다. 또한, structural similarity가 engineering performance의 신뢰할 수 있는 척도가 아님을 발견했습니다 [Table 4]. Reference-Aligned 모델 중에서도 engineering requirements를 충족하지 못해 0점을 받은 경우가 있었으며, Structurally Distinct 모델도 높은 점수를 기록하는 valid structural diversity가 관찰되었습니다. 흥미롭게도, 높은 engineering performance를 달성한 모델 중 상당수 (31개 중 8개)가 visual-layout disorder를 보였습니다 [Figure 4]. ablation studies를 통해 native simulation feedback과 MCP (MATLAB/Simulink Command Processor) tool access가 executable Simulink models의 안정적인 생성에 결정적인 역할을 한다는 점이 확인되었습니다 [Table 5].
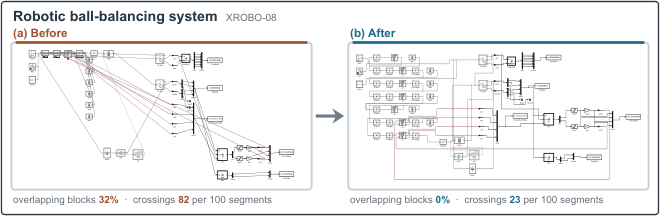
Figure 4 — 레이아웃 최적화 전후 비교
4. Conclusion & Impact (결론 및 시사점)
본 연구는 engineering-grade Simulink model generation을 위한 SimuVerity 벤치마크를 제시하며, native simulation과 6가지 engineering dimensions에 기반한 hierarchical multidimensional performance evaluation을 수행했습니다. 6개 agent systems에 대한 평가 결과, 최고 성능의 에이전트조차 overall score가 42.86점에 불과하여 engineering qualification 및 그 이후의 multidimensional performance 모두에서 bottlenecks가 존재함을 보여주었습니다. Structural similarity는 engineering quality를 신뢰성 있게 반영하지 못하며, high-scoring models조차 disordered layouts를 가질 수 있음이 밝혀졌습니다. Tool ablations는 simulation feedback과 MCP access의 중요성을 강조합니다. SimuVerity는 에이전트의 engineering capabilities를 체계적으로 평가하고 executable model generation 과정에서의 실패 원인을 진단하는 기반을 제공하며, closed-loop specification-driven modeling, native simulation validation, multi-condition feedback correction을 통한 Simulink model-generation performance 향상을 위한 empirical foundation을 마련했다는 시사점을 가집니다.
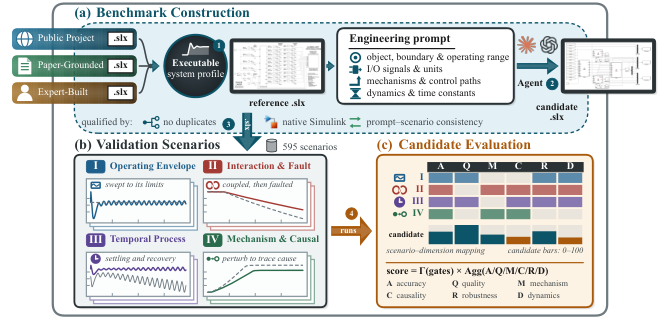
Figure 2 — SimuVerity 벤치마크 파이프라인
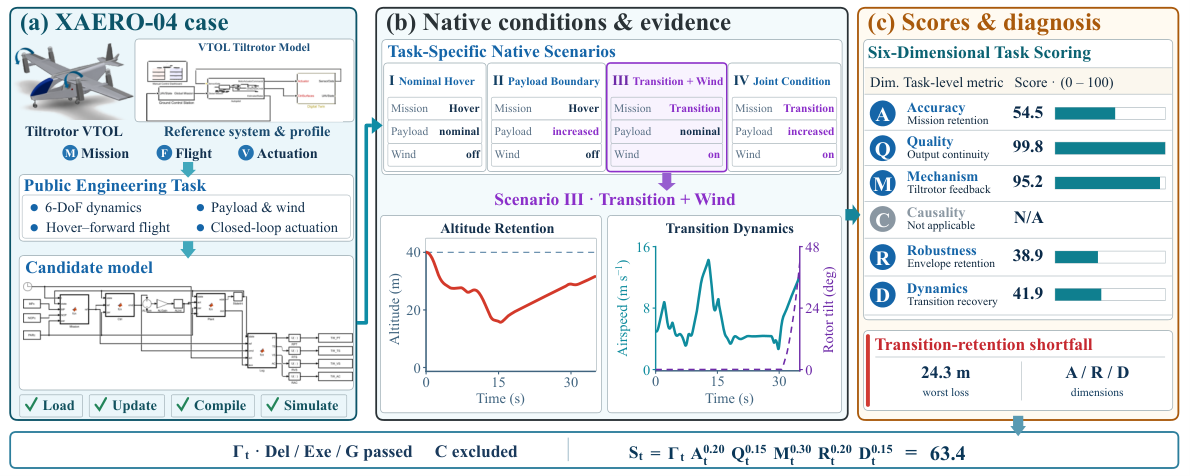
Figure 3 — 틸트로터 VTOL 모델 평가 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] WorldCast: Exploring Intelligent Visual Generation in World State Prediction
- [논문리뷰] Waypoint-OPD: Transferring RL-Induced Policy Shifts via Gated On-Policy Distillation
- [논문리뷰] Virtual Head Attention
- [논문리뷰] VLA-Δ: Learning Physical State Transition for Vision-Language-Action Models
Review 의 다른글
- 이전글 [논문리뷰] Science or Slop?: Benchmarking and Mitigating Scientific Slop in AI-Generated Papers
- 현재글 : [논문리뷰] SimuVerity: Benchmarking Agents for Engineering-Grade Simulink Model Generation
- 다음글 [논문리뷰] Skill2Real: Agentic Skill Learning for Zero-Shot Sim-to-Real Robot Manipulation
댓글