[논문리뷰] LMBuild: Evaluating LLM Agents for Generating Buildable and Functional Structures
링크: 논문 PDF로 바로 열기
본 논문은 LLM 기반 에이전트가 물리적으로 구축 가능하고(buildable) 기능적인(functional) 3D 구조를 생성하는 능력을 체계적으로 평가하기 위한 벤치마크 프레임워크인 LMBuild를 제안한다.
메타데이터
저자: Jiateng Liu, Rushi Wang, Cheng Qian, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- LMBuild: 생성된 구조의 구조적 건전성, 기능적 효용성, 설계 품질 및 물리적 실현 가능성을 평가하기 위한 계층적 평가 프레임워크이자 벤치마크이다.
- Functional Affordance: 구조체가 의도된 목적을 수행하기 위해 필요한 부품, 관절(joints), 운동학적(kinematic) 특성을 적절히 갖추고 있는지 평가하는 개념이다.
- Physical Realization: 생성된 디자인이 실제 제작 가능성, 조립 순서의 타당성, 그리고 실제 물리 환경에서 운용 가능한지를 평가하는 지표이다.
- Interactive Generation: 에이전트가 도구(tool-use)를 활용하여 부품을 검색(retrieval), 생성(creation), 배치(placement)하는 일련의 상호작용 과정을 의미한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 3D 생성 모델들이 주로 기하학적(geometric) 정교함이나 시각적 품질에만 집중하고 있으며, 실제 물리 세계에서 구축 가능하고 작동하는 구조를 만드는 능력은 부족하다는 문제의식에서 출발한다. 시각적으로 그럴듯해 보이는 구조체라도 실제로는 불안정하거나 제작이 불가능한 경우가 많지만, 이를 체계적으로 평가할 기준이 부재하다. 따라서 저자들은 에이전트의 지식과 추론 능력이 실질적인 구축 가능한 구조 생성으로 이어지는지를 정량적으로 측정하고자 한다. [Figure 1]은 LMBuild의 전체 프레임워크를 보여준다.
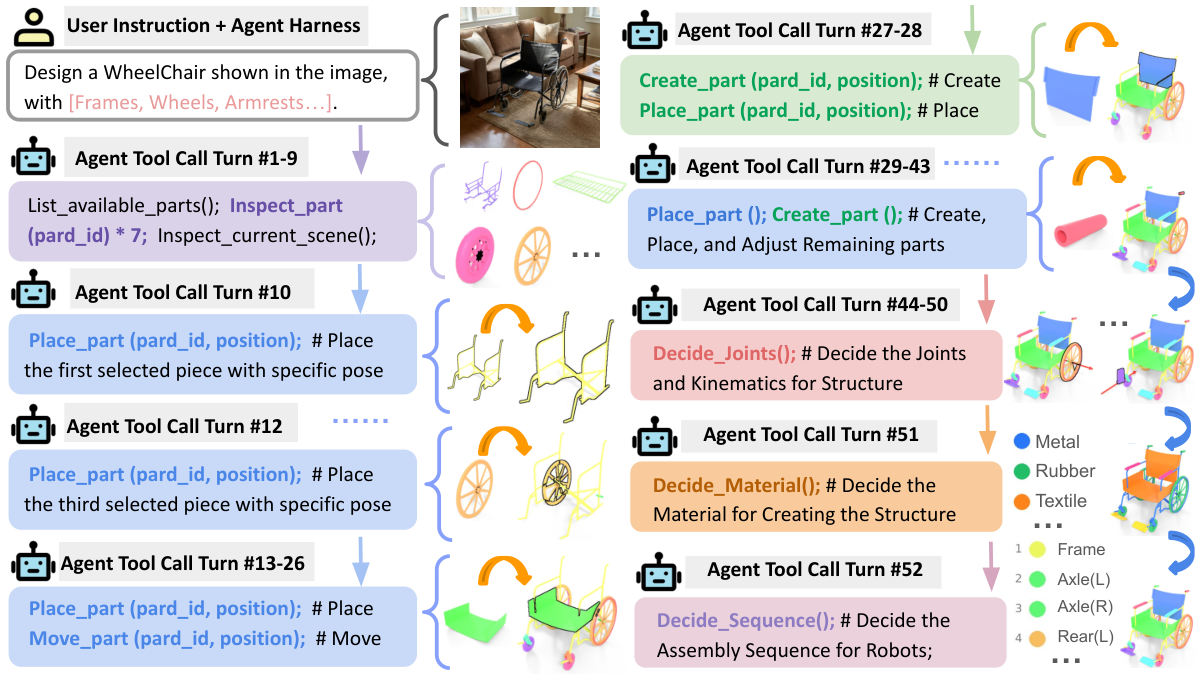
Figure 1 — LMBuild 에이전트 프레임워크
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 연구는 LMBuild 프레임워크를 통해 LLM 에이전트가 3D 환경에서 도구를 사용하여 부품을 조립하고, 설계의 타당성을 평가하는 체계적인 구조를 제공한다. 평가 프레임워크는 구조적 건전성, 기능적 효용성, 설계 품질, 물리적 실현 가능성이라는 4가지 차원의 계층적 구조로 구성된다. 실험은 30개의 다양한 모델(proprietary APIs, open-source LLMs, domain-specific systems)을 대상으로 수행되었다.
주요 실험 결과는 다음과 같다:
- Structural Soundness와 시각적 정렬(visual alignment)은 최첨단 폐쇄형(closed-source) 모델에서 더 이상 주요한 병목 현상이 아니다.
- 반면, Functional Affordance와 물리적 운용 능력(physical operability)은 여전히 모든 모델군에서 큰 성능 격차를 보이는 가장 도전적인 영역이다.
- 강력한 모델들은 부품 생성(part creation) 능력을 효과적으로 활용하지만, 상대적으로 약한 모델들은 부품 검색(retrieval)에 의존하며, 생성에 필요한 복잡한 추론 과정에서 어려움을 겪는다.
- 명시적인 기능적 사양(functional specifications)을 프롬프트에 추가할 경우, 부품 완성도와 운동학적 정확도가 크게 향상됨을 확인하였다.
- [Table 1]은 LMBuild에 사용된 데이터셋의 통계를 나타내며, [Figure 2]는 제안된 방법론에 따른 생성 예시와 평가 과정을 보여준다.
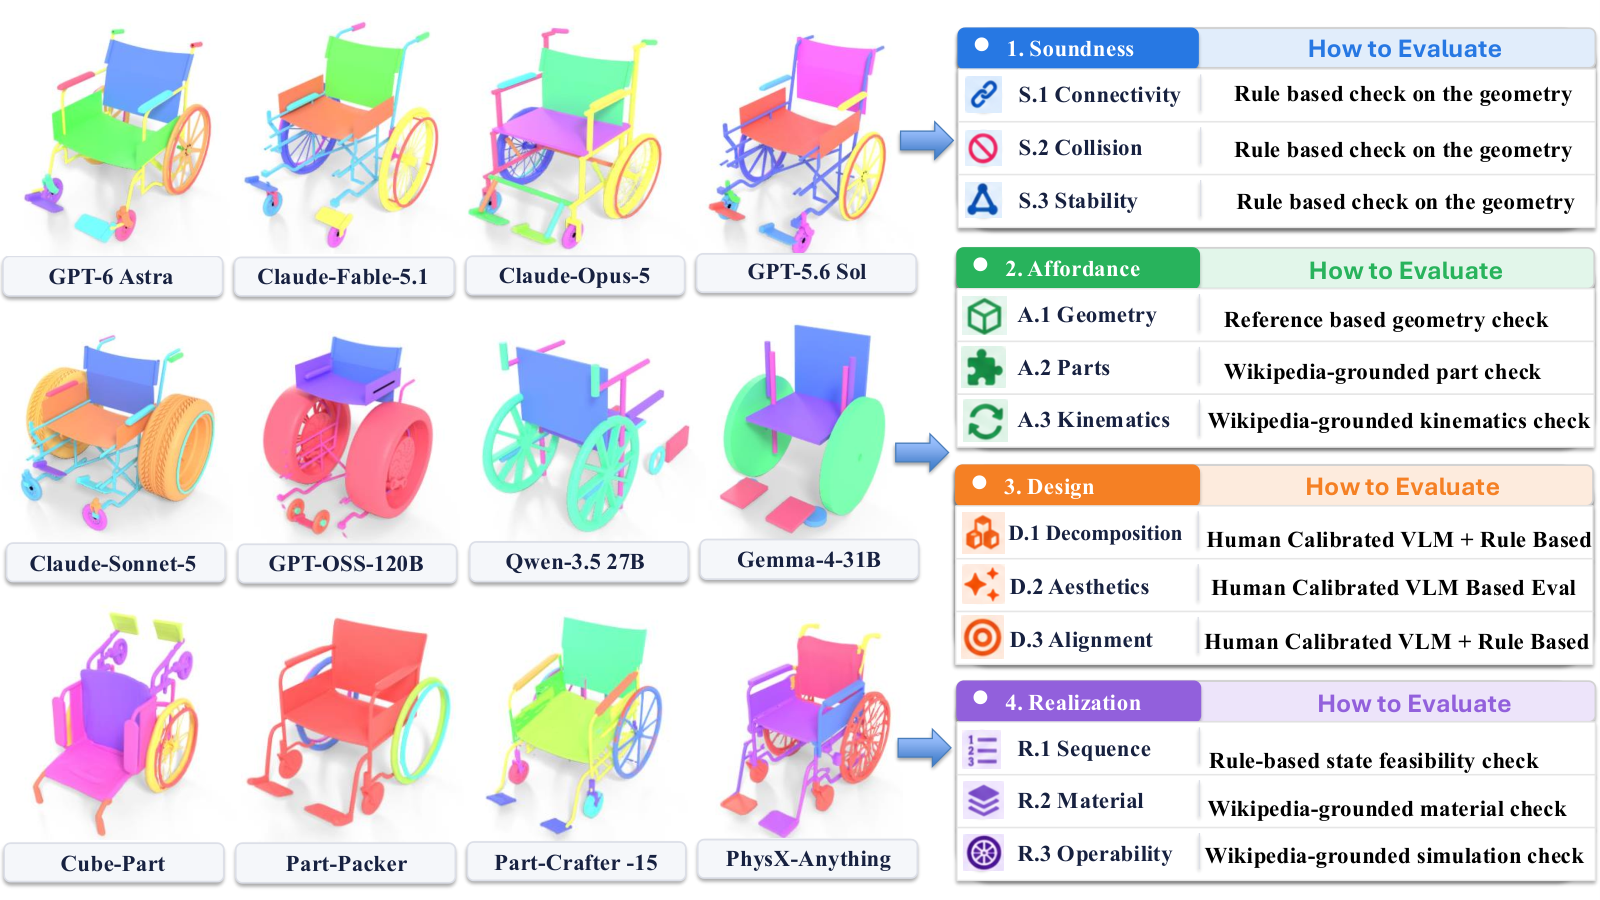
Figure 2 — 생성 예시 및 평가 프로세스
4. Conclusion & Impact (결론 및 시사점)
본 논문은 생성형 AI가 단순한 3D 시각 자산을 넘어 실질적으로 구축 가능한 기계 및 구조물을 설계하는 단계로 나아가기 위한 핵심적인 평가 기준을 마련하였다. LMBuild는 에이전트의 물리적 추론 및 설계 역량을 진단하는 표준으로 기능하며, 특히 폐쇄형 모델과 오픈소스 모델 간의 격차를 명확히 함으로써 후속 연구의 방향성을 제시한다. 이 연구는 로봇 공학 및 디지털 제조 분야에서 LLM 에이전트의 활용도를 높이는 데 기여할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Learn2Play Bench: How Well Do LLM Agents Learn from Experience in Unfamiliar Environments?
- [논문리뷰] A Closer Look at Agentic BBO: Benchmarking LLM Agents for Black-Box Optimization
- [논문리뷰] DecepEval: A Benchmark for Evaluating Deception in LLM Agents
- [논문리뷰] SchemeArena: Factorized Stress Testing of Scheming in LLM Agents
- [논문리뷰] HarvestBench: Measuring Whether LLM Agents Will Pay to Avoid Killing Animals
Review 의 다른글
- 이전글 [논문리뷰] Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
- 현재글 : [논문리뷰] LMBuild: Evaluating LLM Agents for Generating Buildable and Functional Structures
- 다음글 [논문리뷰] Learning to Learn a Language
댓글