[논문리뷰] Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
링크: 논문 PDF로 바로 열기
저자: Julia Agafonova, Bulat Akhmatov, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Kandinsky 6.0 Video: 동기화된 Text-to-Audio-Video (T2AV) 및 Image-to-Audio-Video (I2AV) 생성을 위한 foundation diffusion model 제품군으로, Lite (3B parameters)와 Pro (29B parameters) 버전으로 제공된다.
- CrossDiT Architecture: Kandinsky 5.0에서 계승 및 확장된 듀얼 스트림(video, audio) Diffusion Transformer 네트워크로, bidirectional cross-attention을 통해 두 모달리티를 연결하여 temporal 및 semantic alignment를 달성한다.
- T2AV (Text-to-Audio-Video): 텍스트 프롬프트로부터 audio와 video를 동시에 생성하는 모드를 지칭한다.
- I2AV (Image-to-Audio-Video): 특정 이미지(reference frame)를 조건으로 사용하여 audio 및 video를 생성하는 모드를 의미한다.
- Super-Resolution (SR) Model: 생성된 SD (Standard Definition) 해상도 비디오를 Full-HD (1920x1080) 해상도로 업스케일링하는 별도의 모델로, Latent Upscaler (LU)와 SR-DiT로 구성된다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 이미지 합성에 효과적인 Diffusion Models 및 Flow Matching 방법론이 비디오 생성으로 확장되었음에도 불구하고, 오디오와 동기화된 비디오(T2AV)를 생성하는 것이 훨씬 더 어렵다는 핵심 문제를 해결하고자 한다. 이는 모달리티 간의 semantic, temporal, emotional consistency를 모두 요구하기 때문이다. 기존의 폐쇄형 상용 시스템(예: Veo 3.1, Sora 2)은 자연스러운 lip synchronization 및 동적 배경 사운드를 포함한 인상적인 결과를 보여주지만, 소스 코드가 공개되지 않아 재현성과 추가 연구가 제한되는 한계가 있다. 현재 오픈 소스 솔루션들은 클립 길이, 해상도, 동기화 정확도 측면에서 독점 시스템에 뒤처져 있어, 이 분야에서 새로운 접근 방식의 필요성이 제기되고 있다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
Kandinsky 6.0 Video는 기존 Kandinsky 5.0의 CrossDiT 아키텍처를 계승 및 확장한 듀얼 스트림 CrossDiT 네트워크를 기반으로, video 및 audio 모달리티를 처리한다. 핵심 방법론은 연속적인 Pre-training 전략을 포함하며, 이는 audio 스트림을 대규모 audio corpora에서 scratch부터 학습한 후, Pre-trained된 video 스트림과 cross-attention layer를 통해 연결하여 paired audio-video 데이터로 jointly training하는 방식이다. 이어서 supervised fine-tuning (SFT), Reinforcement Learning (RL) 기반 post-training, 그리고 2단계 distillation (π-Flow 및 adversarial refinement)을 거쳐 10 NFE (Network Function Evaluations)로 샘플링 스텝을 최적화한다. 또한, 생성된 비디오의 해상도를 Full-HD로 향상시키기 위해 Latent Upscaler (LU)와 SR-DiT로 구성된 Super-Resolution 모델을 사용한다. [Figure 5]는 이 다단계 Training Pipeline의 개요를 보여준다.
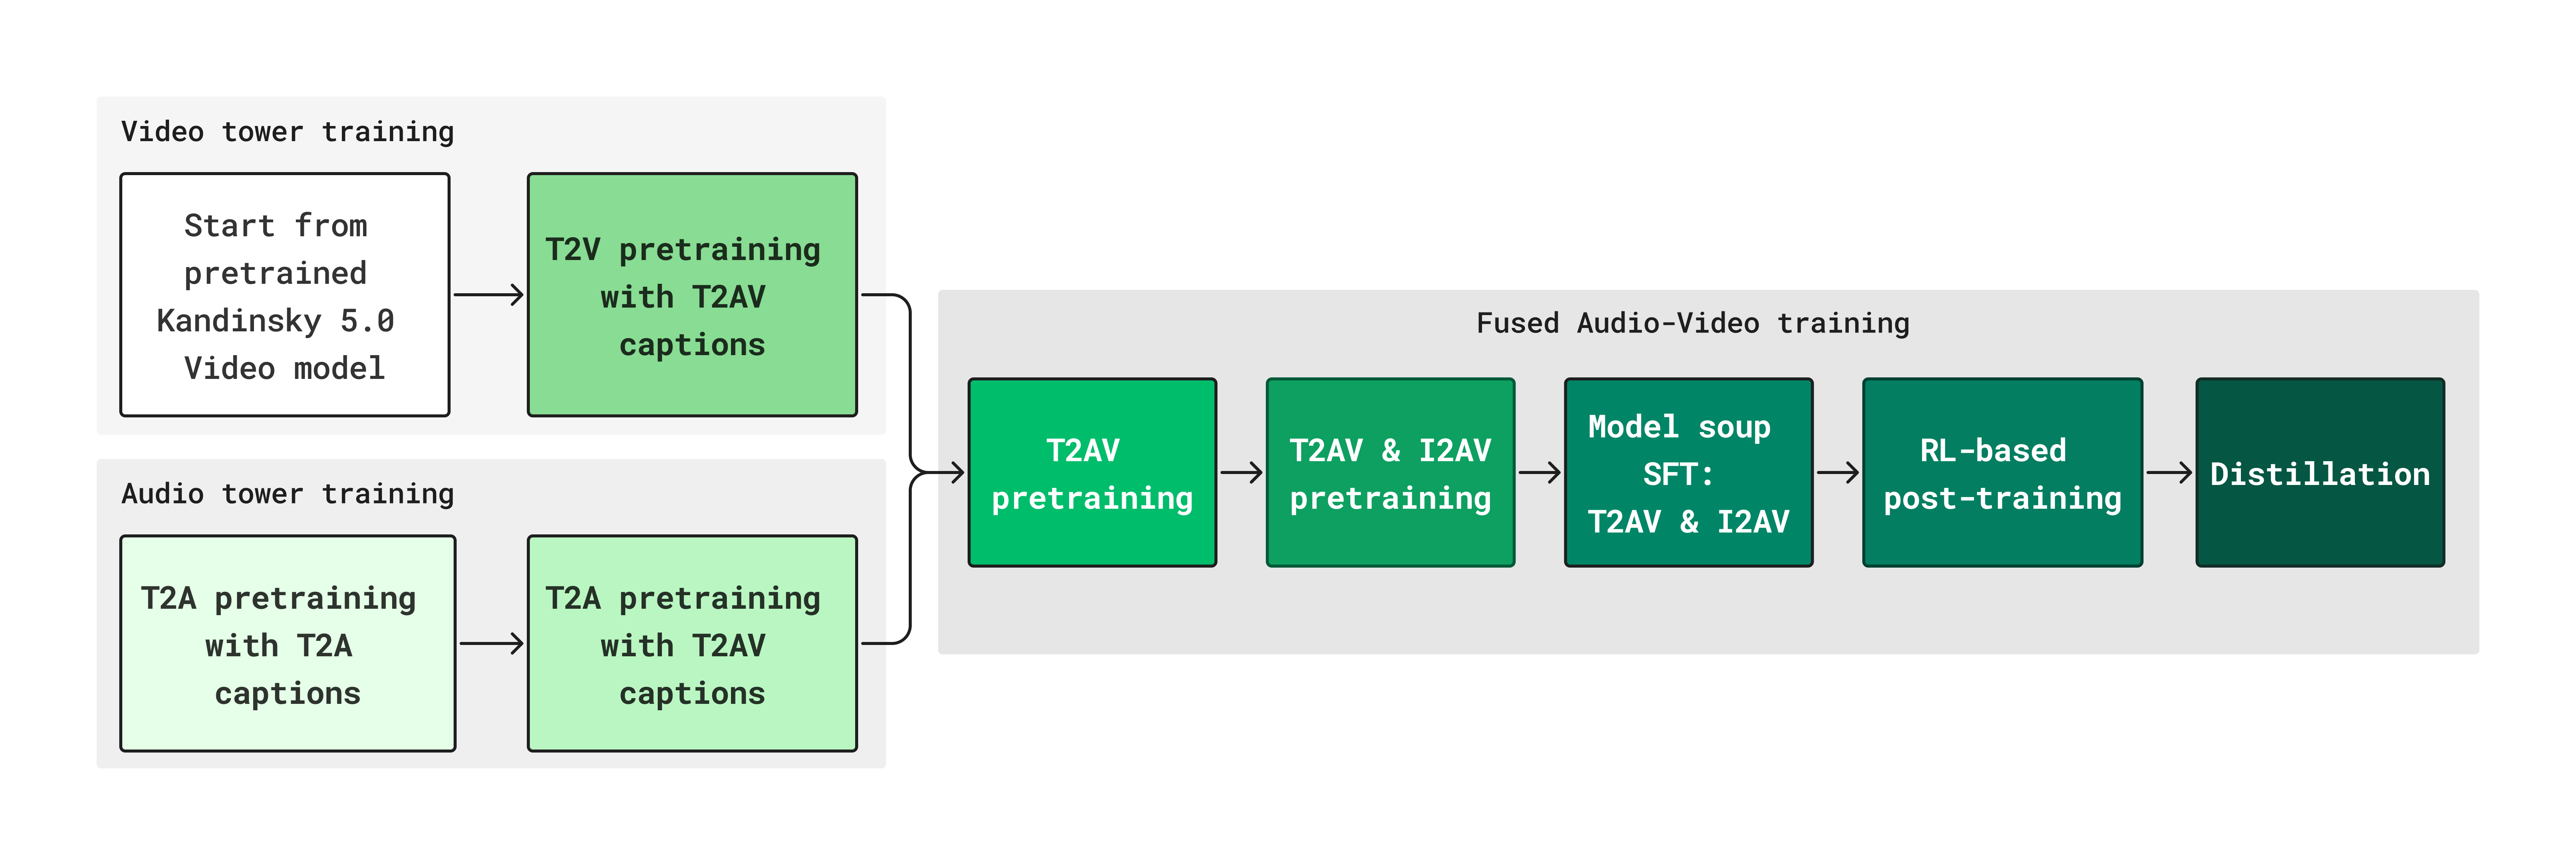
Figure 5 — 모델 학습 파이프라인
정량적 결과로는, VABench 벤치마크에서 Kandinsky 6.0 Video Pro는 평가된 모델 중 speech quality, audio aesthetics, text-video 및 audio-video alignment, lip-sync accuracy, desynchronization, visual realism 항목에서 가장 높은 점수를 달성했다 [Figure 14]. 특히, Reinforcement Learning post-training을 통해 Kandinsky 6.0 Video Pro의 speech benchmark에서 WER (Word Error Rate)이 0.235에서 0.124로 47% 감소하여, 음성 명료도가 크게 향상되었다. Human evaluation 결과, Kandinsky 6.0 Video Pro는 이전 버전인 Kandinsky 5.0 Video Pro를 모든 perceptual 및 semantic 기준에서 명확하게 능가하며 [Figure 15], LTX 2.5 대비 visual quality와 speech quality에서 우위를 보였다. Super-Resolution 모델은 LU (Latent Upscaler)가 pixel-space bilinear upsampling 대비 ×4 upscaling에서 1.30dB의 평균 PSNR 개선을 보였다 [Table 5].
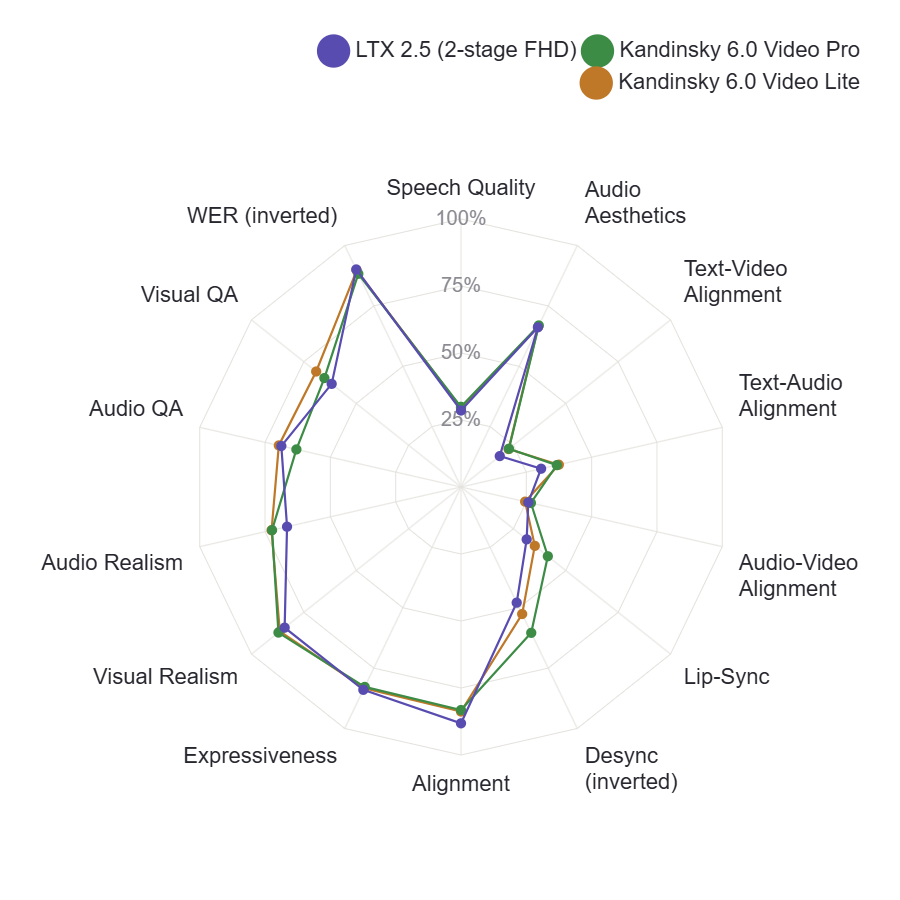
Figure 14 — VABench 벤치마크 결과
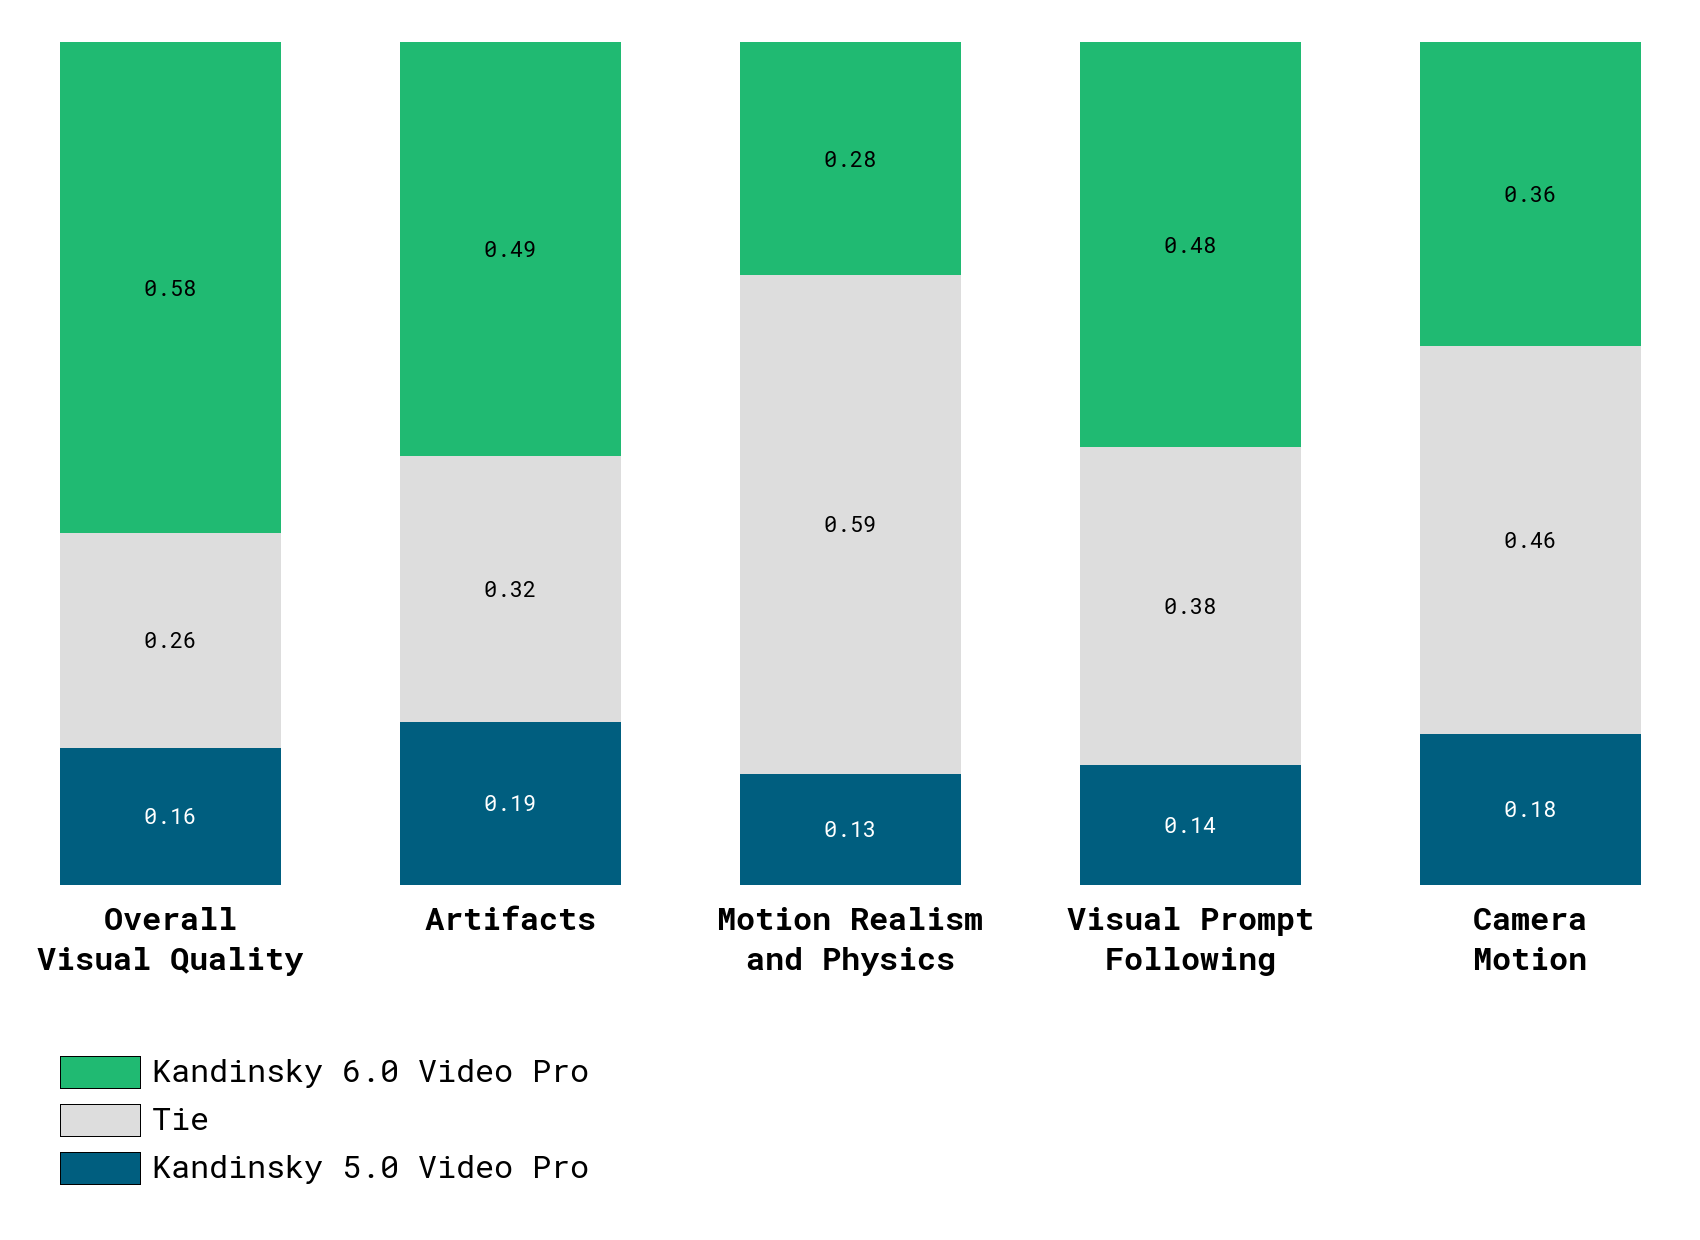
Figure 15 — K6 vs K5 비교
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Kandinsky 6.0 Video를 동기화된 Text-to-Audio-Video 및 Image-to-Audio-Video 생성을 위한 foundation diffusion model로서 제시하며, Lite (3B) 및 Pro (29B) 두 가지 버전으로 구성된다. 이 연구는 Pre-trained된 video 스트림과 scratch부터 학습된 audio 스트림을 blockwise bidirectional cross-attention으로 연결하는 듀얼 스트림 CrossDiT 아키텍처를 통해 audio-video 동기화의 복잡한 문제를 해결한다. VABench 벤치마크 및 human evaluation을 통해 speech quality, audio-video alignment, lip-sync accuracy 등 여러 지표에서 뛰어난 성능을 입증했으며, 특히 Reinforcement Learning을 통한 WER 47% 감소는 모델의 실용적 가치를 높였다. 또한, Full-HD 해상도 출력을 위한 Super-Resolution 모델과 consumer GPU 환경에서 모델 사용을 가능하게 하는 optimization 기술(block offloading)을 도입하여 광범위한 접근성을 제공한다. Kandinsky 6.0 Video는 오픈 소스로 코드를 공개함으로써, 멀티모달 생성 분야의 재현성을 높이고 후속 연구 및 산업적 활용에 크게 기여할 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] GroundGUI: GUI Grounding by High-Quality Data and Distillation-to-Reinforcement Learning
- [논문리뷰] Branching On-Policy Distillation
- [논문리뷰] SoL-Refiner: Speed-of-Light One-Step Refinement for High-Resolution Video
- [논문리뷰] AdaTutoRank: Learning to Rerank Document Sets via Adaptive Tutoring Optimization for RAG and Deep Research
- [논문리뷰] From Pretraining to Proficiency: Real-World Subtask RL for Long-Horizon Manipulation with Minimal Human Intervention
Review 의 다른글
- 이전글 [논문리뷰] In-Distribution Forcing for Long Video Generation at Test Time
- 현재글 : [논문리뷰] Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
- 다음글 [논문리뷰] LMBuild: Evaluating LLM Agents for Generating Buildable and Functional Structures
댓글