[논문리뷰] In-Distribution Forcing for Long Video Generation at Test Time
링크: 논문 PDF로 바로 열기
메타데이터
저자: Jeongwoo Shin, Youngyoon Choi, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- KV-provenance problem: 생성된 각 청크의 KV 엔트리가 학습 과정에서 한 번도 경험하지 못한 문맥(provenance)을 바탕으로 구성되어, 추론 시 out-of-distribution(OOD) 상태가 되는 현상.
- Self-Caching: KV 엔트리가 생성될 때 이전 청크에 의존하지 않거나 학습 시 실행된 구성만을 따르도록 강제하여, KV 상태를 항상 in-distribution으로 유지하는 핵심 메커니즘.
- Drifting: autoregressive 비디오 생성 모델에서 생성 길이가 길어질수록 색상, 텍스트의 변화(shift)와 모션 다이내믹스의 감쇠(decay)가 발생하는 품질 저하 현상.
- KV conditioning: 이전 단계에서 생성된 KV 엔트리를 현재 청크 생성 시 참조하는 과정으로, 기존 방식은 단순히 윈도우 크기를 고정하는 방식에 의존하여 드리프트를 유발함.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 연구는 고품질 비디오 생성을 위한 autoregressive 모델이 훈련 범위를 벗어난 장기 생성 시 발생하는 drifting 문제를 해결하기 위해 고안되었습니다. 기존 연구들은 KV conditioning 전략을 수정하여 drifting을 완화하려 시도했으나, 이는 생성된 KV 엔트리 자체가 OOD가 될 수 있다는 근본적인 원인을 간과하고 있습니다. 즉, 훈련 시의 롤아웃 조건과 추론 시의 롤아웃 조건이 불일치하면서 발생하는 KV-provenance 문제가 모델의 안정성을 떨어뜨리는 핵심 원인임을 [Figure 2]를 통해 지적합니다. 단순한 윈도우 크기 고정만으로는 이러한 드리프트를 근본적으로 차단할 수 없으므로, 저자들은 테스트 타임에 KV 운영 방식을 훈련 분포와 정렬하는 새로운 프레임워크가 필요하다고 제안합니다.
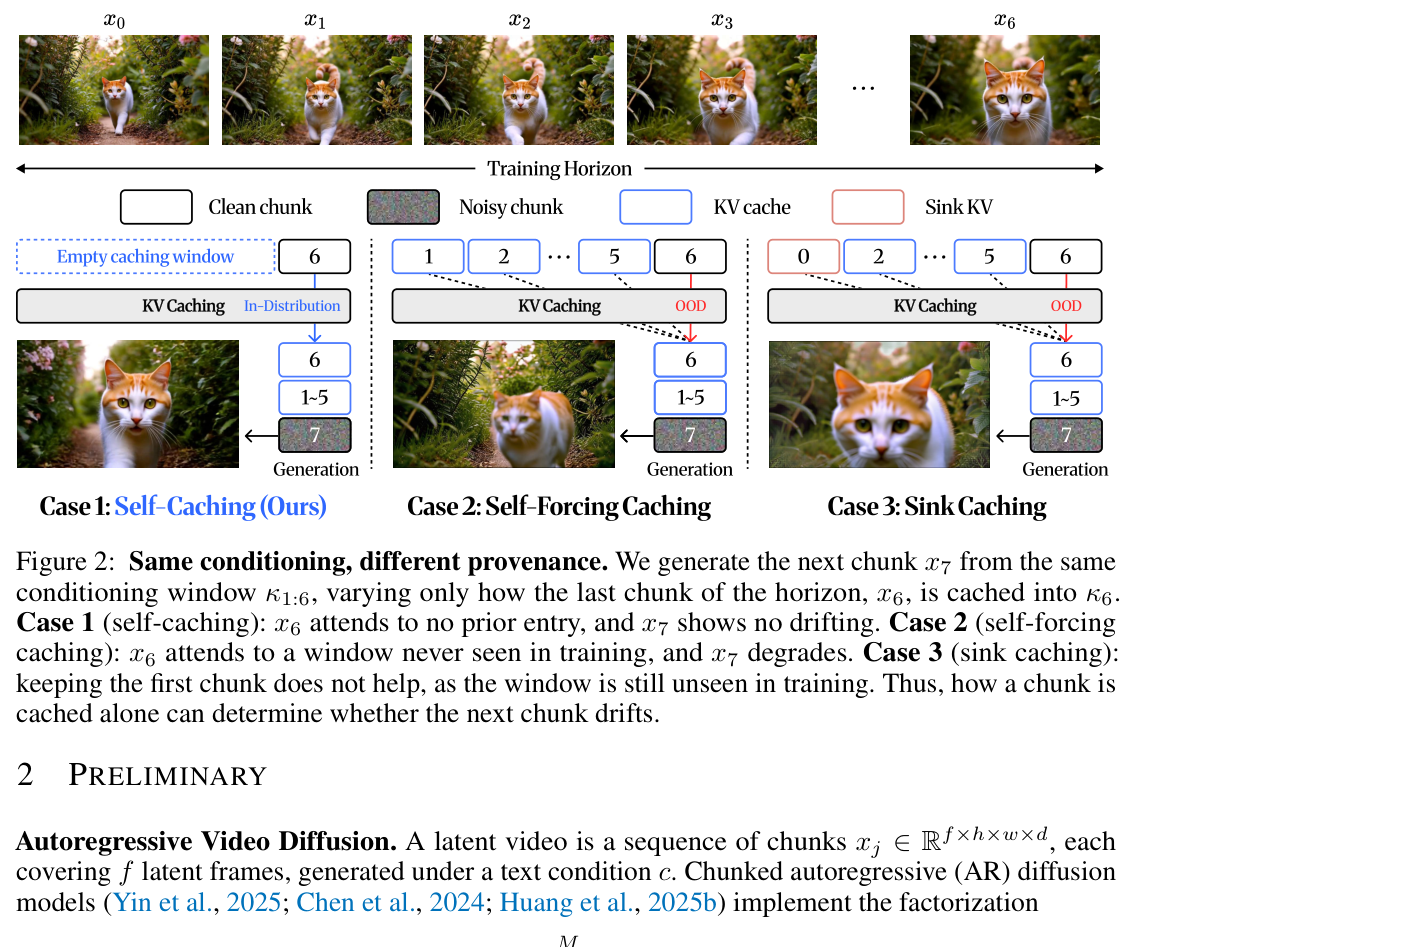
Figure 2 — KV-provenance 문제의 핵심 발생 원리를 설명하는 다이어그램
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 논문은 KV caching과 KV conditioning의 두 수준에서 훈련 분포를 강제하는 ID-Forcing 프레임워크를 제안합니다. Self-Caching 기법을 통해 KV 엔트리 생성 시 OOD provenance 생성을 원천 차단하며, first-chunk sink와 re-rotation 전략을 통해 추론 시의 모든 temporal 관계가 훈련 시의 조건과 일치하도록 조정합니다. 실험 결과, ID-Forcing은 Self-Forcing 및 LongLive 베이스 모델 위에서 120초 및 240초 비디오 생성 시 일관되게 높은 성능을 보였습니다. 특히 정량적 지표인 Dynamic Degree에서 최상위 점수를 기록하며 모션 감쇠 현상을 효과적으로 억제함을 확인했습니다 [Table 1]. 또한, Color Drift와 Motion Drift 등 드리프트 특화 지표에서 기존 baseline 기법들 대비 압도적인 개선을 달성하였으며, 사용자 평가에서도 일관되게 우수한 선호도를 입증했습니다.
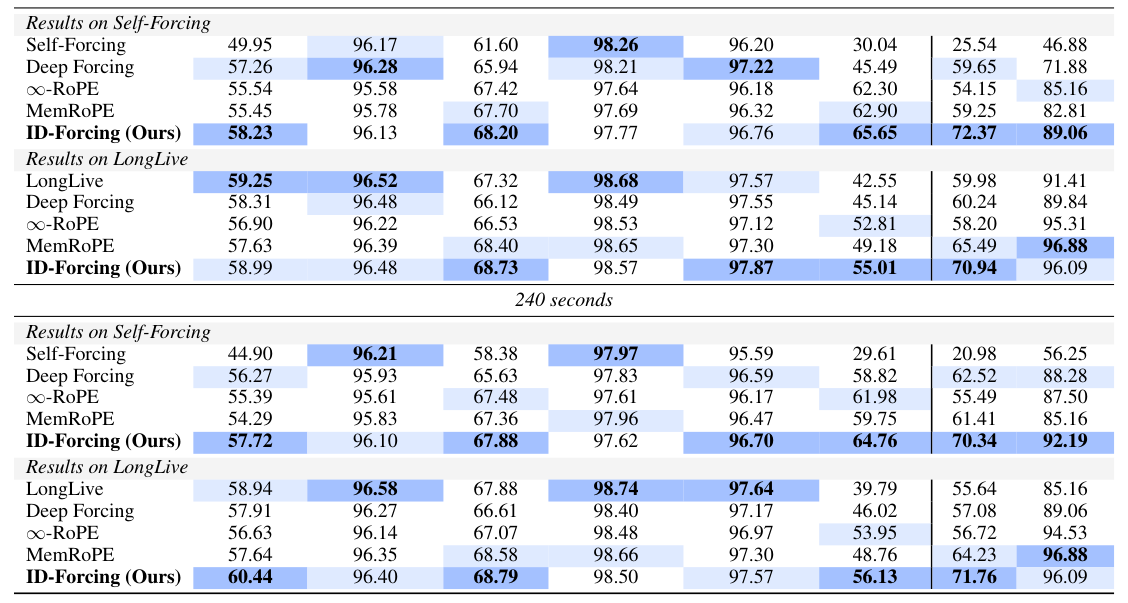
Table 1 — 120초 및 240초 비디오 생성에 대한 핵심 정량적 비교 결과
## 4. Conclusion & Impact (결론 및 시사점) 본 연구는 KV-provenance 문제를 정의하고 이를 해결하기 위한 테스트 타임 프레임워크 ID-Forcing을 도입함으로써 autoregressive 비디오 모델의 장기 생성 안정성을 크게 향상했습니다. 이 기법은 추가적인 재학습 없이도 기존 모델에 바로 적용 가능하다는 점에서 학계 및 산업계에 큰 실용적 가치를 제공합니다. 특히 minute-scale의 비디오 생성에서도 시각적 품질과 모션 다이내믹스를 유지할 수 있음을 입증하여, 향후 월드 모델 및 장편 스토리텔링 비디오 생성 연구의 토대를 마련하였습니다.
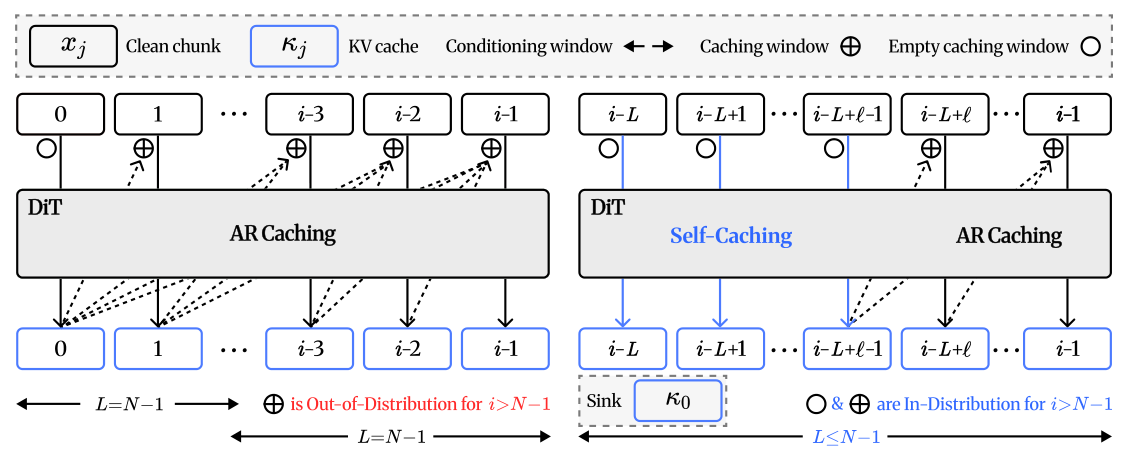
Figure 3 — 제안 방법론인 ID-Forcing의 KV 운영 방식(Self-Caching 등)을 직관적으로 보여주는 비교 그림
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Flex-Forcing: Towards a Unified Autoregressive and Bidirectional Video Diffusion Model
- [논문리뷰] FadeMem: Distance-Aware Memory Consolidation for Autoregressive Video Diffusion
- [논문리뷰] WorldWarp: Propagating 3D Geometry with Asynchronous Video Diffusion
- [논문리뷰] Rollout-Marginal Distillation for Long-Horizon Autoregressive Video Generation
- [논문리뷰] Precise Editing and Flexible Referencing for Interactable Worlds
Review 의 다른글
- 이전글 [논문리뷰] How to Loop MoE: Flatten the Experts, Untie the Attention
- 현재글 : [논문리뷰] In-Distribution Forcing for Long Video Generation at Test Time
- 다음글 [논문리뷰] Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
댓글