[논문리뷰] Representation-Space MMD for Diffusion Language Models
링크: 논문 PDF로 바로 열기
The paper "Representation-Space MMD for Diffusion Language Models" introduces a post-training method for Diffusion Language Models (DLMs) that uses Maximum Mean Discrepancy (MMD) in the feature space of a frozen pretrained DLM.
Here's the summary as requested:
Part 1: 요약 본문
저자: Ilya Drobyshevskiy, Ilia Sudakov, Maksim Semenov, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Diffusion Language Models (DLMs): 노이즈가 있는 입력을 반복적으로 정제하여 텍스트를 생성하는 모델로, discrete token space 또는 continuous latent space에서 작동한다.
- Maximum Mean Discrepancy (MMD): 두 분포 간의 차이를 측정하는 non-parametric 통계량으로, 커널 함수를 사용하여 샘플 간의 유사성을 비교한다. 본 논문에서는 RBF kernel을 주로 사용한다.
- Representation Space: 텍스트 시퀀스나 latent output을 비교하기 위해 사용되는 feature space를 의미하며, frozen pretrained DLM의 중간 hidden states를 feature extractor로 활용한다.
- Self-conditioning: Continuous DLMs (CDLMs)에서 이전 단계의 예측값을 현재 denoiser의 입력으로 사용하여 반복적인 refinement를 가능하게 하는 기법이다.
- Generative Perplexity (Gen. PPL): 생성된 텍스트의 품질을 평가하는 지표 중 하나로, 모델이 다음에 올 토큰을 얼마나 잘 예측하는지를 나타낸다. 낮은 값이 더 좋은 성능을 의미한다.
- Tokens Generated per Forward (TPF): 디코딩 병렬성을 측정하는 지표로, 단일 forward pass에서 생성되는 토큰의 수를 나타낸다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
기존 Diffusion Language Models (DLMs)는 노이즈 입력을 정제하여 텍스트를 생성하지만, conditional estimates가 반드시 고품질 샘플을 적은 스텝으로 생성하지는 못하는 한계가 있다.Diffusion distillation과 같은 기존 방법들은 샘플링 효율성을 개선했으나, teacher-derived targets나 jointly trained auxiliary models이 필요하다는 단점이 있었다. 이에 저자들은 생성된 샘플과 참조 샘플로부터 직접적으로 유용한 분포 매칭 훈련 신호를 계산할 수 있는지에 대한 질문을 제기한다. 특히, 고차원 공간에서 단순한 거리 측정이 의미 있는 차이를 포착하지 못할 수 있기 때문에, MMD의 효과는 비교 공간에 크게 의존한다는 점이 문제로 지적된다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Representation-Space MMD를 활용한 DLM post-training 방법을 제안한다 [Figure 1]. 이 방법은 frozen pretrained DLM의 feature space에서 생성된 분포와 참조 분포 간의 Maximum Mean Discrepancy (MMD)를 최소화한다. MMD를 추정하기 위해 개별 token position의 contextual features를 사용하며, 이를 통해 단일 extractor pass에서 시퀀스당 여러 개의 관측값을 얻는다. Discrete 모델의 경우, policy gradients (REINFORCE)를 사용하여 MMD reward를 최적화하며, MDLM-MMD 및 DMax-MMD로 구현된다. Continuous 모델의 경우, ELF-MMD로 구현되며 생성된 latents를 통해 직접 differentiation을 수행한다. 이 접근 방식은 전체 sampling trajectories나 jointly trained auxiliary models 없이 효율적인 post-training을 가능하게 한다.
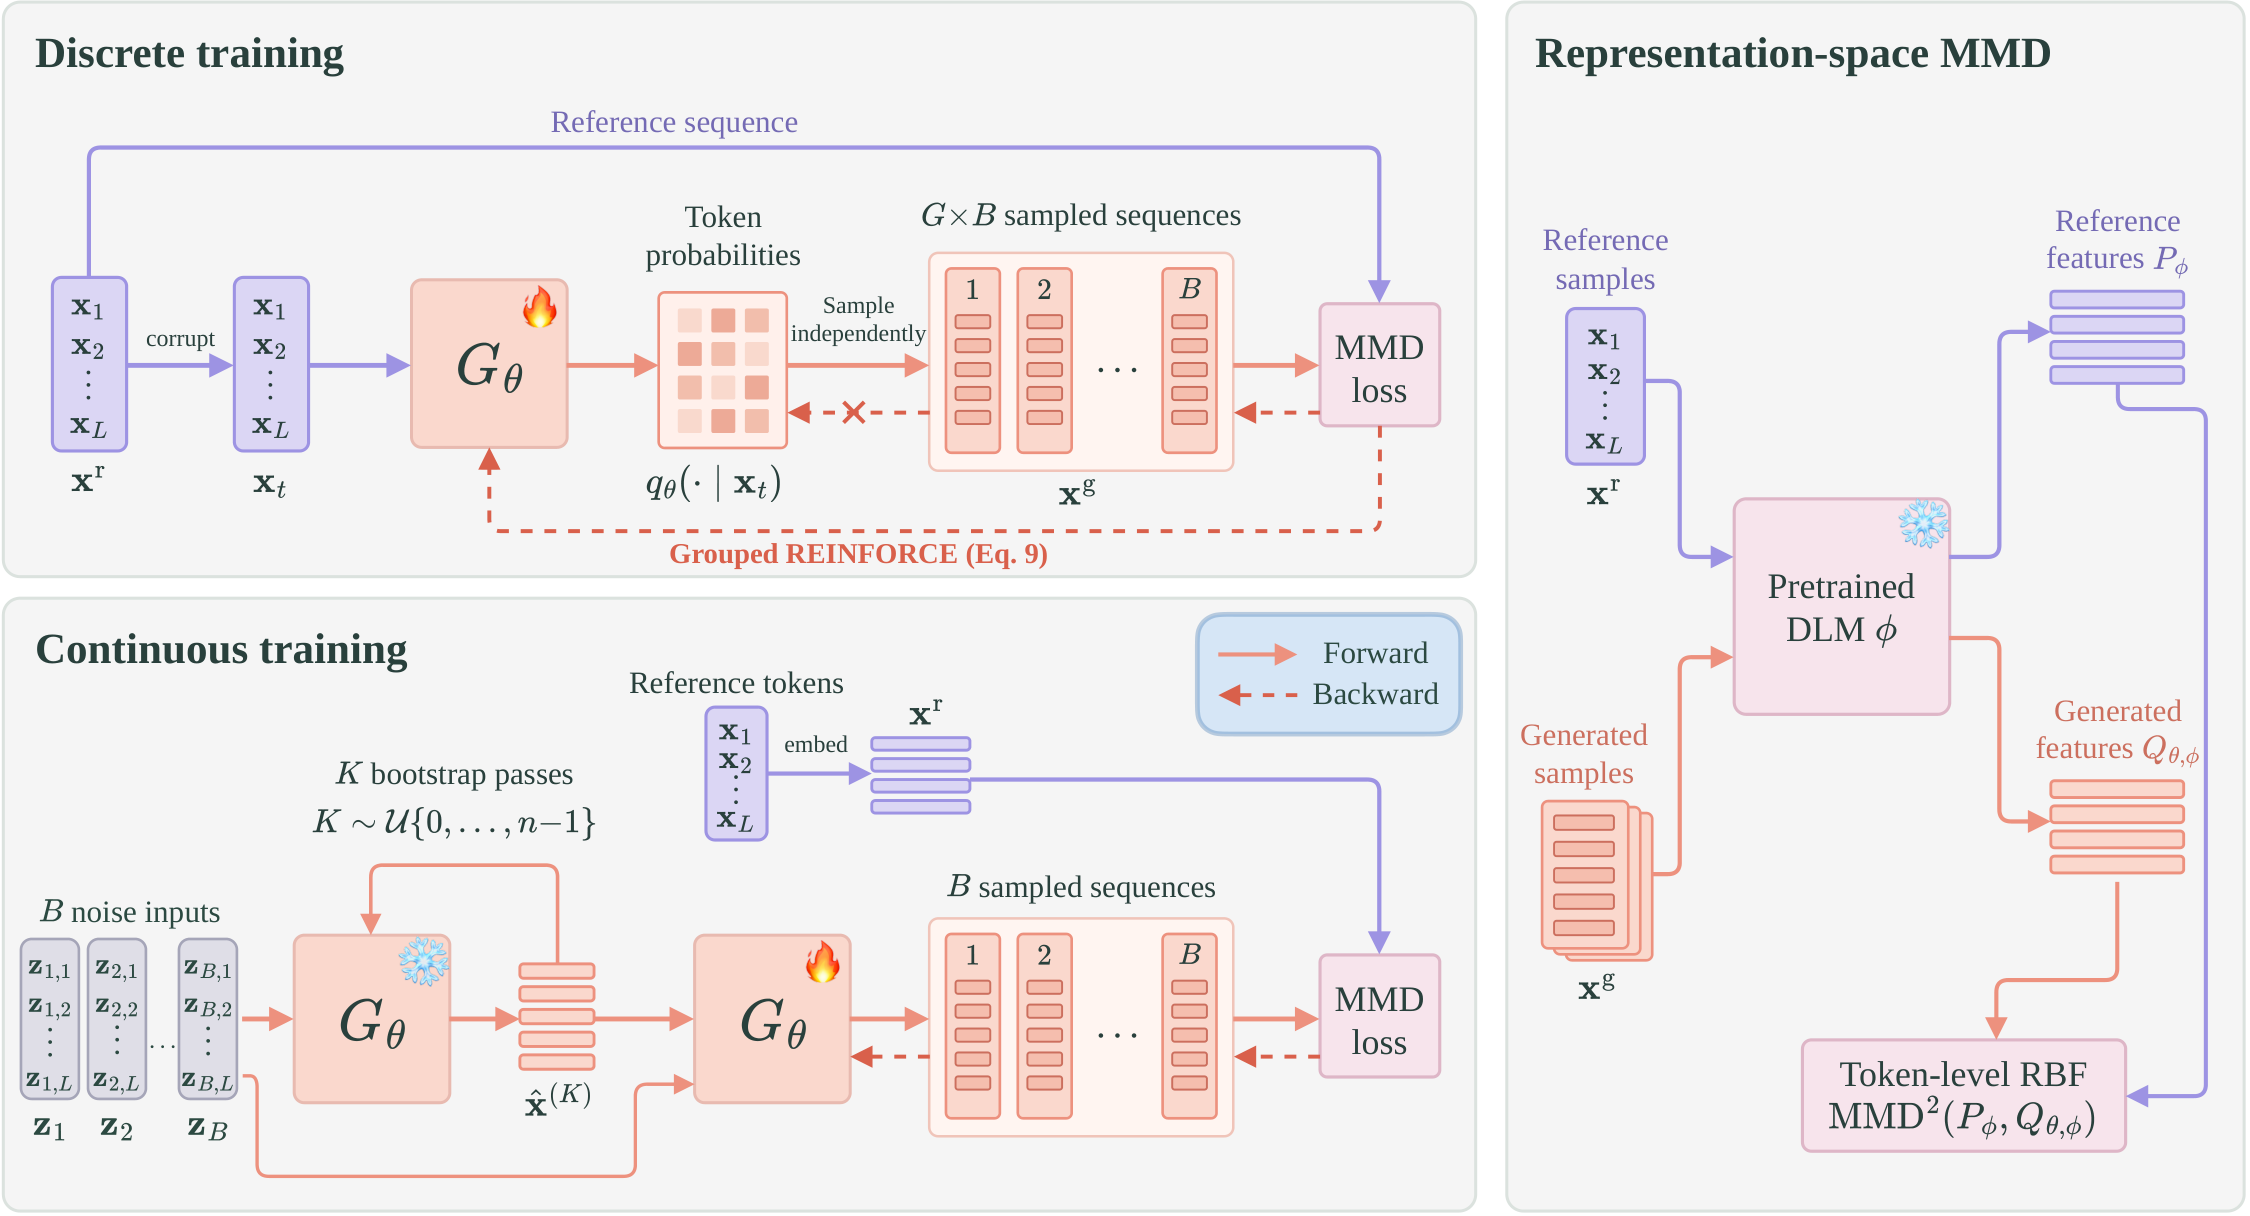
Figure 1 — Representation-space MMD 훈련 개요
실험 결과, MDLM-MMD는 OpenWebText (OWT)에서 모든 baseline 대비 낮은 Generative Perplexity를 달성했으며, 특히 8 스텝에서 IDLM보다 약 17% 낮은 Generative Perplexity를 보였다 [Figure 2, Table 2]. ELF-MMD 또한 T5 및 GPT-2 인코더 모두에서 대부분의 샘플링 예산에서 생성 품질을 향상시켰다 [Figure 2, Table 3]. 조건부 생성 태스크인 GSM8K에서는 MDLM-MMD가 중간 및 높은 디코딩 예산에서 더 높은 Accuracy를 달성했으며, 약 49 스텝에서 54%의 Accuracy를 기록했다 [Figure 3]. ELF-MMD는 ELF-PD 대비 4 스텝에서 20.8% Accuracy로 향상되었고, ELF-MMD++IRD는 64 스텝에서 36.3% Accuracy로 가장 높은 성능을 보였다 [Figure 3, Table 4]. 16B 규모의 DMax-LLaDA2.0 모델에 적용된 DMax-MMD는 math 및 code 벤치마크에서 유사하거나 더 높은 Accuracy를 유지하면서 Tokens Generated per Forward (TPF)를 10.3~16.5% 증가시켜 decoding parallelism을 향상시켰다 [Table 1]. Ablation study 결과, token-level RBF 커널이 다른 loss formulation (linear kernel, sequence-level RBF, attraction-only, feature regression)에 비해 가장 강력한 Accuracy–Computation Trade-off를 제공하는 것으로 나타났다 [Figure 4, Figure 5].
4. Conclusion & Impact (결론 및 시사점)
본 연구는 pretrained DLM features에 기반한 MMD가 discrete 및 continuous DLM 모두에서 생성 품질을 향상시킬 수 있음을 보여준다. 제안된 방법은 효율적인 post-training 절차를 제공하며, 이는 복잡한 sampling trajectories나 jointly trained auxiliary models를 필요로 하지 않는다. 이러한 결과는 DLM의 inference 효율성과 생성 품질 간의 Trade-off를 개선하는 데 중요한 의미를 가진다. 특히, 대규모 모델에 대한 확장 가능성을 보여줌으로써, MMD 기반 접근 방식이 고성능 대규모 언어 모델 개발에 기여할 수 있음을 시사한다. 향후 연구에서는 RBF bandwidth나 representation space의 선택 등 디자인 요소에 대한 추가 탐색과 MMD를 다른 discrete DLM 훈련 목표와 결합하는 방안이 고려될 수 있다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] E-MoE: Enhanced Mixture-of-Experts for Non-Factorized Diffusion Language Models
- [논문리뷰] Simplex Relaxation for Discrete Diffusion
- [논문리뷰] The Best of N Worlds: Aligning Reinforcement Learning with Best-of-N Sampling via max@k Optimisation
- [논문리뷰] LLMs4All: A Review on Large Language Models for Research and Applications in Academic Disciplines
- [논문리뷰] Harnessing Uncertainty: Entropy-Modulated Policy Gradients for Long-Horizon LLM Agents
Review 의 다른글
- 이전글 [논문리뷰] RealtimeWAM: One-Step Asynchronous World Action Models
- 현재글 : [논문리뷰] Representation-Space MMD for Diffusion Language Models
- 다음글 [논문리뷰] Rethinking Long-Video Efficiency: A Joint Allocation Perspective on Frames, Pixels, and Front-End Latency
댓글