[논문리뷰] Rethinking Long-Video Efficiency: A Joint Allocation Perspective on Frames, Pixels, and Front-End Latency
링크: 논문 PDF로 바로 열기
메타데이터
저자: Sixun Dong, Wei Li, Andong Deng, Qi Qian, Victor Zhu, Zhengping Ji, Chen Chen
1. Key Terms & Definitions (핵심 용어 및 정의)
- Lo-V (Low-resolution Video): 전체적인 시간적 맥락을 확보하기 위해 밀도 있게 샘플링된 저해상도 비디오 스트림을 지칭합니다.
- Hi-I (High-resolution Images): Lo-V의 해상도 한계를 보완하기 위해 선택적으로 추가되는 고해상도 이미지 스트림입니다.
- Front-End Latency: 비디오를 VLM에 입력하기 전 디코딩 및 전처리 과정에서 발생하는 대기 시간을 의미하며, 영상 길이에 따라 선형적으로 증가합니다.
- DPP (Determinantal Point Processes): 정보의 관련성과 다양성을 동시에 고려하여 Hi-I 프레임을 선택하는 수학적 프레임워크입니다.
- mRoPE: 비디오 스트림에서 프레임 간의 시간적 위치 관계를 보존하는 다차원 위치 인코딩 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 효율적인 Long-video 이해 방식이 Token budget 내에서 프레임 선택에만 집중하여, 해상도 조절과 Front-End Latency라는 두 가지 핵심 축을 간과하고 있음을 지적합니다. 저자들은 기존의 '희소(sparse)한 네이티브 해상도' 방식이 비효율적임을 실증 연구를 통해 밝히고, 프레임 수, 픽셀 해상도, 디코딩 대기 시간 간의 최적화된 자원 할당 문제를 해결하고자 합니다. 특히, 기존 방식은 영상 길이가 길어질수록 디코딩 비용이 지배적으로 커지는 문제를 안고 있어 새로운 패러다임이 필요합니다 [Figure 1].
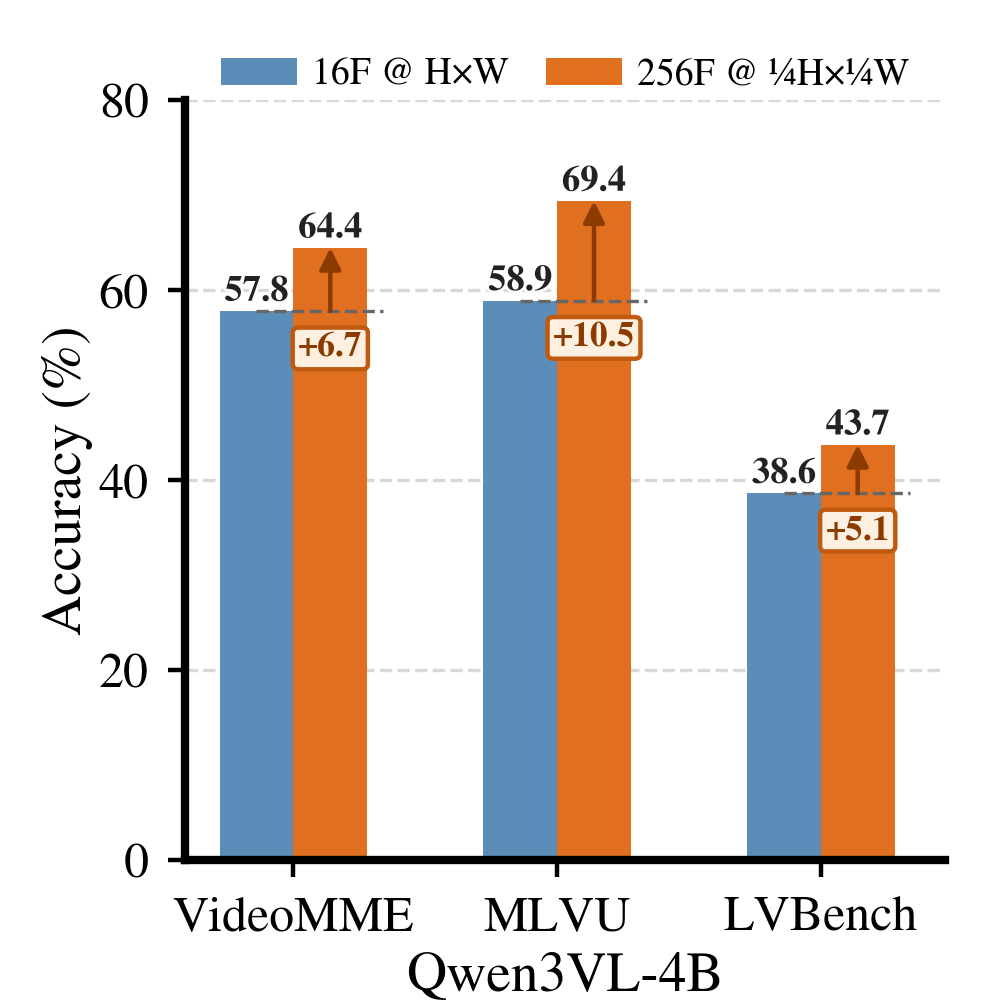
Figure 1 — 효율적 비디오 이해의 3가지 핵심 레슨
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문이 제안하는 LoHi 프레임워크는 dense한 저해상도 비디오 스트림(Lo-V)과 sparse한 고해상도 이미지 스트림(Hi-I)을 결합하는 Cross-Resolution Decomposition 접근 방식을 취합니다. 이 방식은 VLM의 내장된 Video/Image pathway를 활용하므로 별도의 학습(Training-free)이나 아키텍처 수정이 필요하지 않습니다 [Figure 3]. Hi-I 선택을 위해 코덱 메타데이터 기반의 LoHi-Anchor와 DPP 기반의 다양성 인식 선택기인 LoHi-SemDiv를 도입하였습니다. 실험 결과, LoHi는 동일한 Token budget 하에서 이전의 강력한 효율성 방법론들 대비 평균 +5.2%의 성능 향상을 기록했습니다. 또한, 1시간 분량의 영상 클립에서 Front-End Latency를 최대 7배까지 단축하는 정량적 우위를 보였습니다 [Table 2].
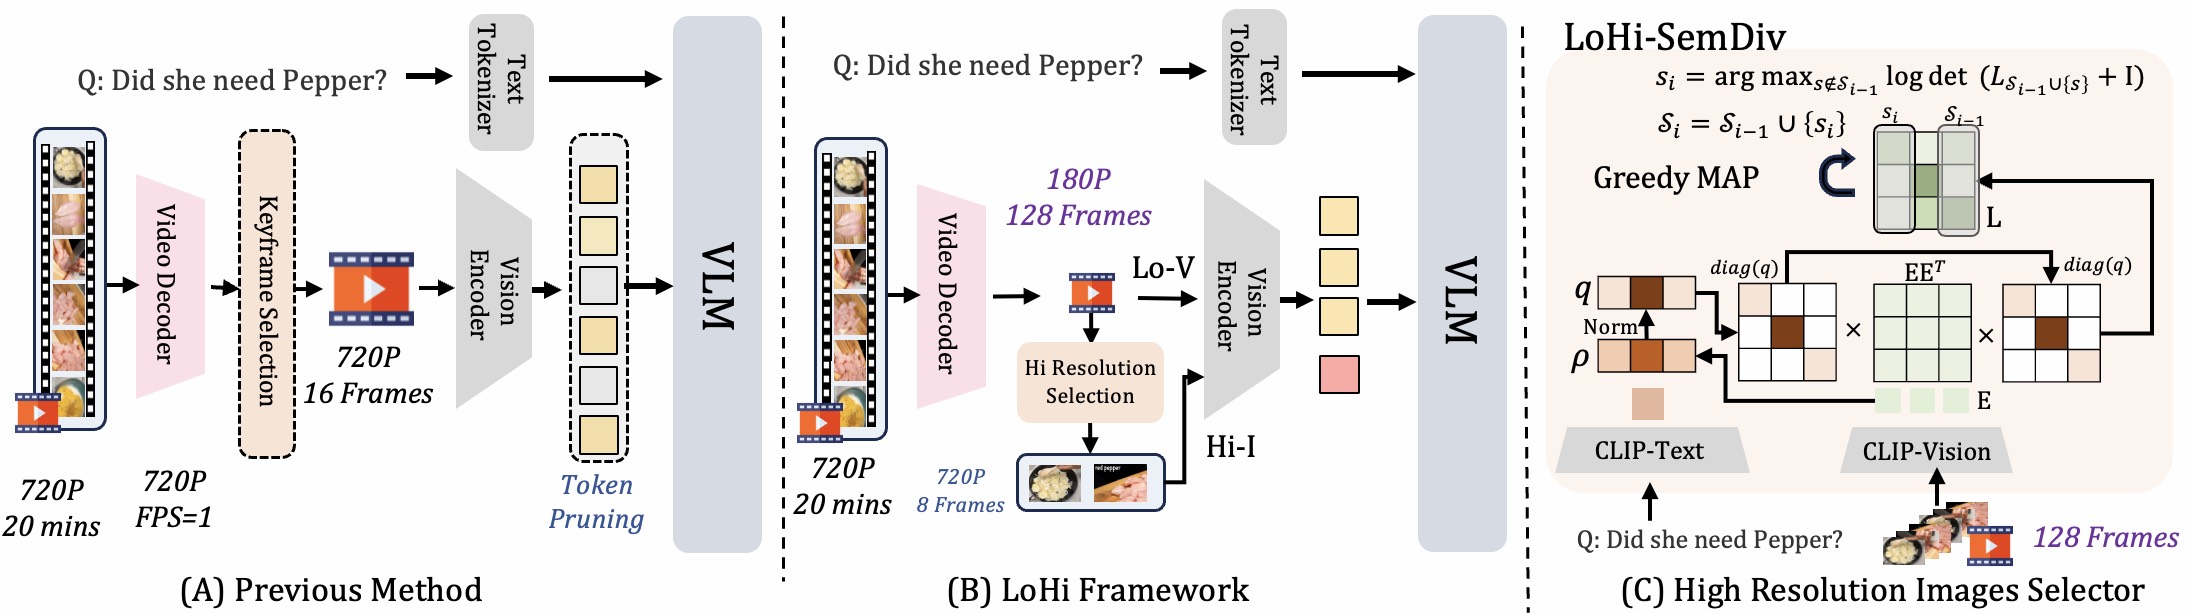
Figure 3 — LoHi 프레임워크 구조
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Long-video 이해를 프레임 수와 해상도의 단일 축이 아닌, Front-End Latency를 포함한 다차원 자원 할당 문제로 재정의하여 새로운 기술적 이정표를 제시합니다. 제안된 LoHi 프레임워크는 하드웨어 자원을 효율적으로 사용하면서도 시간적 문맥과 공간적 세부 사항을 모두 확보할 수 있는 실용적인 해결책을 제공합니다. 이는 컴퓨팅 자원이 제한적인 환경에서 고성능의 장시간 비디오 VLM을 운영하려는 산업계와 학계 전반에 큰 기여를 할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] RoTA-Bench: Evaluating 3D Spatial Reasoning through Interactive Projection Alignment
- [논문리뷰] Visual Grounding Safety in Vision-Language Models
- [논문리뷰] SpaceCast-Bench: Evaluating Predictive Spatial Reasoning in Vision-Language Models
- [논문리뷰] VIEScore2: Unified Image Evaluation with Spatially Grounded Explanations
- [논문리뷰] Improving Proactive AI Assistance with Hierarchical Procedural Understanding
Review 의 다른글
- 이전글 [논문리뷰] Representation-Space MMD for Diffusion Language Models
- 현재글 : [논문리뷰] Rethinking Long-Video Efficiency: A Joint Allocation Perspective on Frames, Pixels, and Front-End Latency
- 다음글 [논문리뷰] RobotUse: Allocating Computation, Context, and Decisions
댓글