[논문리뷰] RobotUse: Allocating Computation, Context, and Decisions
링크: 논문 PDF로 바로 열기
저자: Junhoo Lee, Injun Baek, Seungyeon Kim, Suhyun Jeon, Minkyu Kim, Baekseung Kim, Nojun Kwak
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- RobotUse: 물리적 동작을 수행하기 위해 계산, 컨텍스트, 의사결정을 구조화하는 intent-based 에이전트 하네스(harness).
- Playbook: 에이전트의 경험을 축적하고, 향후 동작에 대한 조건부 가이드를 제공하는 지속적인 기억 데이터 구조.
- Handoff Unit: 메인 에이전트와 서브에이전트 간의 작업을 위임하고, 하위 작업의 결과(보고서)를 다시 메인 컨텍스트로 통합하는 메커니즘.
- Backend Execution: 에이전트가 지정한 물리적 의도를 기하학적 연산, 동작 계획(motion planning), 제어 명령으로 변환하는 하드웨어 인터페이스.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 일반적인 로봇 에이전트 설계에서 연산과 컨텍스트의 효율적 배분 문제를 해결하고자 한다. 기존의 코드 기반 또는 스킬 기반 하네스는 실행 세부사항과 의도적인 물리적 선택 사이의 연결을 모호하게 만들거나, 에이전트의 컨텍스트를 과도하게 점유하여 성능 저하를 초래한다. 특히 고차원적인 연속 동작에서 에이전트가 의도를 수정하거나 실패 상황에서 회복하는 데 필요한 컨텍스트 유지가 어려우며, 이는 [Figure 1]에 제시된 것처럼 에이전트와 백엔드 간의 명확한 역할 분담과 경험적 지식의 유지가 필수적임을 시사한다.
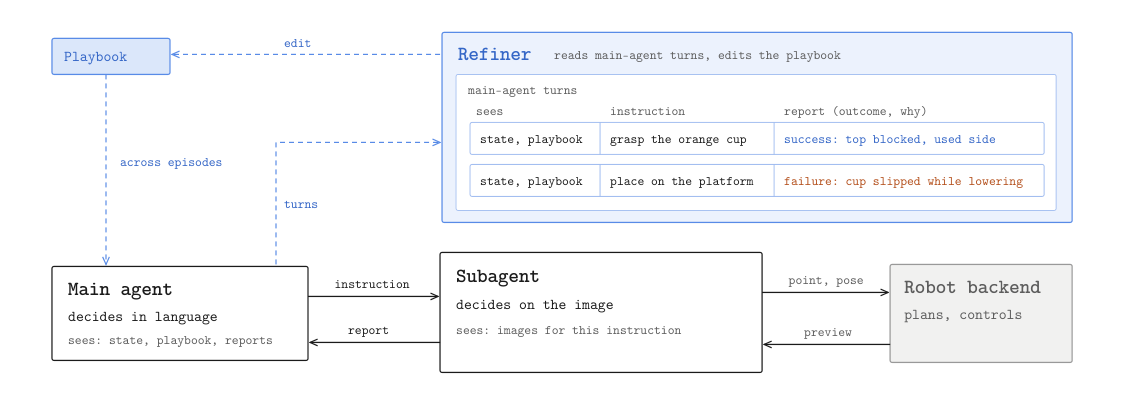
Figure 1 — RobotUse의 전체적인 에이전트 하네스 구조와 워크플로우를 보여주는 핵심 다이어그램
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 논문은 물리적 의도를 명시적으로 지정하고 수정할 수 있는 intent-based 하네스인 RobotUse를 제안한다. RobotUse는 메인 에이전트가 언어적 목표를 설정하면, 서브에이전트가 이를 시각적 타겟과 포즈로 지상화(grounding)하고, 백엔드가 이를 실행하는 구조를 가진다. 실행 결과는 Playbook을 통해 학습되어 차후 작업에 반영되며, 이는 [Table 1]에서 입증된 바와 같이 전체 40개 작업에서 45.00%의 성공률을 기록하여 기존 CaP-X(38.33%) 및 기타 베이스라인 모델을 능가하는 성과를 보였다. 또한, 컨텍스트 핸드오프 메커니즘은 단일 에이전트 방식 대비 4.2배 더 낮은 평균 입력 토큰 사용량을 유지하면서도 높은 효율성을 달성했다. 이러한 결과는 [Figure 5]와 같이 파지 도구 제거와 같은 악조건에서도 에이전트가 시각적 피드백을 통해 동작을 수정하여 높은 강건성(robustness)을 유지할 수 있음을 보여준다.
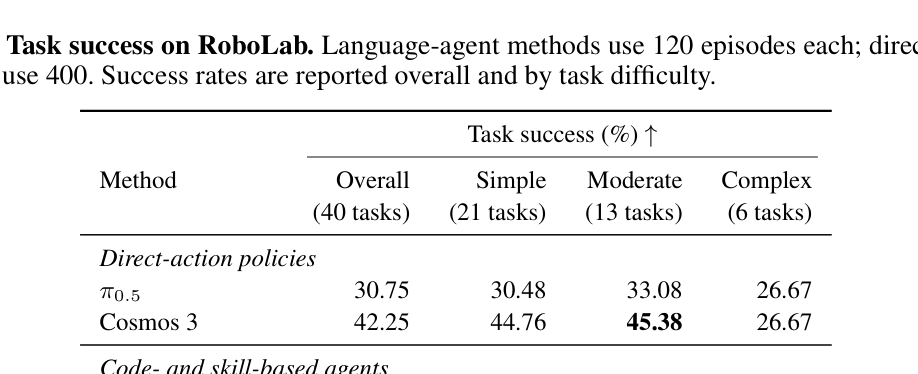
Table 1 — RobotUse의 성능을 다른 베이스라인 모델들과 정량적으로 비교한 핵심 지표
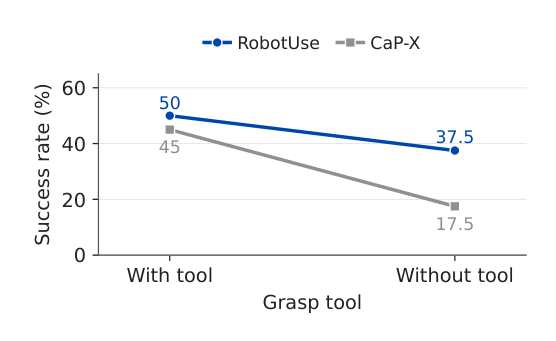
Figure 5 — 도구 유무에 따른 모델의 강건성(Robustness) 변화를 보여주는 핵심 실험 결과 그래프
## 4. Conclusion & Impact (결론 및 시사점) 본 연구는 로봇 제어에서 기하학적 연산을 백엔드로 위임하고, 에이전트가 물리적 선택사항에 대한 수정 권한과 컨텍스트를 유지하도록 설계하는 것이 효율적인 로봇 에이전트 구축의 핵심임을 결론짓는다. RobotUse는 Playbook을 통한 경험 누적과 모듈형 핸드오프를 통해 모델 파라미터의 수정 없이도 새로운 작업으로의 빠른 전이를 지원한다. 이 프레임워크는 향후 범용 로봇 에이전트가 복잡한 물리적 환경에서 인간의 의도를 더 정밀하게 이행하고, 실패로부터 스스로 개선할 수 있는 기술적 토대를 마련했다는 점에서 큰 학술적·산업적 의의를 가진다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] VeriFine: Scaling Verification for Self-Improvement in Embodied Reasoning
- [논문리뷰] Dynamic Harness Search: Building Multi-Agent Systems Per-Query via Prediction
- [논문리뷰] Fewer Tokens, Better Action: GPT-6 Astra Robot Agents with 14% Higher Success Rate but 65% Fewer Tokens
- [논문리뷰] Raven: The Harness of Harnesses for Composable Agentic Intelligence
- [논문리뷰] Omni-IO Skills: Harnessing Your Agent Omni-Native
Review 의 다른글
- 이전글 [논문리뷰] Rethinking Long-Video Efficiency: A Joint Allocation Perspective on Frames, Pixels, and Front-End Latency
- 현재글 : [논문리뷰] RobotUse: Allocating Computation, Context, and Decisions
- 다음글 [논문리뷰] SearchJev: A Fast and Calibrated System-1 Model for Search Agents
댓글