[논문리뷰] SuperNav: An Agentic Navigation System for Any Task in Any Scene
링크: 논문 PDF로 바로 열기
메타데이터
저자: Jinkai Zhang, Jingyi Xu, Yuanhong Yu, Jiarui Guo, Ruizhen Hu, Hujun Bao, Xiaowei Zhou, Sida Peng et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Agentic Harness: MLLM의 추론 능력과 물리적 환경 상호작용을 연결하기 위해 설계된 프레임워크로, 도구 호출, 태스크 상태 관리, 탐색 가이드를 제공합니다.
- Unified Visual-Point Interface: MLLM이 시각적 관찰 이미지 상에 직접 목적지를 지정하면, 하위 Navigation Tool이 이를 해석하여 이동하는 통합 인터페이스입니다.
- Navigation Skills: 검색, 확인, 복구 등 복잡한 상황에서 모델이 참조할 수 있는 절차적 가이드라인 패키지입니다.
- Geo-based/Learned Executor: 각각 기하학적 정보 기반의 경로 계획(Geo-based) 또는 학습된 시각적 이동 정책(Learned)을 사용하여 물리적 동작을 수행하는 Motion Backend입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 서비스 로봇이 다양한 인간의 요청을 처리하면서도 새로운 환경에 적응하는 Task Generalization과 Scene Generalization을 동시에 달성하는 것을 목표로 합니다. 기존의 Modular 방식은 사전에 정의된 워크플로우에 의존하여 요청 변경 시 유연성이 부족하며, End-to-End 방식은 특정 데이터셋에 과적합되어 새로운 환경에서 성능이 저하되는 한계가 있습니다 [Figure 1]. 이러한 문제를 해결하기 위해 저자들은 MLLM을 네비게이션 전용으로 파인튜닝하지 않고, 외부 에이전트 하네스를 통해 고차원적 의사결정을 지원하는 SuperNav를 제안합니다.
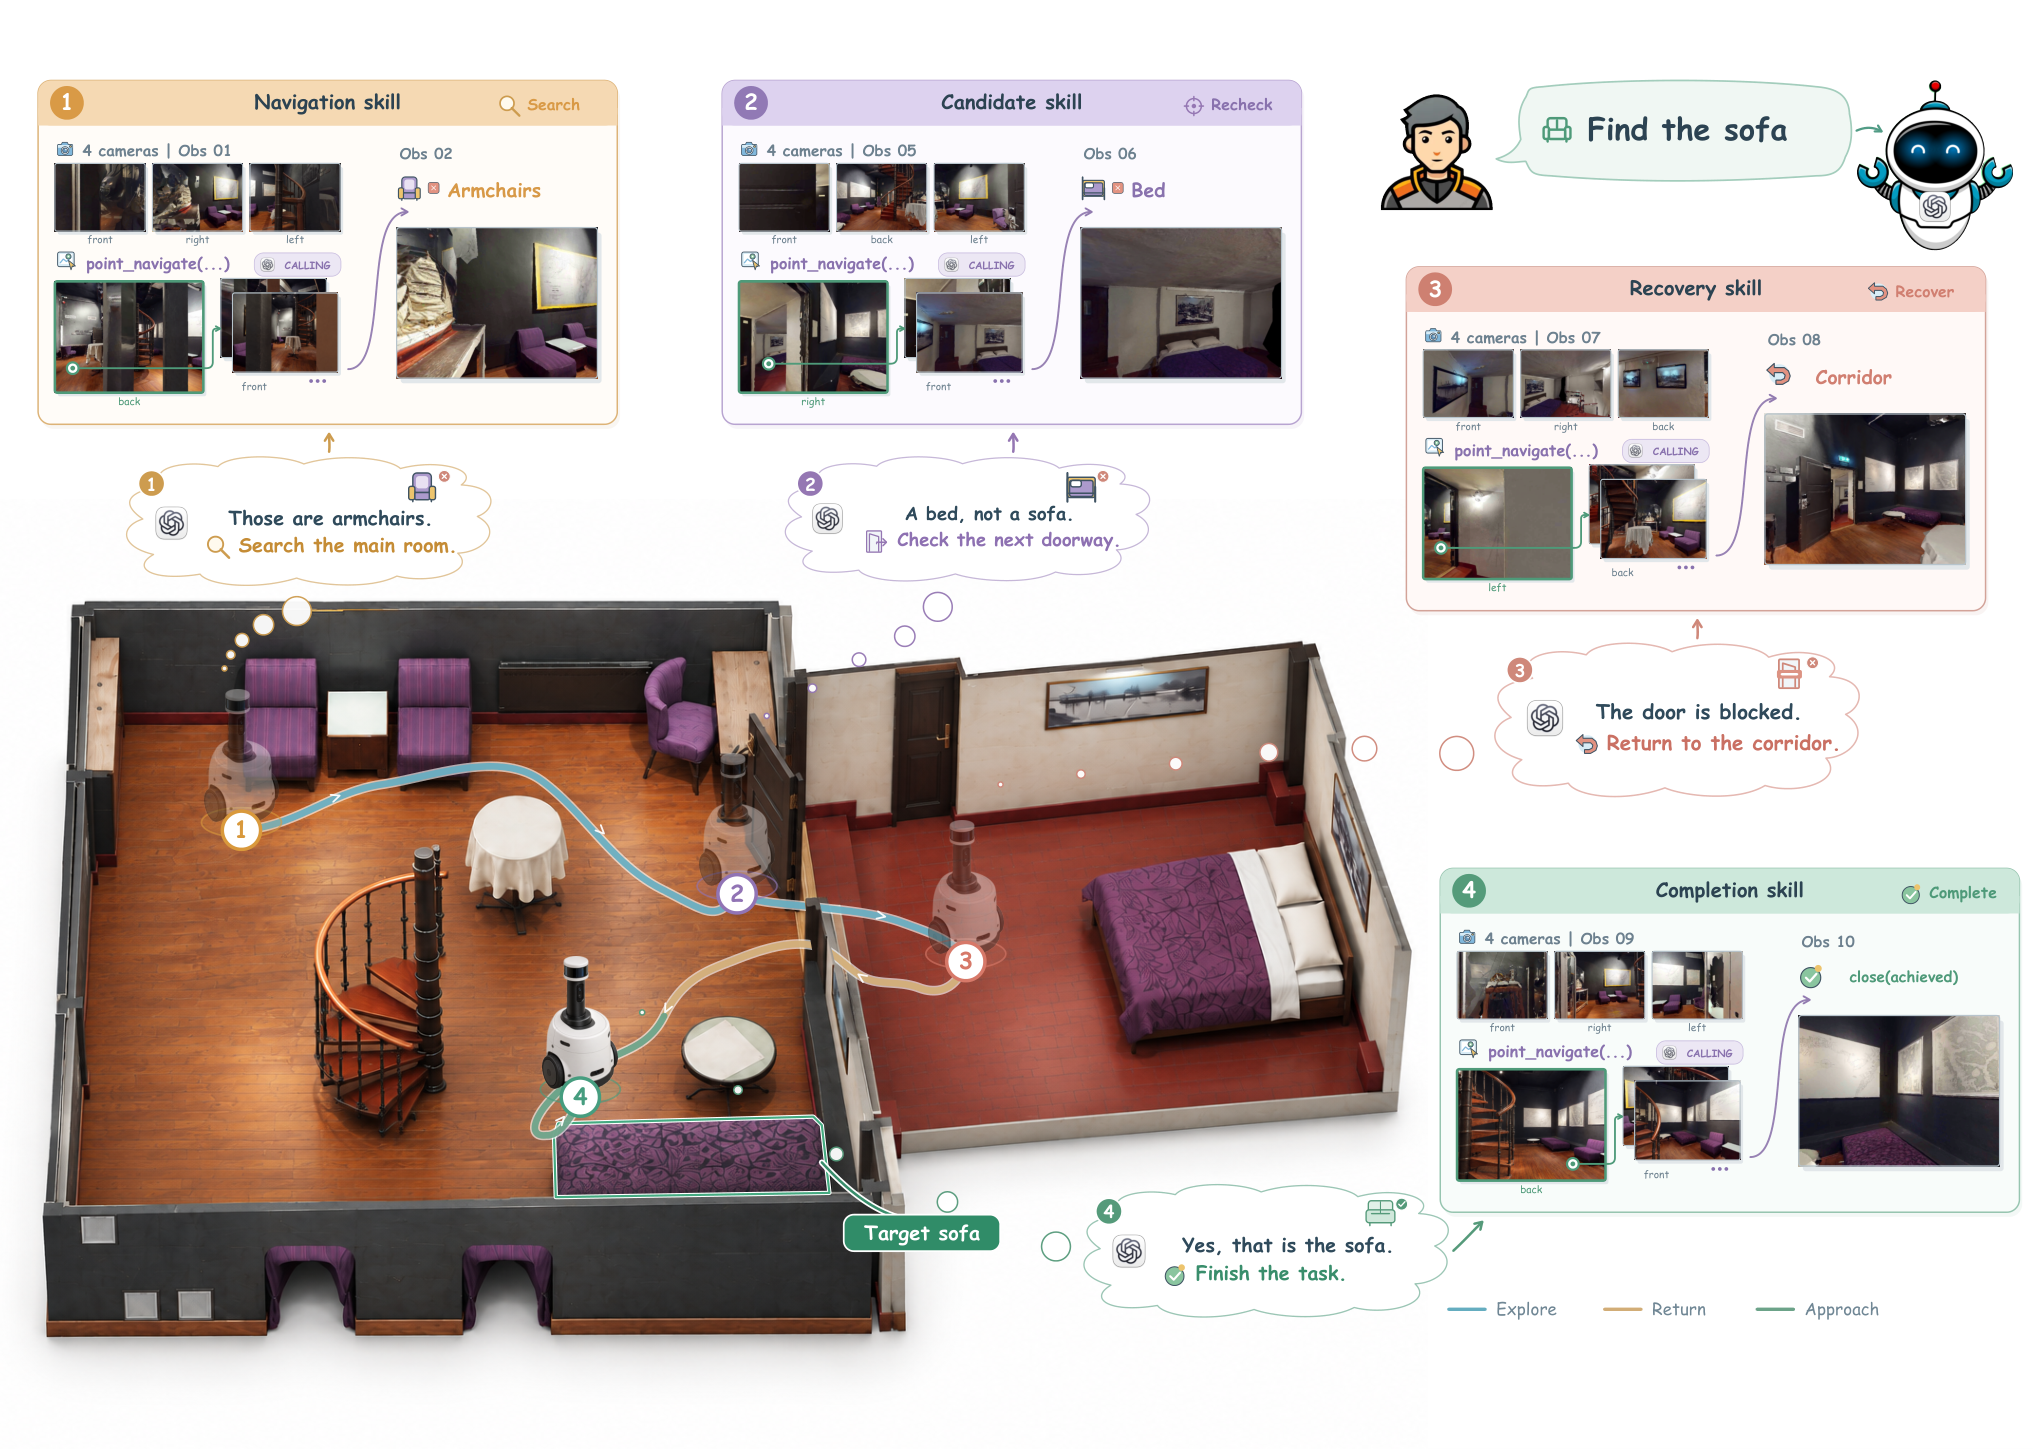
Figure 1 — SuperNav의 스킬 기반 탐색 예시
3. Method & Key Results (제안 방법론 및 핵심 결과)
SuperNav는 MLLM이 환경을 관찰하고 요청을 해석하여 의사결정을 내리면, 하네스가 제공하는 도구와 스킬을 통해 이를 물리적 동작으로 변환하는 구조입니다 [Figure 2]. 핵심 방법론인 Unified Visual-Point Interface는 모델이 이미지 내의 특정 좌표를 목적지로 선택하게 하여 다양한 Motion Backend와 상호운용성을 확보합니다. Navigation Skills는 모델이 막다른 길에서 복구하거나 목표를 확인하는 등의 반복적인 판단을 내릴 때 필요한 상황별 가이드를 제공하여 성능을 보조합니다. 실험 결과, SuperNav는 Instance-level 탐색(78.00% SR) 및 Demand-driven 탐색(59.50% SR) 등에서 기존 Baseline인 UniNaVid와 OmniNav 대비 압도적인 성능 우위를 보였습니다 [Table 1]. 또한, 별도의 네비게이션 전용 파인튜닝 없이도 HM3D-OVON 벤치마크에서 73.33% SR 및 0.4105 SPL을 기록하며 강력한 범용성을 입증했습니다 [Table 2].
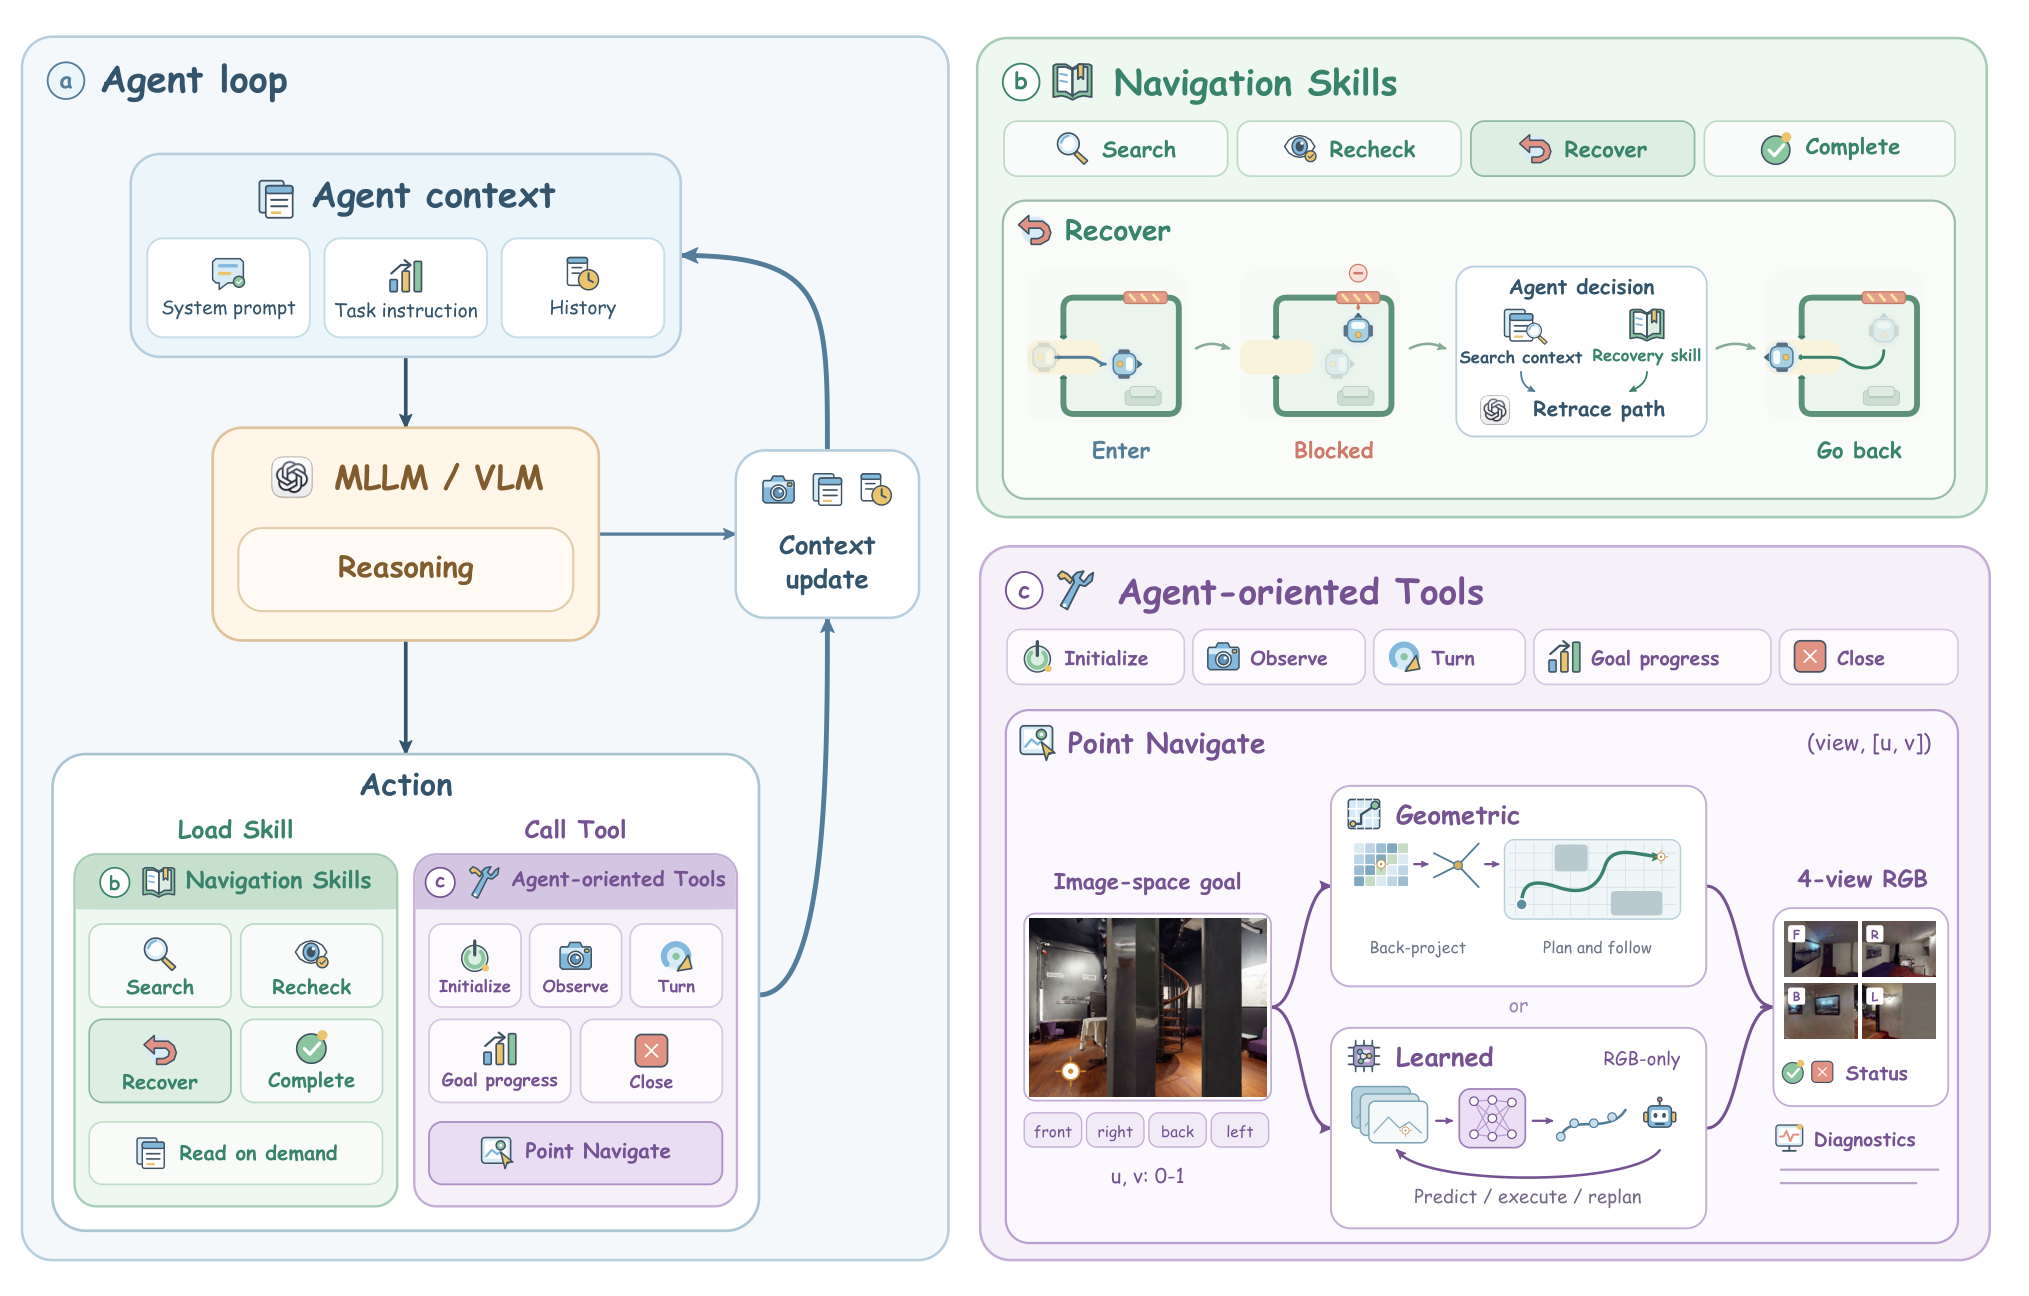
Figure 2 — SuperNav 에이전트 루프 및 하네스 구조
4. Conclusion & Impact (결론 및 시사점)
본 연구는 MLLM의 강력한 추론 능력을 유지하면서도 에이전트 하네스를 통해 다양한 환경과 태스크에서 로봇 네비게이션을 수행하는 효과적인 프레임워크를 제시하였습니다. 이 연구는 복잡한 인간의 요청을 해석하는 로봇의 인지 능력과 물리적 동작 간의 간극을 효과적으로 연결했다는 점에서 의미가 큽니다. 향후 다양한 Service Robot 분야에서 인간-로봇 상호작용(HRI)의 유연성을 획기적으로 개선하고, 더 복잡한 미션 수행을 위한 밑거름이 될 것으로 기대됩니다.
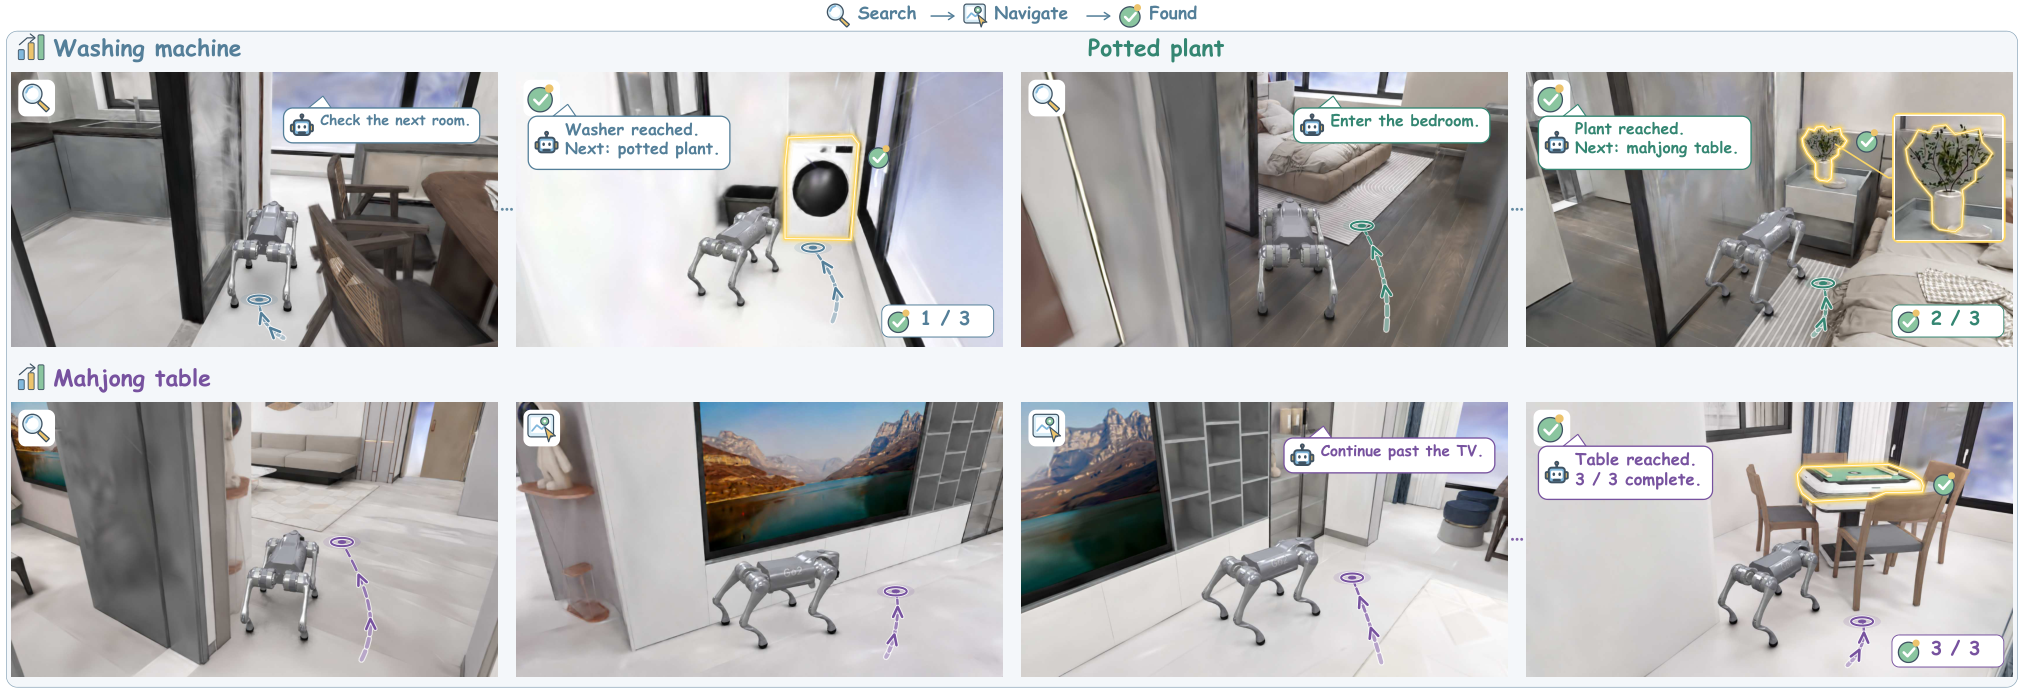
Figure 3 — 시뮬레이션 내 다중 목표 순차 탐색
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] UrbanGround: From Local Perception to Spatial Agency in a Real-Scale City
- [논문리뷰] VisionWeave: Weaving Elastic Visual Representations as a Native Capability of MLLMs
- [논문리뷰] PolyOCR-Venus: Unified OCR Foundation Models for Text-Centric Visual Intelligence
- [논문리뷰] OmniCapBench: A Deep-Structured Evaluation Framework for Fine-Grained Audio-Visual Captioning
- [논문리뷰] VepAgent: Bridging Causal-Transition via Tool-Augmented Reinforcement Learning for Video Event Prediction
Review 의 다른글
- 이전글 [논문리뷰] SpatialOPSD: Self-Distilling Spatial Intelligence from Verified Coding Agent Traces
- 현재글 : [논문리뷰] SuperNav: An Agentic Navigation System for Any Task in Any Scene
- 다음글 [논문리뷰] Synthesis Through Simulation: Generating Coherent Enterprise Data via Scalable Agent-System Interaction
댓글