[논문리뷰] SpatialOPSD: Self-Distilling Spatial Intelligence from Verified Coding Agent Traces
링크: 논문 PDF로 바로 열기
저자: Rongxue Li, Meng Yang, Yiru Mao, Yongliang Tao, Lulu Hu, Bin Yang, Zhao Xu, Weihua Luo, Bowen Xu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Spatial Reasoning: 2D 관찰에서 잠재적인 3D 속성을 추론하는 능력.
- Multimodal Large Language Models (MLLMs): 텍스트 외에 이미지, 비디오 등 다양한 양식의 데이터를 이해하고 처리할 수 있는 대규모 언어 모델.
- Spatial Coding Agent: MLLM에 코드 실행 인터페이스와 외부 기하학 도구를 장착하여 공간 추론 작업을 수행하고 검증된 실행 Trace를 생성하는 Agent.
- On-Policy Self-Distillation (OPSD): Privileged Information에 conditioned된 Teacher 모델이 Student 모델에게 자기 생성된 Trajectory에 대한 dense supervision을 제공하는 프레임워크.
- Privileged Information: Teacher 모델이 Student 모델보다 추가적으로 접근할 수 있는 정보로, 본 논문에서는 Verified Agent Traces를 요약하여 구성한다.
- Repetition-Aware Distillation: OPSD 과정에서 self-reinforcing repetition 및 privileged-information leakage를 완화하기 위해 제안된 기법으로, repetition masking과 unlikelihood regularization을 결합한다.
- Tool-Free Inference: 모델이 추론 시 외부 도구나 API 호출 없이 자체적으로 작업을 수행하는 방식.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 MLLM의 공간 추론 능력 향상에 대한 근본적인 문제 제기로 시작한다. 기존 MLLM은 2D 관찰에서 3D 속성을 추론하는 Spatial Reasoning에 어려움을 겪으며, 중간 기하학적 추론의 unverifiability가 표준 Training Paradigm의 병목이 된다. Answer-level Supervised Fine-Tuning (SFT)는 공간 이해를 implicit하고 brittle하게 만들고, Explicit Chain-of-Thought (CoT) Supervision은 확장하기에 prohibitively expensive하다. 강화 학습(예: GRPO) 또한 Costly cold-start data와 sparse outcome rewards에 의존하여 비효율적이다. Spatial Coding Agent는 외부 도구와 코드 실행을 통해 verifiability bottleneck을 해결했지만, Inference-time overhead와 외부 dependencies라는 새로운 부담을 야기한다. 저자들은 MLLM이 이러한 Agentic capability를 internalize하여 Inference-time에 완전히 Tool-Free로 작동할 수 있는지 탐구하며, 검증된 Agent Traces를 기반으로 공간 추론을 내재화하는 것을 목표로 한다 [Figure 2].
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Tool-based Spatial Reasoning을 MLLM에 전이하기 위한 On-Policy Self-Distillation (OPSD) 프레임워크인 SpatialOPSD를 제안한다. SpatialOPSD는 Verified Spatial Coding Agent Traces를 Privileged Information으로 요약하여 OPSD의 Teacher 모델을 Conditioned한다 [Figure 3]. 이 과정에서 발생하는 Privileged-Information Leakage를 완화하기 위해, Repetition-Aware Distillation 기법을 도입한다 [Figure 4]. 이 기법은 Repetition Masking과 Unlikelihood Regularization을 결합하여, Student 모델이 Privileged Content를 Verbatim Copying하거나 Self-Repetition하는 것을 방지한다.
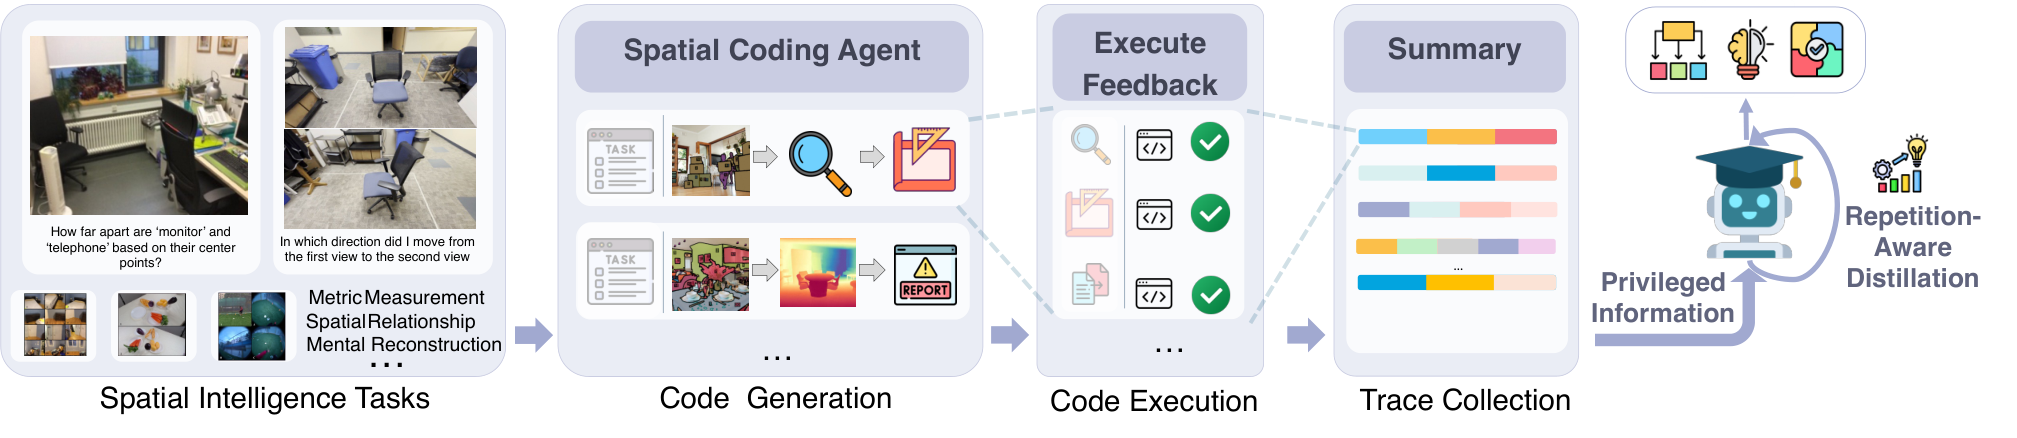
Figure 3 — SpatialOPSD 개요
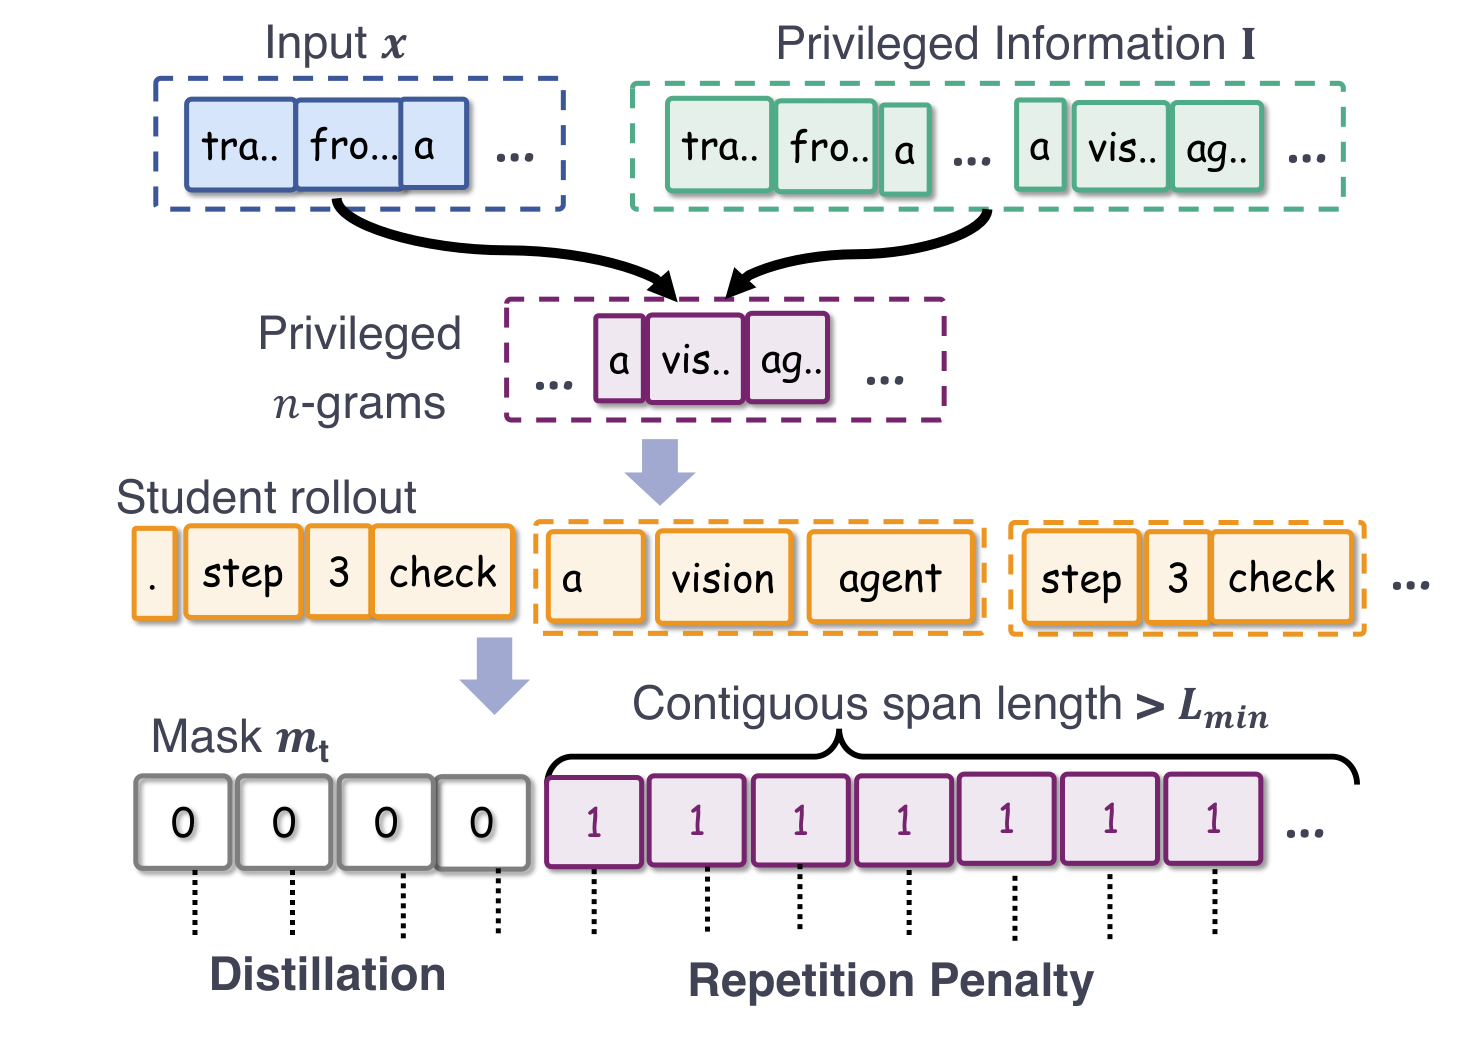
Figure 4 — Repetition-Aware Distillation
실험 결과, SpatialOPSD-9B 모델은 MindCube-Tiny 및 ViewSpatial 벤치마크에서 기존 Qwen3.5-9B-CoT baseline 대비 평균 6.0%p 향상된 51.9%의 정확도를 달성했다. 특히 MindCube-Tiny의 Among task에서는 11.7%p의 상당한 개선을 보였다. 또한, SpatialOPSD는 Supervised Fine-Tuning (SFT)의 47.6% 및 GRPO의 48.2%보다 높은 평균 정확도를 기록하여, Distribution Shift 및 Sparse-Reward 한계를 효과적으로 극복했음을 입증했다. 주목할 만한 점은, SpatialOPSD가 Inference-time에 Tool-Free로 작동하면서도, Iterative하고 Tool-dependent한 Teacher 모델인 SpatialClaw (57.3%) 성능의 91%를 유지한다는 것이다. Out-of-Distribution (OOD) 벤치마크 평가에서도 SpatialOPSD는 64.7%의 최고 평균 정확도를 달성하며, CoT baseline (64.4%)을 근소하게 상회하고 SFT 및 GRPO를 능가하여 뛰어난 Generalization 능력을 보여주었다. Privileged Information 유형에 대한 Ablation Study에서는 Summary 방식이 가장 우수한 성능을 보였으며, 이는 Teacher-Student Entropy Gap을 적절히 유지하기 때문이다. Repetition-Aware Distillation의 Mask와 Unlikelihood Penalty는 PI Leakage를 크게 줄이면서도 정확도를 향상시키는 상호보완적인 역할을 한다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 검증된 Spatial Coding Agent Traces를 Privileged Information으로 활용하여 MLLM에 공간 추론 능력을 내재화하는 SpatialOPSD 프레임워크를 성공적으로 제시한다. 제안된 Repetition-Aware Distillation은 Privileged Information Leakage 문제를 효과적으로 해결하며, Tool-Specific Artifacts로부터 공간 추론을 분리한다. SpatialOPSD는 MindCube 및 ViewSpatial 벤치마크에서 기존 SFT 및 강화 학습 Baseline을 능가하는 성능을 보였으며, Inference-time에 외부 도구 없이도 Tool-Using Agent에 필적하는 정확도를 달성했다. 이 연구는 동일한 MLLM에 의해 생성된 Training Data를 사용하여 Self-Distillation 학습 루프를 구축함으로써, Tool-Assisted Data Generation에서 강력한 Standalone Spatial Reasoning으로 나아가는 실용적인 경로를 제공한다. 이는 MLLM의 복잡한 Agent Trajectory를 Internalize하는 것이 Parameter Scaling과 더불어 Capability Enhancement의 유효한 축임을 시사하며, 해당 분야의 MLLM 기반 Spatial Reasoning 연구에 중요한 영향을 미칠 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] BiManiBench: A Hierarchical Benchmark for Evaluating Bimanual Coordination of Multimodal Large Language Models
- [논문리뷰] Visual Jigsaw Post-Training Improves MLLMs
- [논문리뷰] OmniCompass: A Holistic Benchmark for Omni-Modal Video Grounding and Understanding
- [논문리뷰] VideoJev: System One Model for Video Understanding and Interaction
- [논문리뷰] SpatialASM: Internalizing Active Mentalization for Spatial Reasoning
Review 의 다른글
- 이전글 [논문리뷰] SparseEngine: Sparse-First Inference Engine
- 현재글 : [논문리뷰] SpatialOPSD: Self-Distilling Spatial Intelligence from Verified Coding Agent Traces
- 다음글 [논문리뷰] SuperNav: An Agentic Navigation System for Any Task in Any Scene
댓글