[논문리뷰] VeriFine: Scaling Verification for Self-Improvement in Embodied Reasoning
링크: 논문 PDF로 바로 열기
저자: Zewei Zhou, Rachel Luo, Yulong Cao, Chaowei Xiao, Chensheng Peng, Boyi Li, Thomas Tian, Zheng Lian, Yan Wang, Jiaqi Ma, Boris Ivanovic, Marco Pavone, Wenhao Ding
1. Key Terms & Definitions (핵심 용어 및 정의)
- VeriFine: Embodied Reasoning 분야에서 Policy, Training Curriculum, Judge의 Co-evolution을 통해 Self-improvement를 달성하는 Agent Harness 프레임워크입니다.
- Reference-Free Rubric Judge: 외부의 골든 레퍼런스 없이도, 물리적 상황(Physical Context)을 직접 평가하여 Policy의 출력물(Reasoning 및 Action)을 진단하는 평가 모델입니다.
- Coactive Calibration: Judge가 Policy의 발전 속도를 따라가지 못할 때, 인간의 가이드와 Agent가 불일치를 해소하며 물리적 추론의 객관적 Rubric으로 수렴해가는 Judge 정제 과정입니다.
- Policy Improvement Loop: 고도화된 Judge를 통해 Policy의 장애 패턴을 진단하고, 이를 바탕으로 데이터셋을 구성하여 Policy를 최적화하는 반복적인 학습 주기입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존의 정적인(Static) Judge 체계가 Policy의 성능 향상을 저해하는 병목(Bottleneck)이 되는 문제를 해결하고자 합니다. Embodied Reasoning 분야에서 Policy가 계속 학습하여 새로운 실패 패턴을 노출할 때, 고정된 Judge는 이를 정확히 평가하지 못해 Reward Hacking이나 성능 퇴보를 초래합니다. 기존의 Reference-based 평가 방식은 확장성이 낮고 인간 피드백 의존도가 지나치게 높다는 한계가 있습니다. 따라서 저자들은 Policy의 성장에 맞춰 Judge와 Curriculum이 동적으로 적응하며 함께 진화(Co-evolution)할 수 있는 새로운 Verification Framework가 필요하다고 정의합니다 [Figure 1].
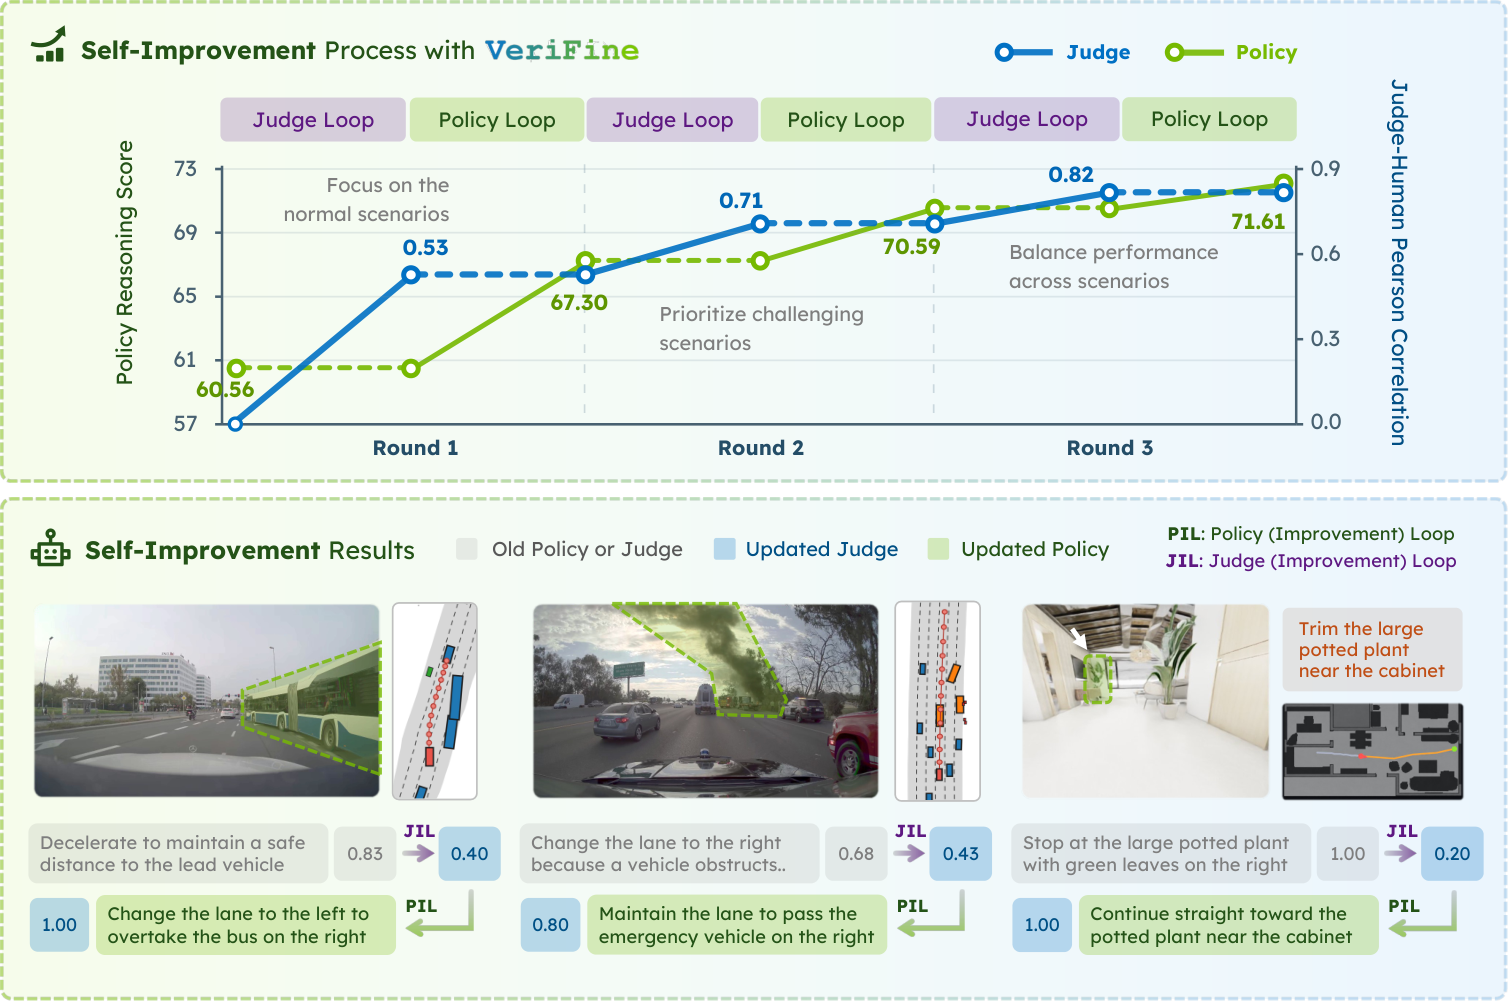
Figure 1 — VeriFine의 지속적인 자가 개선 프레임워크
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Verification 프로세스를 확장하여, Policy의 학습 루프와 Judge의 교정 루프를 결합한 VeriFine 프레임워크를 제안합니다 [Figure 2]. Policy Improvement Loop는 Reference-free Judge를 활용해 현재 Policy의 반복적인 실패 사례를 발견하고, 이를 통해 적응형 커리큘럼(Adaptive Curriculum)을 구축하여 Policy를 최적화합니다. 만약 Verification 성능이 한계에 도달하면 Judge Improvement Loop가 활성화되어, 고난도 사례에 대한 인간 가이드를 선택적으로 수집하고 Coactive Calibration을 수행하여 Judge의 정확도를 개선합니다. 실험 결과, VeriFine은 자율 주행 및 로봇 내비게이션 태스크에서 Reinforcement Fine-Tuning (RFT) 및 Supervised Fine-Tuning (SFT) 모두에 걸쳐 지속적인 성능 향상을 입증했습니다. 특히, 기존 방식 대비 높은 Reasoning Accuracy와 Success Rate를 기록하며, Policy와 Judge가 상호 보완적으로 성장하는 효과를 정량적으로 증명했습니다.
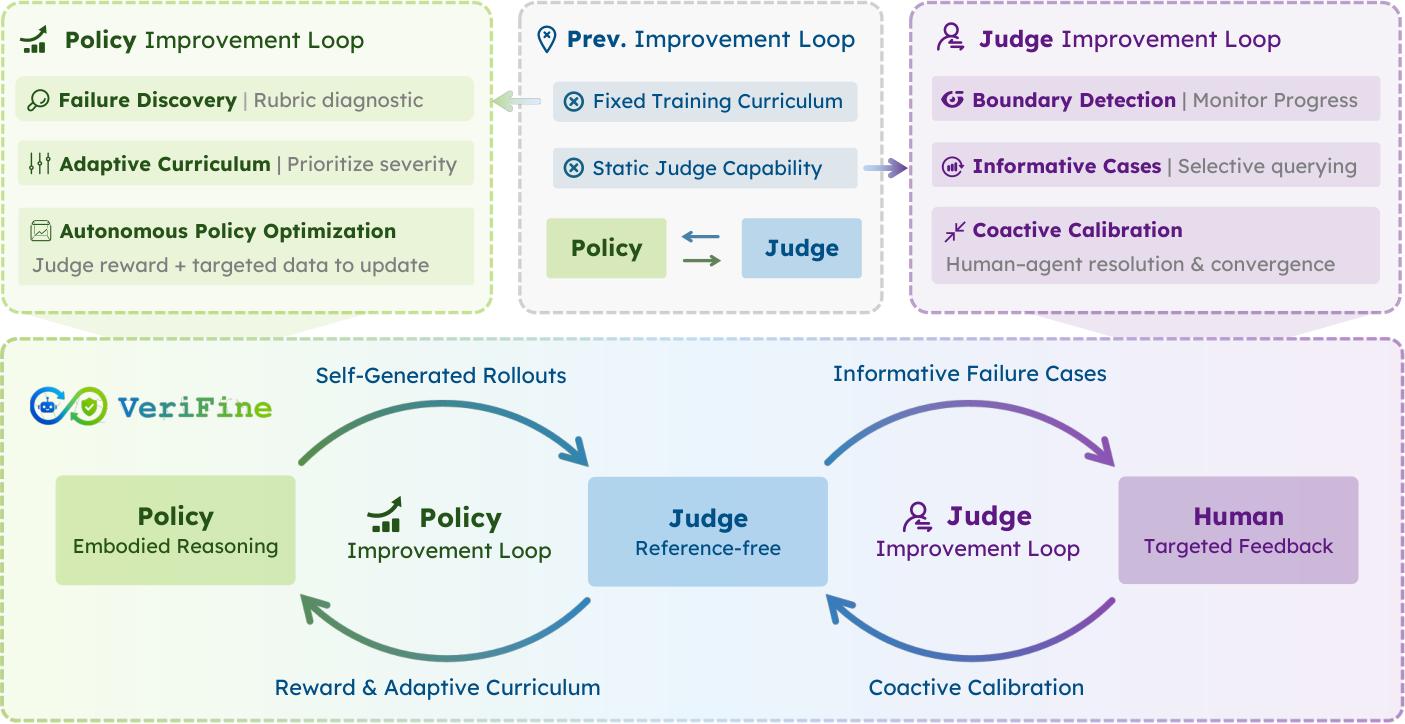
Figure 2 — Policy와 Judge의 동반 진화 구조
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Embodied Reasoning 시스템에서 Verification을 단순한 평가 도구가 아닌, Policy와 함께 진화하는 능동적 구성 요소로 전환함으로써 continuous self-improvement를 실현했습니다. 제안된 Co-evolution 메커니즘은 대규모 모델 학습 시 Verification의 병목 현상을 타개할 중요한 돌파구를 마련했습니다. 이 연구는 자율 주행, 로봇 공학 등 물리적 상호작용이 중요한 분야에서 더 안전하고 신뢰할 수 있는 모델을 구축하는 데 기여하며, 향후 더 복잡한 추론 태스크로의 일반화 가능성을 제시합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] ClawGym II: Exploring Black-Box RL on Agent Harness
- [논문리뷰] Evo-Bench: Can Language Models Improve Agent Harness?
- [논문리뷰] Bootstrapping Task Spaces for Self-Improvement
- [논문리뷰] Data-Centric Recursive Self-Improvement for Navigation via Policy-Synchronized Language-Action Dual Bootstrapping
- [논문리뷰] Rethinking Relative Policy Differences Transfer of On-Policy Distillation
Review 의 다른글
- 이전글 [논문리뷰] Understanding and Enhancing Backdoor Persistency in LLM Agent Post-Training
- 현재글 : [논문리뷰] VeriFine: Scaling Verification for Self-Improvement in Embodied Reasoning
- 다음글 [논문리뷰] World Action Learning via Interaction-Centric Spectral Latent Guidance
댓글