[논문리뷰] Data-Centric Recursive Self-Improvement for Navigation via Policy-Synchronized Language-Action Dual Bootstrapping
링크: 논문 PDF로 바로 열기
저자: Songze Li, Haoming Gu, Ziyang Gong, Zhitong Wang, et al.
1. Key Terms & Definitions
- RSI-Nav: Vision-Language Navigation (VLN)을 위해 제안된 데이터 중심(data-centric) 재귀적 자가 개선(recursive self-improvement) 프레임워크입니다.
- Policy-Synchronized Dual Bootstrapping: 현재 모델(policy)이 unlabeled trajectory에 대한 instruction을 생성하고 실행하여 검증한 뒤, qualified samples로 즉시 모델을 업데이트하는 데이터 생성 및 학습 메커니즘을 의미합니다. 이는 생성된 supervision이 evolving policy와 지속적으로 동기화되도록 합니다.
- Vision-Language Navigation (VLN): 에이전트가 자연어 명령에 따라 시각 환경에서 목표 위치로 이동하는 작업입니다.
- Instruction Following (VL2A): Vision-language 입력을 바탕으로 에이전트가 행동을 예측하여 navigation 명령을 따르는 태스크입니다.
- Instruction Generation (VA2L): Vision-action 이력으로부터 자연어 명령을 생성하는 역방향 태스크입니다.
- Spatial Understanding: 에이전트가 환경 내의 객체 관계, 방향 등을 이해하는 능력으로, navigation 의사 결정에 필수적인 요소입니다.
2. Motivation & Problem Statement
Vision-Language Navigation (VLN)에서 고품질의 언어 supervision은 에이전트가 자연어 명령을 따라 목표 위치에 도달하는 데 필수적입니다. 그러나 인간 주석(human annotation)은 비용이 많이 들기 때문에, 확장 가능한 데이터 합성(data synthesis) 방법의 필요성이 대두되었습니다. 기존 데이터 합성 방법론들은 주로 navigation과 instruction generation을 별도의 모델로 처리하거나, 두 태스크를 task-specific component를 통해 연결하여 양방향 언어-액션 학습의 이점을 제한하는 한계를 가집니다. 더욱이, 대부분의 기존 접근 방식은 전체 trajectory corpus에 대해 고정된 모델로 먼저 주석을 단 후 업데이트를 진행하므로, 생성된 supervision이 evolving policy보다 뒤처지는(lag behind) 문제가 발생하여 모델과 데이터 간의 불일치가 심화될 수 있습니다.
3. Method & Key Results
저자들은 이러한 한계점을 극복하기 위해 RSI-Nav라는 데이터 중심 재귀적 자가 개선 프레임워크를 제안합니다. RSI-Nav는 instruction following (vision-language-to-action)과 instruction generation (vision-action-to-language), 그리고 spatial understanding을 Qwen3.5-9B를 기반으로 한 단일 공유 모델 내에서 통합합니다. 이 방법론의 핵심은 policy-synchronized dual bootstrapping 메커니즘으로, 모델이 초기 supervised fine-tuning을 통해 기본 역량을 확립한 후, unlabeled continuous trajectory corpus를 작은 shard 단위로 순차적으로 처리합니다. 각 shard에 대해 현재 모델은 instruction을 생성하고, 이를 실행하여 목표 달성(goal completion)과 경로 효율성(path efficiency)을 평가합니다. 이때 goal completion은 최종 위치가 목표 3m 이내인지, 효율성은 SPL (Success weighted by Path Length) 임계값을 만족하는지 기준으로 판단하며, qualified samples만 다음 학습에 활용됩니다. 이러한 shard-wise update를 통해 모델은 다음 shard를 처리하기 전에 즉시 업데이트되어, 새로 생성된 supervision이 evolving policy와 밀접하게 동기화됩니다.
RSI-Nav는 R2R-CE 및 RxR-CE Val-Unseen 벤치마크에서 기존 방법론 대비 강력한 navigation 성능을 달성했습니다. 특히, R2R-CE에서 68.6% SR (Success Rate)과 58.6% SPL을 기록했으며, RxR-CE에서는 72.4% SR, 56.5% SPL, 그리고 70.6 nDTW (normalized Dynamic Time Warping)를 달성했습니다 [Table 1]. 이는 supervised initialization (RSI-Nav Cold Start) 대비 R2R-CE SR이 52.9%에서 68.6%로, SPL이 45.5%에서 58.6%로 크게 향상된 수치입니다 [Table 1]. 또한, RSI-Nav는 VSI-Bench, ScanQA, SQA3D, MindCube와 같은 spatial understanding 벤치마크에서도 초기 checkpoint 대비 모든 벤치마크에서 미미하지만 일관된 성능 향상(예: ScanQA 93.2에서 96.4로 증가)을 보여, navigation 성능 향상과 spatial understanding 능력이 공존함을 입증했습니다 [Table 1]. ablation study 결과, 256 candidates per GPU의 granularity로 policy를 업데이트할 때 가장 우수한 SR 및 SPL 성능을 보였으며 [Table 3], instruction generation (VA2L) 데이터를 추가했을 때 navigation SR이 44.7%에서 48.8%로, SPL이 38.6%에서 41.0%로 개선되어 dual learning의 이점을 확인했습니다 [Table 2].
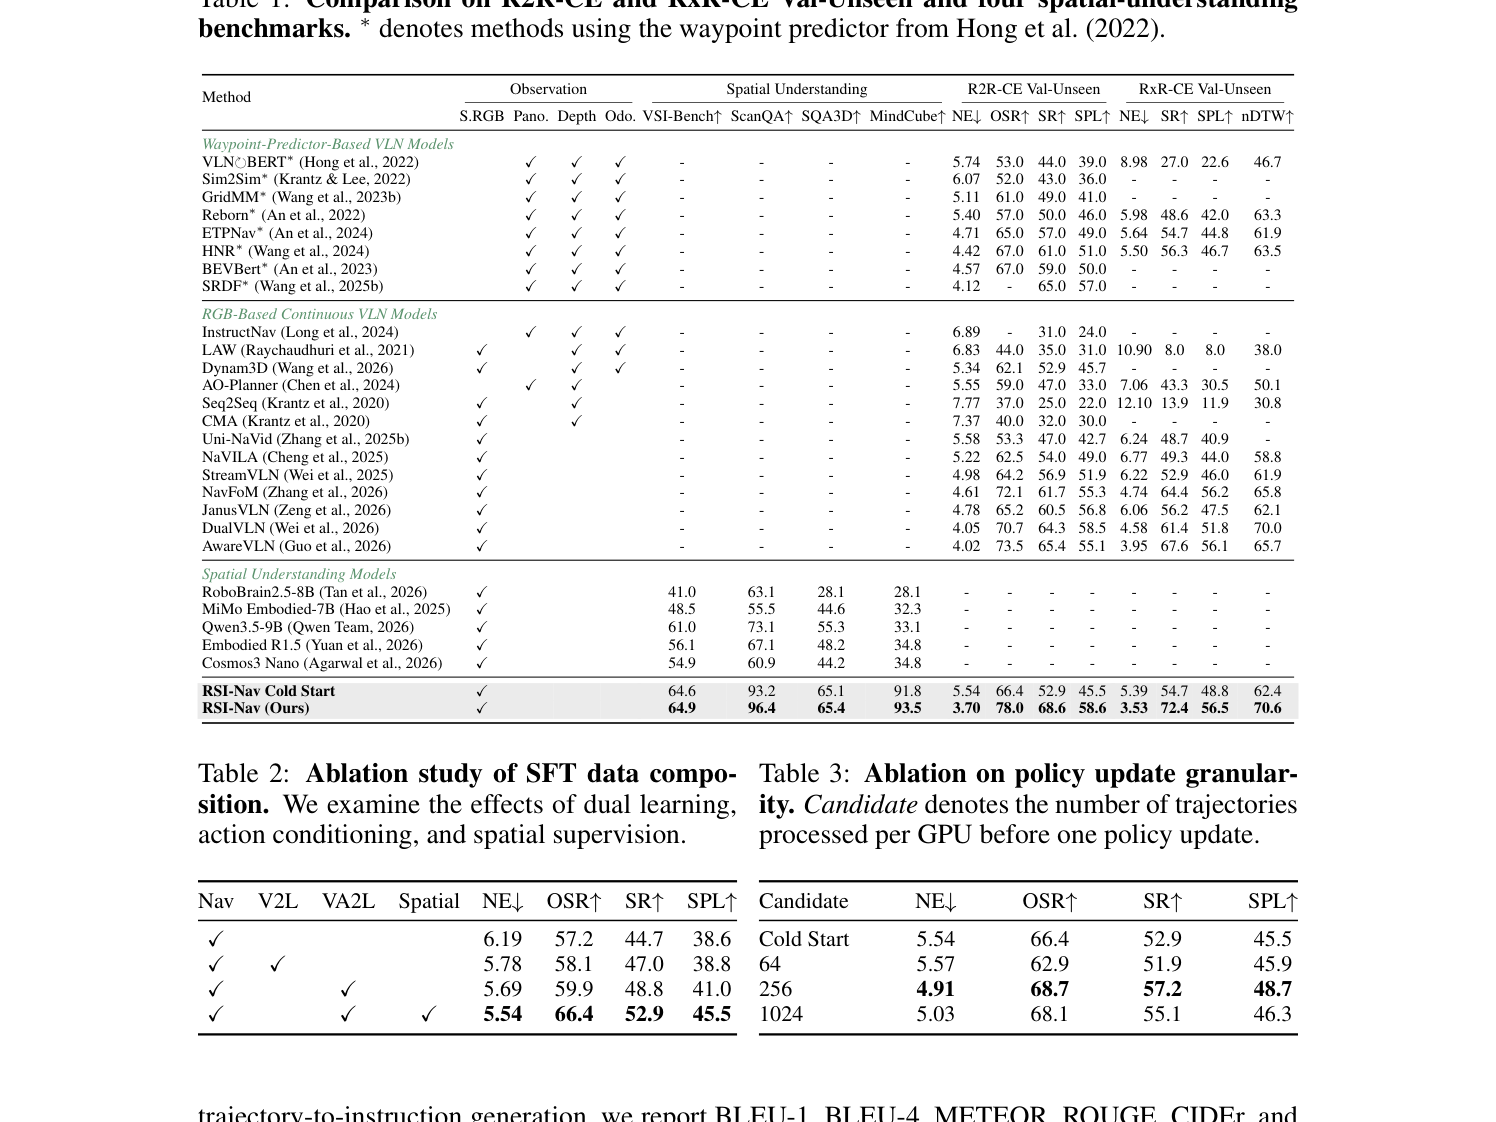
Table 1 — RSI-Nav의 주요 navigation 및 spatial understanding 벤치마크 성능을 기존 SOTA 방법들과 정량적으로 비교하는 핵심 결과 테이블.
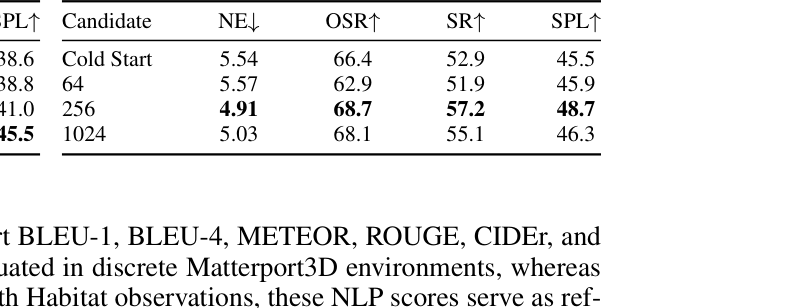
Table 3 — Policy update granularity가 모델 성능에 미치는 영향을 분석한 ablation study 결과로, policy-synchronized 학습의 핵심 구성 요소.
4. Conclusion & Impact
RSI-Nav는 instruction following, instruction generation, 그리고 spatial understanding을 단일 공유 모델 내에서 통합하고, policy-synchronized language-action dual bootstrapping을 통해 unlabeled trajectory를 효과적으로 supervision으로 전환하는 데이터 중심 자가 개선 프레임워크입니다. 이 접근 방식은 생성된 supervision이 evolving policy와 지속적으로 동기화되도록 하여, 모델의 재귀적 성능 향상을 가능하게 합니다. 본 연구는 대규모 unlabeled navigation trajectory를 자가 생성 및 필터링된 supervision으로 활용하여 모델을 개선하는 확장 가능한 방향을 제시하며, 이는 더 나은 모델이 다음 개선을 위한 더 나은 훈련 데이터를 생산하는 재귀적 과정의 중요성을 강조합니다. RSI-Nav는 복잡한 실제 환경에서의 navigation task를 성공적으로 수행할 수 있는 잠재력을 보여주며, embodied AI 분야의 자가 개선 학습 패러다임 발전에 중요한 시사점을 제공합니다.
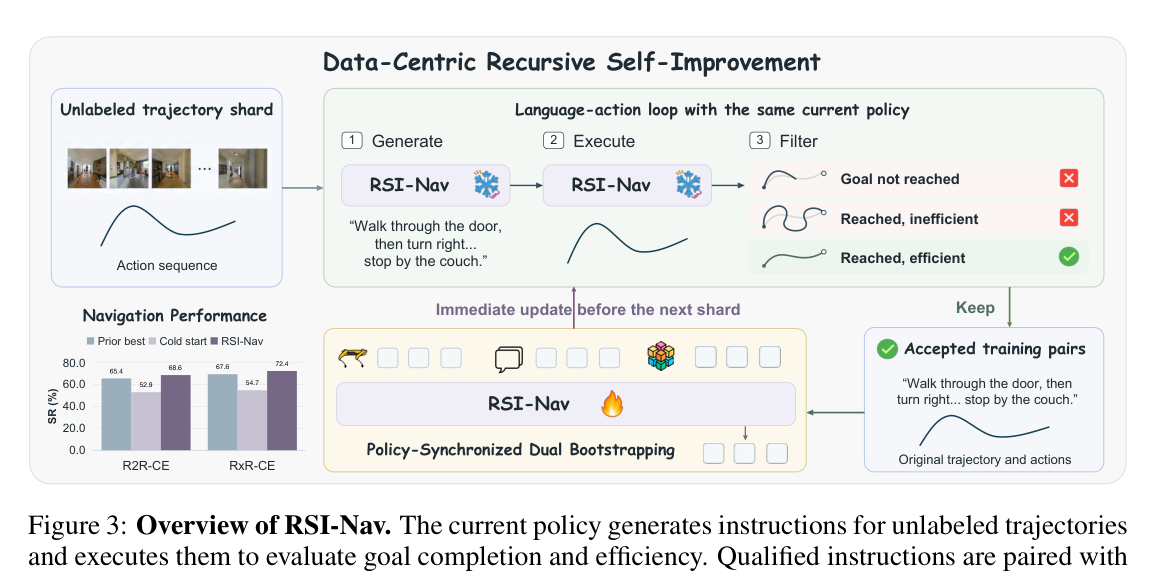
Figure 3 — 제안하는 RSI-Nav 프레임워크의 전체적인 데이터 흐름과 재귀적 자가 개선 루프를 상세하게 보여주는 핵심 다이어그램.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] MiMo-V2.6: Scaling Reinforcement Learning Towards Self-Improvement
- [논문리뷰] VeriFine: Scaling Verification for Self-Improvement in Embodied Reasoning
- [논문리뷰] GUI-HARVEST: Self-Improving GUI Agents through Evidence-Driven Harness Evolution
- [논문리뷰] Scaling Trajectories for Complex Tasks through Recursive Self-Rewrite
- [논문리뷰] Learning Meta-Skills for Agent Harness Design in Test-Time AI4AI
Review 의 다른글
- 이전글 [논문리뷰] CineRecon: Benchmarking Frontier Models for Agentic Cinematic Reconstruction
- 현재글 : [논문리뷰] Data-Centric Recursive Self-Improvement for Navigation via Policy-Synchronized Language-Action Dual Bootstrapping
- 다음글 [논문리뷰] DoSA: Dots Sparse Attention
댓글