[논문리뷰] LeWAM: End-to-End World and Action Modeling with JEPAs
링크: 논문 PDF로 바로 열기
저자: Minghao Fu, Tavis Siebert, Eryk Halicki, Randall Balestriero
1. Key Terms & Definitions (핵심 용어 및 정의)
- Joint-embedding predictive architectures (JEPAs): 픽셀 재구성(pixel reconstruction) 없이 압축된 잠재 월드 모델(latent world models)을 학습하는 아키텍처를 지칭합니다.
- SIGReg (Spherical Isotropic Gaussian Regularization): 잠재 공간(latent space)의 다양성(diversity)을 보존하고 표현 붕괴(representation collapse)를 방지하기 위해 사용되는 정규화 기법입니다. 이는 잠재 상태(latent state)에 등방성 가우시안 분포(isotropic Gaussian distributional constraint)를 적용합니다.
- Action Flow Matching: 노이즈가 있는 액션 청크(noisy action chunks)의 경로 속도(path velocity)를 회귀(regress)함으로써 확률적 정책 학습(stochastic policy learning)을 수행하는 방법론입니다.
- Mixture-of-Transformers (MoT): 예측기(predictor) 내에서 잠재 상태(latent states)와 액션(actions) 같은 다양한 양상(modalities)이 마스크된 셀프-어텐션(masked self-attention)을 공유하면서도 각 양상별로 독립적인 프로젝션(projection)을 적용할 수 있도록 하는 아키텍처입니다.
- Visual Planning: 시각적 관측(visual observations)과 목표 이미지(goal image)를 기반으로 목표 상태(goal state)에 도달하기 위한 액션을 계획하는 제어 패러다임입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 자율 에이전트(autonomous agents)의 시각 제어(visual control)에서 액션의 결과(consequences of actions)를 효과적으로 예측하는 근본적인 문제를 해결하고자 합니다. 기존의 Joint-embedding predictive architectures (JEPAs)는 시각적 표현(visual representations)과 액션-조건부 다이내믹스(action-conditioned dynamics)를 일반적으로 분리하여 학습하며, 이후에 제어 정책(control policy)을 추가하는 파이프라인을 사용합니다. 이러한 접근 방식은 액션 감독(action supervision)과 시각 표현 학습(visual representation learning) 간의 단절을 야기하여, 모델이 제어에 중요한 정보를 안정적으로 유지하지 못하고 시간적으로 지속되는 방해 요소(temporally persistent distractors)나 불필요한 관측 정보를 포함할 수 있다는 한계가 있습니다. 더욱이, 기존 모델들을 통한 제어는 Cross-Entropy Method (CEM)와 같은 온라인 솔버(online solver)에 의존하는 경우가 많으며, 이는 액션 차원(action dimensionality)이나 계획 Horizon이 증가할수록 광범위한 롤아웃(extensive rollouts)을 요구하여 계산 비용이 높고, 접촉이 많은(contact-rich) 작업에서는 다이내믹스(dynamics) 모드 전환(mode switching)으로 인해 로컬 액션 최적화(local action optimization)가 복잡해지는 문제가 있습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 이러한 한계점을 극복하기 위해 표현(representation), 액션-조건부 다이내믹스(action-conditioned dynamics), 그리고 확률적 정책(stochastic policy)을 단일 학습 단계(single training stage)에서 함께 학습하는 End-to-End JEPA인 LeWAM을 제안합니다. LeWAM의 훈련은 다음 잠재 상태 예측(next latent state prediction)과 액션 Flow Matching에 대한 공동 훈련 목표(joint training objective)를 결합하며, 잠재 상태에 SIGReg 제약(constraint)을 적용하여 잠재 다양성(latent diversity)을 보존합니다. 예측기(predictor)는 Mixture-of-Transformers (MoT) 아키텍처를 사용하여 상태 브랜치(state branch)와 액션 브랜치(action branch)가 정보를 공유하면서도 각자의 목표를 달성하도록 설계되었습니다. 이 모델은 학습된 액션 분포(learned action distribution)에서 샘플링된 액션 시퀀스(action sequences)를 경사하강법(gradient descent)으로 정제하는 계획 절차(planning procedure)를 통해 효율적인 시각 계획(visual planning)을 지원합니다 [Figure 4, cite: 1].
실험 결과, LeWAM은 시각 계획에서 뛰어난 성능을 보였습니다. 특히, 이전 JEPA 기반 모델(예: LeWM (CEM))과 비교하여 접촉이 많은(contact-rich) 작업에서 성공률을 28.6%에서 89.7%로, 장기 Horizon(long-horizon) 작업에서는 10.9%에서 46.2%로 향상시켰습니다 [Figure 6, Figure 7, cite: 1]. 또한, LeWAM은 CEM 기반 방법론보다 32.3배 빠르게 계획을 수행하여, 계획 효율성(planning efficiency) 측면에서도 상당한 개선을 이루었습니다. 행동 복제(Behavior Cloning) 시뮬레이션 및 실제 로봇 제어(Physical Robot Control) 작업에서는 Diffusion Policy 및 π0.5와 같은 기존 Baseline과 경쟁력 있는 성능을 보였습니다. 선형 탐침(Linear probes) 분석 결과, LeWAM은 제어에 중요한 표현(control-relevant representations)을 학습하며, SIGReg 및 확률적 액션 분포 모델링(stochastic action distribution modeling)이 계획 성능(planning performance)과 표현 품질(representation quality)에 결정적인 역할을 한다는 것이 확인되었습니다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 미래 잠재 상태(future latent states)와 액션(actions)을 동시에 예측하는 End-to-End Joint-embedding predictive architecture (JEPA)인 LeWAM을 성공적으로 제안합니다. LeWAM은 계획(planning)과 정책 실행(policy execution)을 통해 제어를 지원하며, 특히 동역학 기반 계획(dynamics-based planning)에서 기존 JEPA 기반 월드 모델(world models) 대비 향상된 성능을 보여주었습니다. 또한, 시뮬레이션 및 실제 로봇 환경에서의 행동 복제(behavior cloning)에 있어서도 기존 정책 Baseline들과 경쟁력 있는 결과를 달성했습니다. 이 연구는 표현 학습(representation learning), 다이내믹스 모델링(dynamics modeling), 그리고 정책 학습(policy learning)을 긴밀하게 통합함으로써, 시각 제어(visual control)의 효율성과 효과성을 크게 높였습니다. 이는 로봇 공학 및 자율 에이전트(autonomous agents) 분야에 중요한 시사점을 제공하며, 특히 복잡하고 접촉이 많은 조작 작업(contact-rich manipulation tasks)에 대한 확장 가능하고 강력한 프레임워크를 제시하여 실제 응용 가능성을 넓혔습니다.
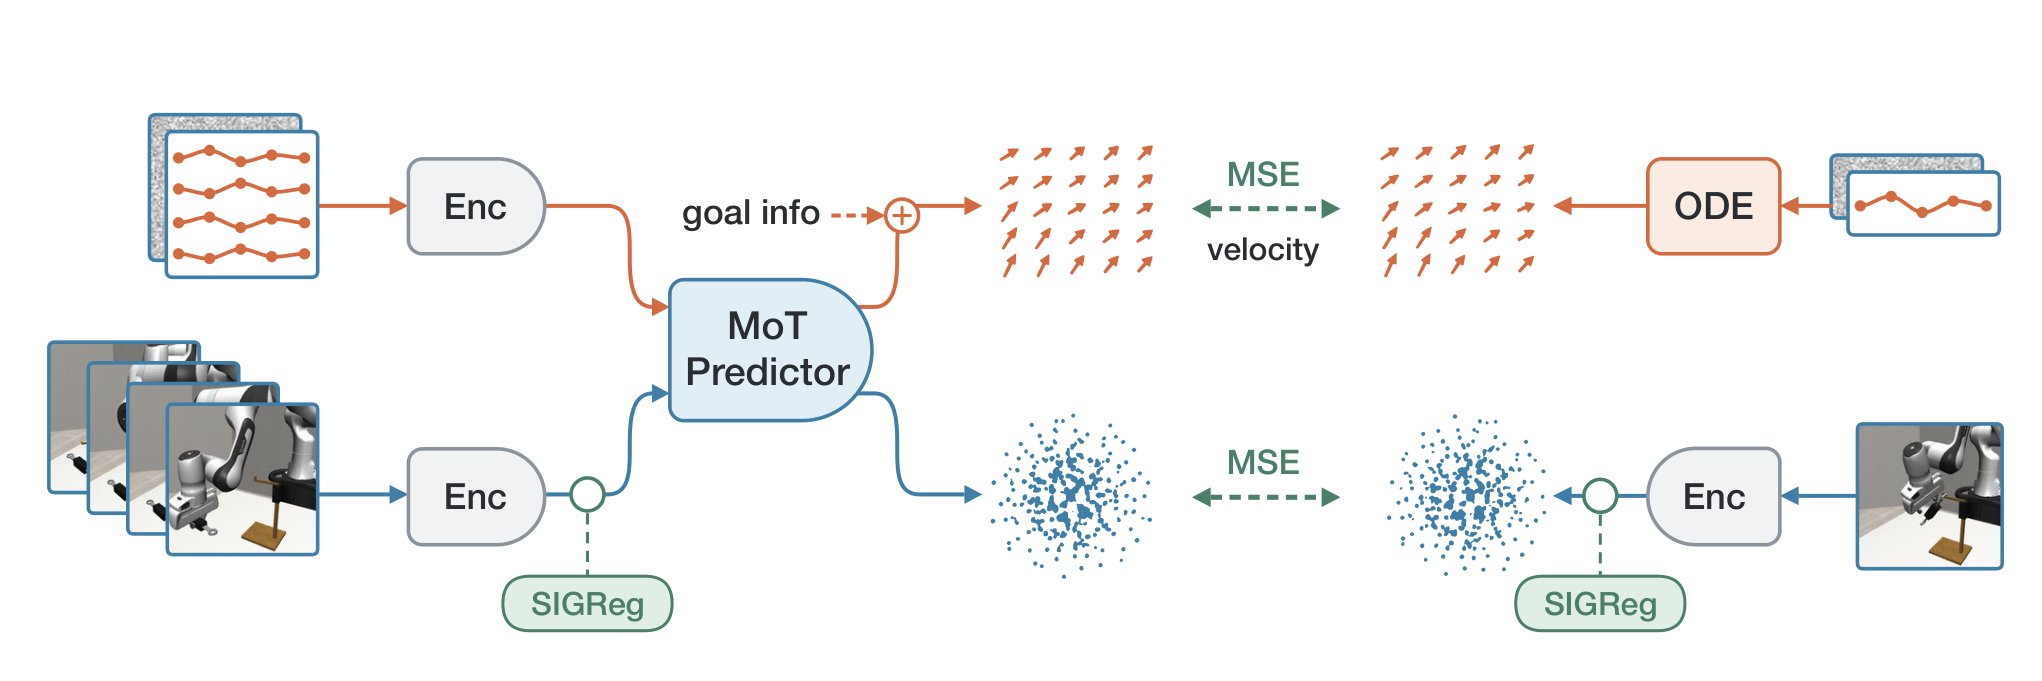
Figure 1 — LeWAM 훈련 아키텍처
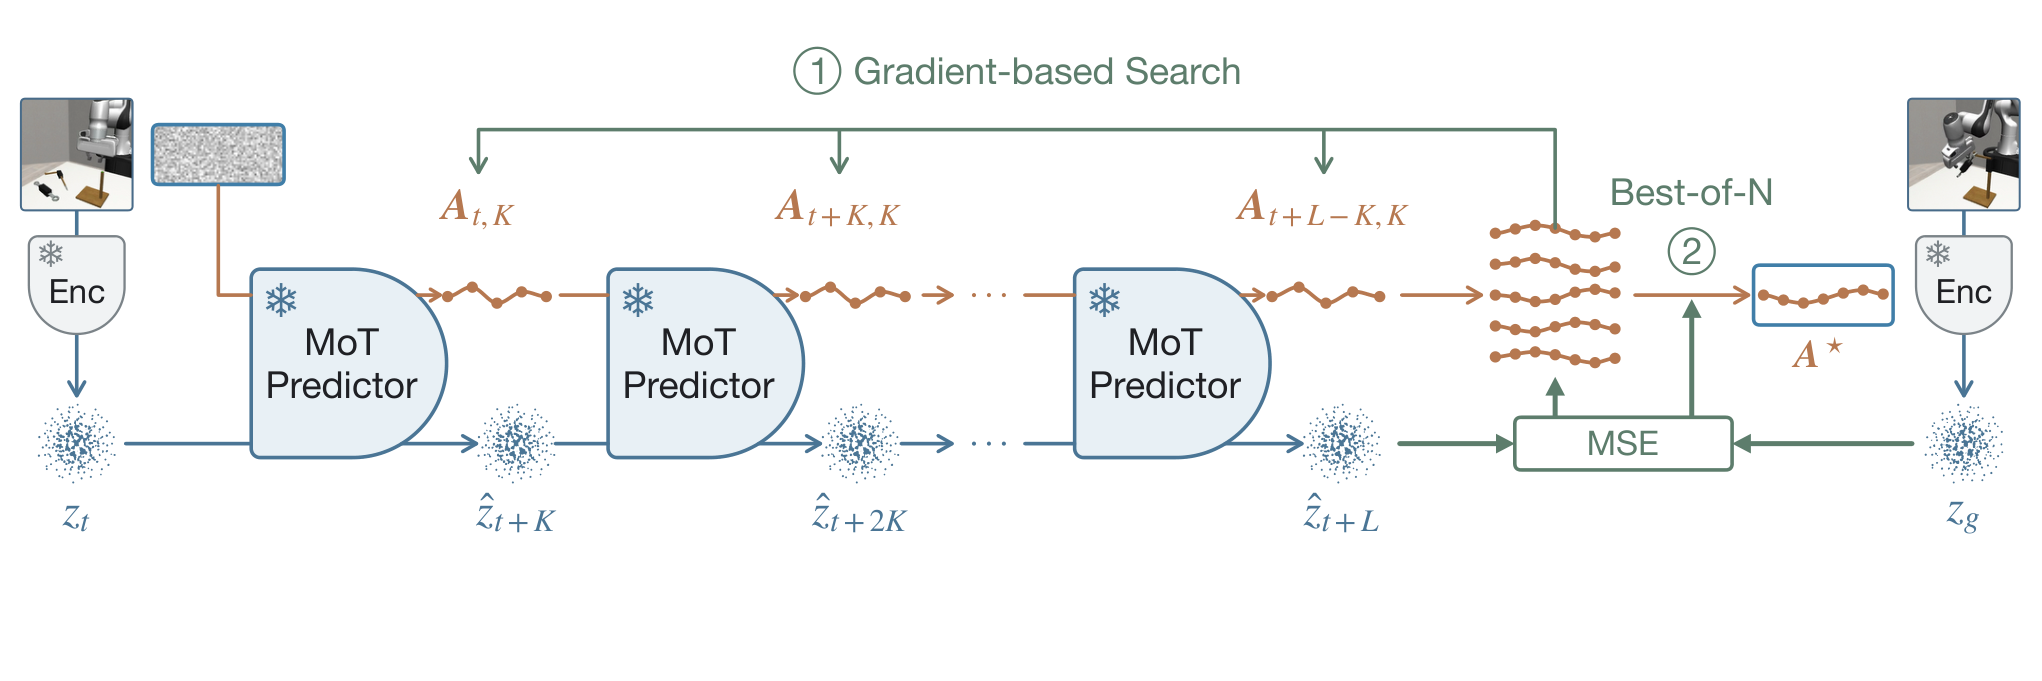
Figure 4 — LeWAM 계획 절차
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] Jeva: System One Models from First Principles
- 현재글 : [논문리뷰] LeWAM: End-to-End World and Action Modeling with JEPAs
- 다음글 [논문리뷰] Learning How to Remember: Memory Modality Selection for GUI Agents
댓글