[논문리뷰] GroundGUI: GUI Grounding by High-Quality Data and Distillation-to-Reinforcement Learning
링크: 논문 PDF로 바로 열기
저자: Qingsong Xie, Jiahao Tian, Jiacheng Tang, Zhifeng Li, Madalina Ciobanu, Navan Preet Singh, Qingqing Mao, Ritankar Das, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- GUI Grounding: 자연어 의도(natural language intents)를 화면상의 실행 가능한 UI 컴포넌트(actionable on-screen components)에 정확히 매핑하는 능력입니다.
- ScreenRef Dataset: 본 논문에서 제안하는 포괄적인 GUI grounding 데이터셋으로, GUI 스크린샷과 자연어 참조 표현(referring expressions), 그리고 박스 또는 포인트 어노테이션(box or point annotations)으로 구성됩니다.
- Distillation-to-Reinforcement Learning (D2RL): Supervised fine-tuning(SFT)의 제한된 일반화 능력과 Reinforcement Learning(RL)의 희소한 보상(sparse reward) 문제를 해결하기 위해 제안된 2단계 post-training 방법론입니다.
- On-Policy Self-Distillation (OPSD): D2RL 방법론의 첫 번째 단계로, teacher 모델로부터 dense token-level supervision을 받아 학생 모델의 더 나은 초기 정책(initial policy)을 형성하는 데 기여합니다.
- REINFORCE Leave-One-Out (RLOO): D2RL 방법론의 두 번째 단계로, OPSD로 학습된 정책을 기반으로 GUI grounding task-level click reward를 직접적으로 최적화하여 모델의 일반화 및 localization 정확도를 향상시킵니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 robust한 GUI Agent를 구축하는 데 필수적인 multimodal visual grounding의 어려움, 특히 자연어 명령을 UI 요소의 픽셀 좌표에 정확하게 매핑하는 것의 도전 과제를 다룹니다. 기존 연구들은 상업적 모델의 폐쇄적인 데이터(proprietary large-scale data)로 인해 우수한 성능을 보였으나, 커뮤니티에는 접근할 수 없다는 한계가 있었습니다. 또한, 공개된 데이터셋(open-source datasets)은 다양성(diversity)과 정확도(accuracy)가 제한적이어서 모델 성능이 저조했습니다. 기존의 supervised fine-tuning (SFT) 방식은 특정 도메인에 과적합(overfit)되는 경향이 있으며, Reinforcement Learning (RL) 접근 방식은 어려운 샘플(hard samples)에서 모든 rollout이 실패하여 zero reward를 받는 "sparse reward problem"에 직면해 있었습니다. 이러한 기존 방법론의 한계와 고품질 데이터의 부족 문제를 해결하기 위해 새로운 데이터셋과 학습 방법론이 필요했습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 ScreenRef라는 대규모 고품질 GUI grounding 데이터셋과 Distillation-to-Reinforcement Learning (D2RL) 방법론을 제안하여 GUI grounding 성능을 크게 향상시켰습니다. ScreenRef는 데스크톱, 웹, 모바일 환경을 아우르는 586K개의 스크린샷과 633K개 이상의 referring expression 인스턴스로 구성됩니다. 이 데이터셋은 text recognition, visual matching, spatial understanding, 그리고 refusal 시나리오와 같은 광범위한 grounding task를 포함합니다. 데이터셋 구축은 screenshot crawling (Accessibility Trees, DOM, XML layout)과 tutorial video crawling의 두 가지 경로를 통해 이루어지며, LLM을 활용한 multi-stage filtering 및 verification 과정을 거쳐 고품질 데이터를 확보합니다 [Figure 1].
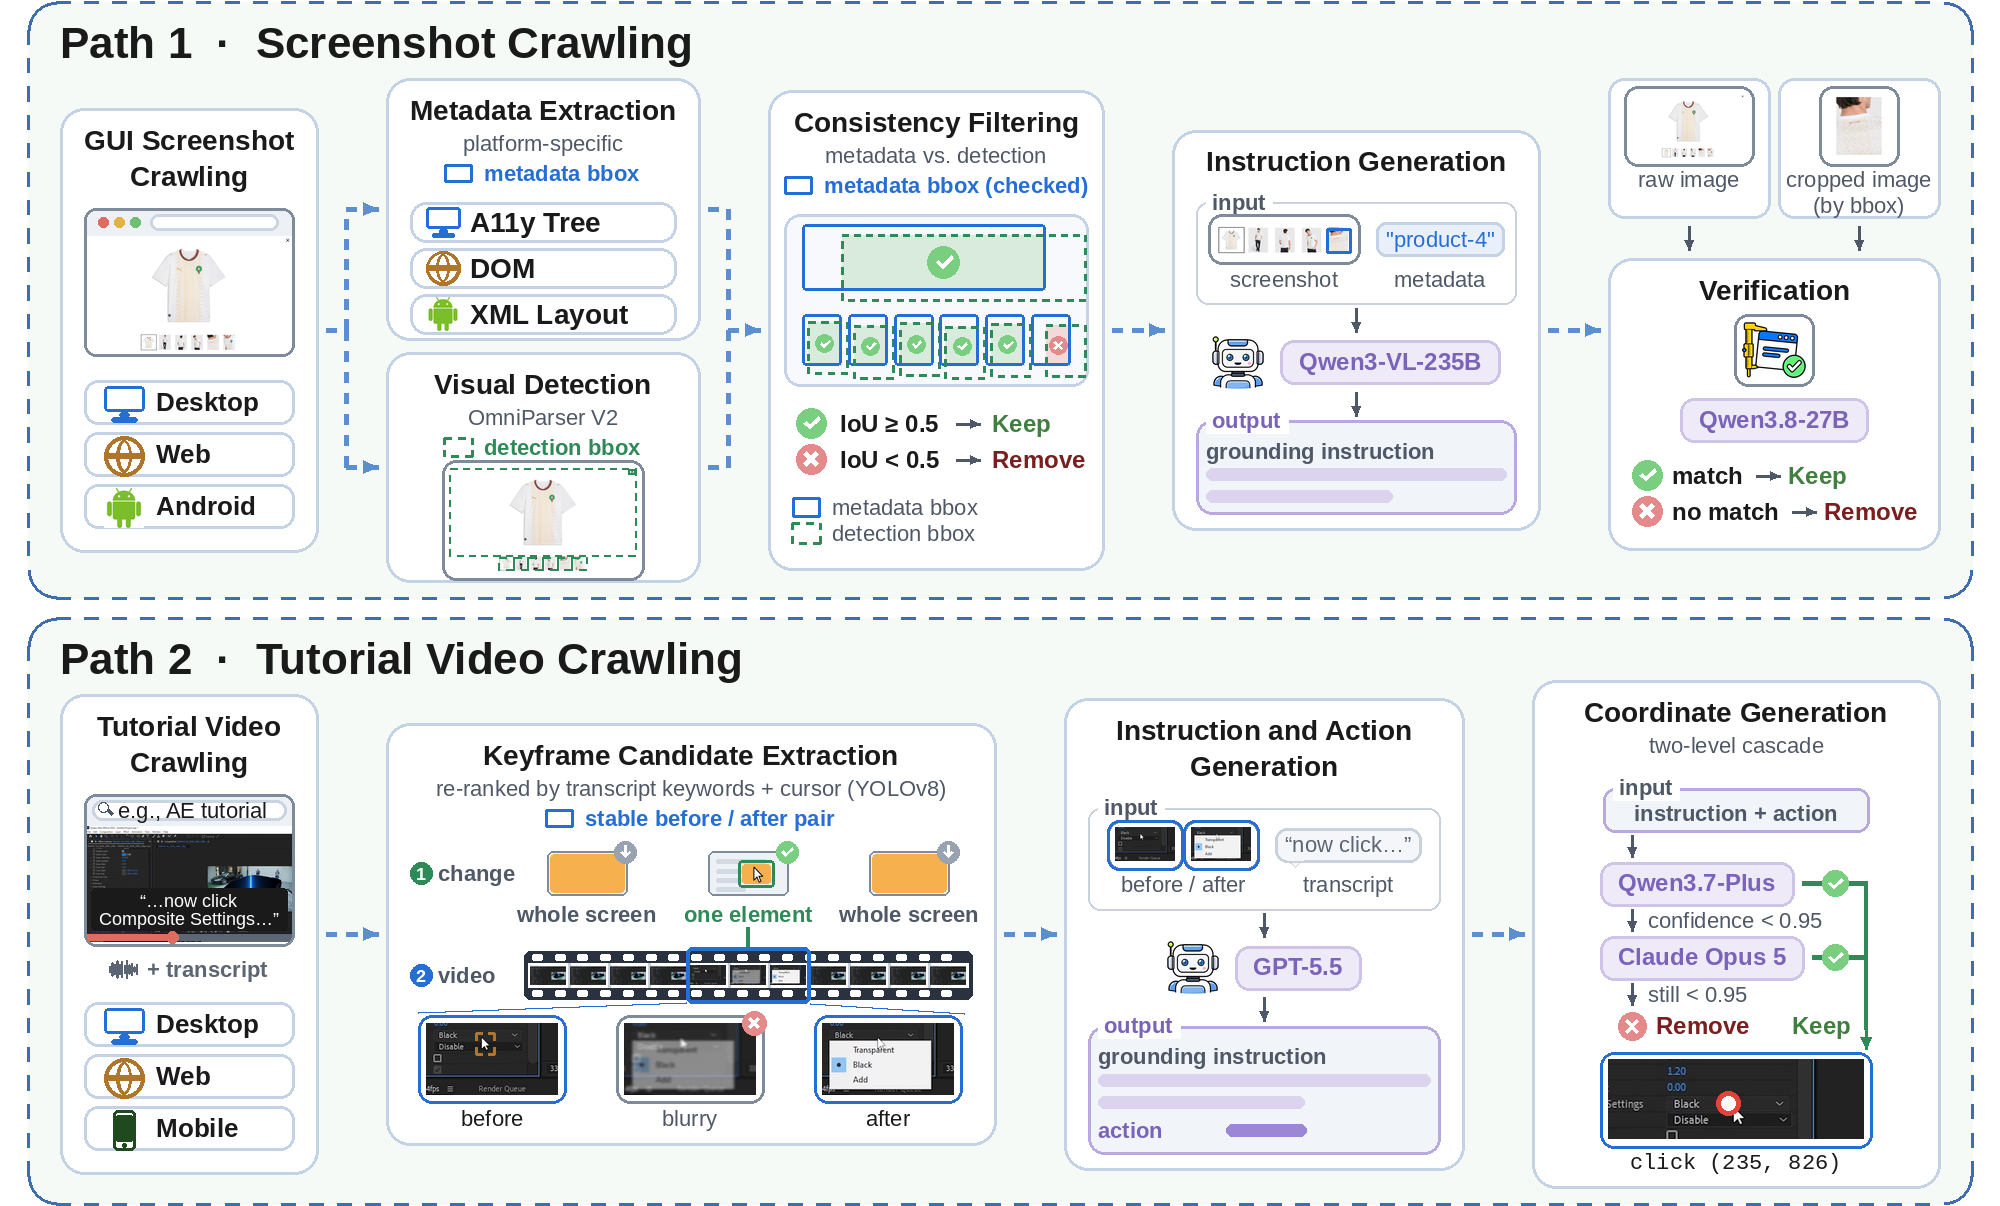
Figure 1 — ScreenRef 데이터 구축 파이프라인
제안하는 D2RL은 SFT 이후에 적용되는 2단계 post-training 프레임워크입니다 [Figure 2]. 첫 번째 단계인 On-Policy Self-Distillation (OPSD)은 ground-truth bounding box를 볼 수 있는 teacher 모델로부터 dense token-level supervision을 제공하여 학생 모델이 RL 최적화에 앞서 더 강력한 초기 정책을 형성하도록 돕습니다. 이 OPSD는 좌표 digit token에 position-aware weighting을 적용하여 localization에 중요한 좌표 결정에 더 큰 비중을 둡니다. 두 번째 단계인 REINFORCE Leave-One-Out (RLOO)는 OPSD로 훈련된 정책을 기반으로 original 스크린샷 observation 하에서 grounding 정책을 최적화하며, point-in-box reward를 사용하여 task-level click reward를 직접적으로 개선합니다.
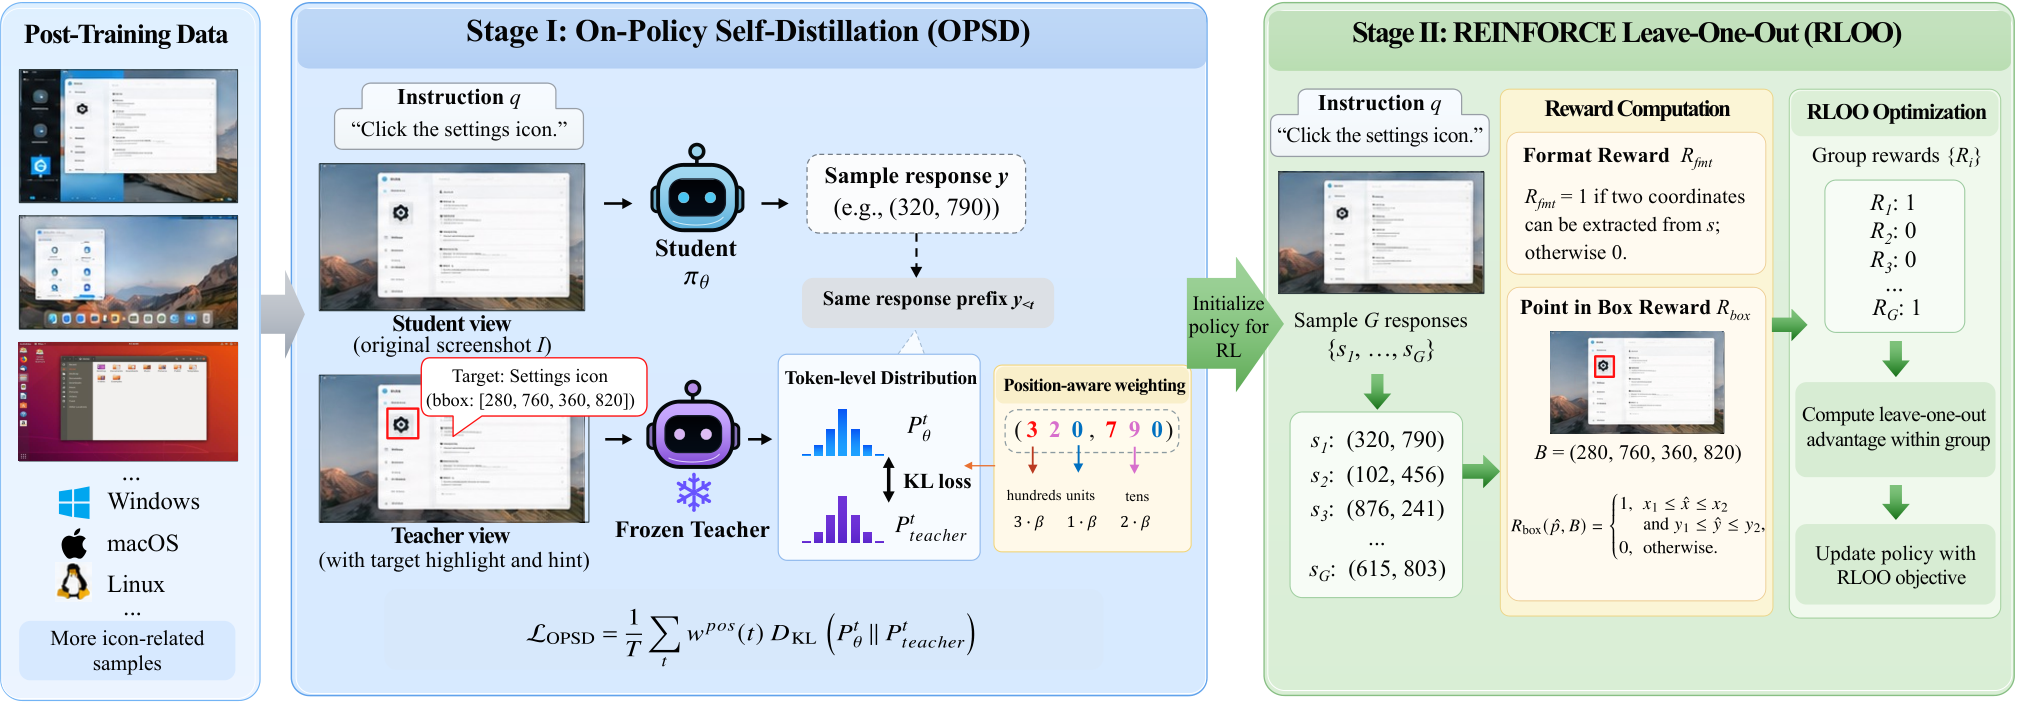
Figure 2 — D2RL 방법론 개요
이러한 ScreenRef 데이터셋과 D2RL 방법론을 활용하여 훈련된 GroundGUI-8B 모델은 다양한 벤치마크에서 뛰어난 성능을 입증했습니다. GroundGUI-8B는 ScreenSpot-V2에서 95.2%, ScreenSpot-Pro에서 63.9%, OSWorld-G에서 65.4%, MMBench-GUI L2에서 86.8%, 그리고 UI-Vision에서 38.3%의 정확도를 달성했습니다. 특히, GroundGUI-8B는 Qwen3-VL-8B 대비 ScreenSpot-V2에서 3.5%p, MMBench-GUI L2에서 5.5%p, ScreenSpot-Pro에서 14.0%p, OSWorld-G에서 10.6%p, UI-Vision에서 20.8%p의 상당한 성능 향상을 보였습니다. 또한, 8B-scale 모델 중에서는 Holo2-8B 및 Step-GUI-8B와 같은 closed-source 데이터로 훈련된 모델들과 유사하거나 더 우수한 성능을 보였으며, 여러 32B-scale 모델(예: ScaleCUA-32B, OpenCUA-32B, GTA1-32B)보다도 강력한 결과를 달성했습니다. 이는 제안된 데이터와 방법론이 GUI grounding task에서 모델의 일반화 및 정확도를 크게 개선함을 시사합니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 high-quality data와 advanced training 기법의 중요성을 강조하며, GUI grounding을 위한 대규모 데이터셋인 ScreenRef와 혁신적인 학습 방법론인 Distillation-to-Reinforcement Learning (D2RL)을 제안합니다. 이를 통해 학습된 GroundGUI-8B 모델은 5가지 주요 벤치마크에서 기존의 open-source 모델들을 월등히 능가하며, closed-source 데이터로 훈련된 선도적인 모델들과도 경쟁하거나 더 나은 성능을 달성했습니다.
이 연구는 GUI Agent 분야에 두 가지 주요한 시사점을 제공합니다. 첫째, ScreenRef 데이터셋은 다양한 환경에서 multimodal grounding을 위한 실제 시나리오를 제공하며, 이는 향후 GUI Agent 연구를 위한 귀중한 공개 자원이 될 것입니다. 둘째, D2RL 방법론은 SFT의 한계와 RL의 sparse reward 문제를 효과적으로 해결하여, grounding 모델의 일반화 및 정확도를 크게 향상시켰습니다. 결과적으로, GroundGUI-8B는 적은 파라미터 수로도 높은 성능을 보여, open-source 모델과 proprietary 모델 간의 성능 격차를 줄이는 데 중요한 기여를 하며, GUI 기반 자동화 및 인간-컴퓨터 상호작용 분야의 발전을 가속화할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] HyperClick: Advancing Reliable GUI Grounding via Uncertainty Calibration
- [논문리뷰] Ferret-UI Lite: Lessons from Building Small On-Device GUI Agents
- [논문리뷰] Branching On-Policy Distillation
- [논문리뷰] Kandinsky 6.0 Video: Foundation Models for Synchronized Video and Audio Generation
- [논문리뷰] SoL-Refiner: Speed-of-Light One-Step Refinement for High-Resolution Video
Review 의 다른글
- 이전글 [논문리뷰] Glance Forcing: Making Bidirectional Diffusion Autoregressive at a Glance
- 현재글 : [논문리뷰] GroundGUI: GUI Grounding by High-Quality Data and Distillation-to-Reinforcement Learning
- 다음글 [논문리뷰] HumanoidToolBench: Benchmarking Humanoid Tool Use from Selection to Mobile Execution
댓글