[논문리뷰] Player-1: Learning to Play from Synthetic Experience
링크: 논문 PDF로 바로 열기
메타데이터
저자: Mingyu Ouyang, Yiran Wang, Siyuan Hu, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Computer-Use Agent (CUA): 스크린을 해석하고 keyboard와 mouse action을 통해 디지털 인터페이스를 제어하는 AI 에이전트.
- Action Space: 에이전트가 환경과 상호작용하는 규격으로, 본 논문에서는
Relative pointer motion,Sustained inputs,Composite actions를 포함하도록 확장됨. - Player-1-Gym: 제어 요구사항(aiming, combat 등)을 공유하는 16개의 2D 및 3D 합성 환경 모음으로,
Verifiable rewards를 통해 학습을 지원함. - RLVR (Reinforcement Learning with Verifiable Rewards): 환경의 상태 변화로부터 계산된 프로그래밍 가능한 보상을 활용하여 에이전트를 최적화하는 학습 기법.
- SFT (Supervised Fine-Tuning): 정제된 gameplay trajectory를 사용하여 에이전트의 초기 행동 패턴을 학습시키는 과정.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 기존 게임 에이전트 학습 파이프라인이 대규모 시연(demonstration)에 과도하게 의존하며, 정작 동적인 게임 상태에 대한 대응력이 부족하고 확장 가능한 환경을 확보하기 어렵다는 문제를 해결하고자 한다. 기존 연구들은 환경과의 상호작용을 통해 학습을 지속하는 데 한계가 있었으며, 다양한 게임 환경에 보편적으로 적용 가능한 보상 체계를 구축하는 데 어려움을 겪었다. 저자들은 이러한 제약을 극복하기 위해 합성 환경을 이용한 사후 학습(post-training) 프레임워크인 Player-1을 제안한다 [Figure 1]. 이 접근 방식은 단순한 시연 모방을 넘어, 제어 능력을 강화하고 학습된 정책이 새로운 게임 환경으로 일반화(generalization)될 수 있도록 설계되었다.
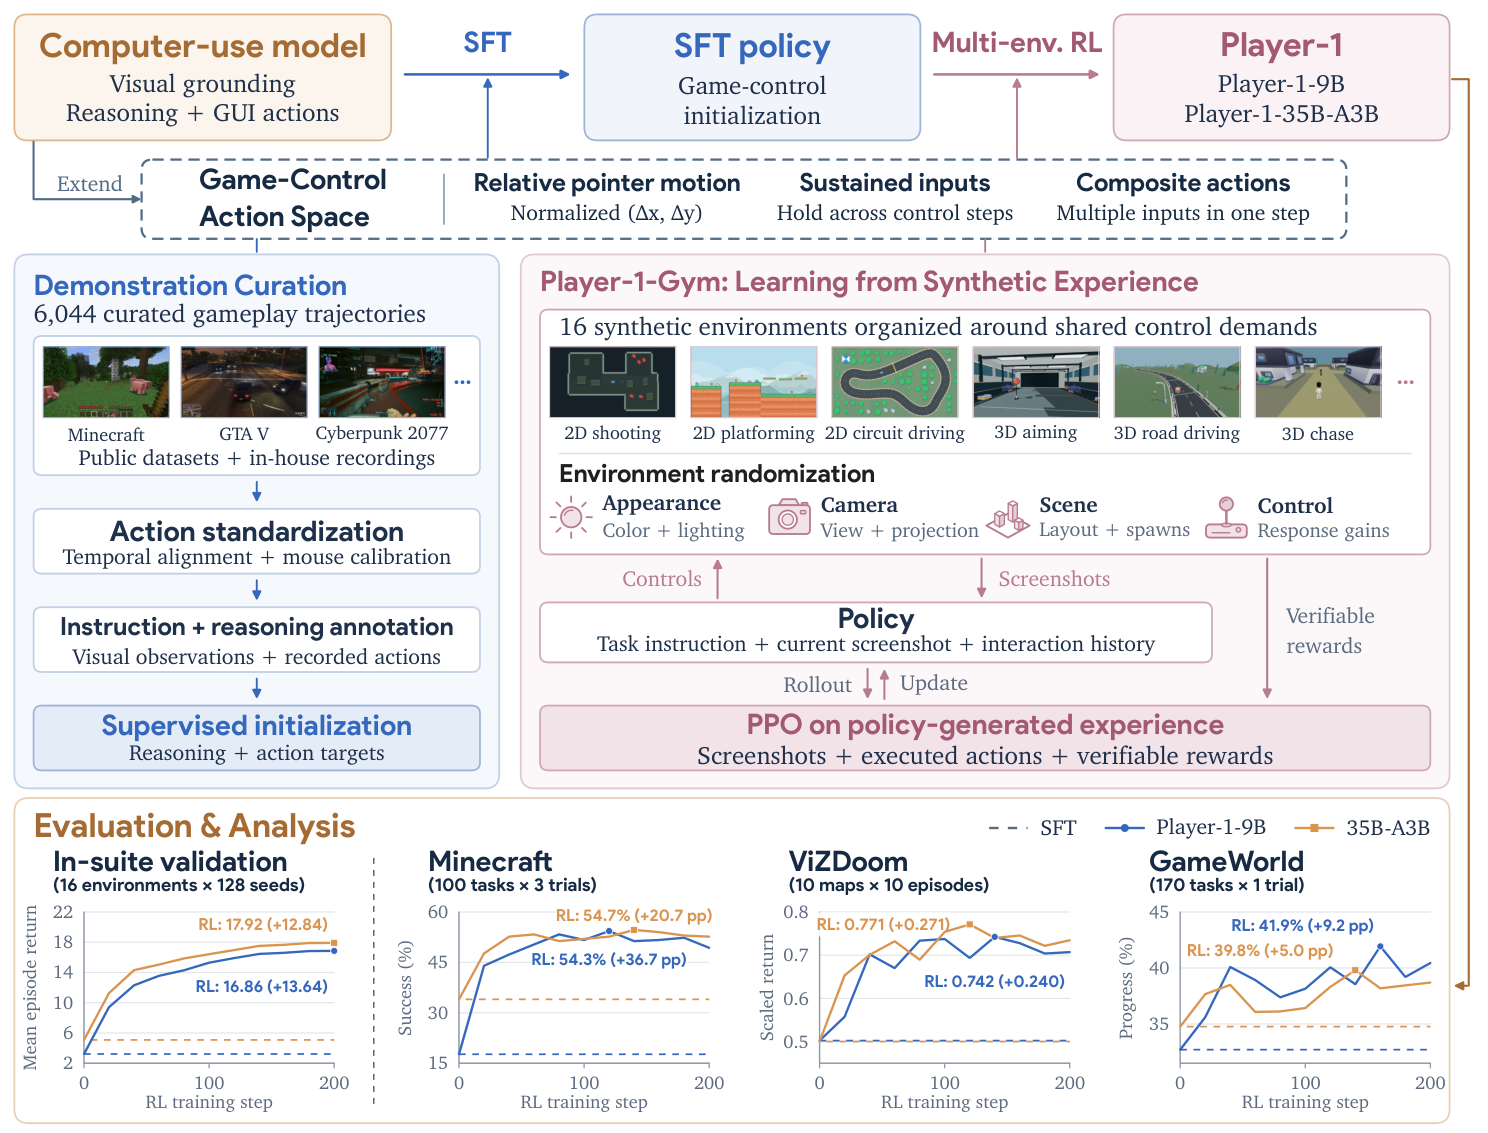
Figure 1 — Player-1 전체 프레임워크
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Player-1 프레임워크를 통해 컴퓨터 제어 행동 공간을 확장하고, 이를 Player-1-Gym이라는 합성 환경에서 강화학습을 통해 고도화하는 방법론을 제안한다 [Figure 1]. 저자들은 기존의 절대 좌표 기반 제어에서 벗어나 상대적 포인터 이동, 지속적 입력, 복합 행동(Composite actions)을 포함하는 확장된 행동 공간을 정의하였다 [Figure 2]. 이후 6,044개의 정제된 시연 데이터로 SFT를 수행하여 모델을 초기화하고, PPO 알고리즘과 RLVR을 활용하여 16개의 합성 환경에서 정책을 최적화하였다 [Figure 3]. 실험 결과, Player-1-9B 모델은 MineDojo-300 벤치마크에서 SFT 대비 27.8%p 높은 성공률(38.33%)을 기록하며 가장 강력한 외부 베이스라인을 큰 폭으로 상회하였다 [Table 2]. 또한, ViZDoom-10과 GameWorld와 같은 학습 환경 밖의 게임에서도 뛰어난 일반화 성능을 보여주며 제어 역량의 확장성을 증명하였다 [Table 3, Table 4]. 추가 분석에서는 강화학습 과정 중 복합 행동의 사용 빈도가 자연스럽게 증가함이 확인되어, 에이전트가 작업 지향적인 제어 능력을 스스로 학습함을 입증하였다.
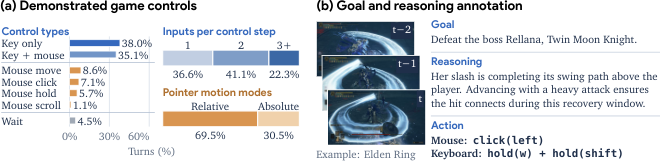
Figure 2 — 시연 데이터 및 행동 분포
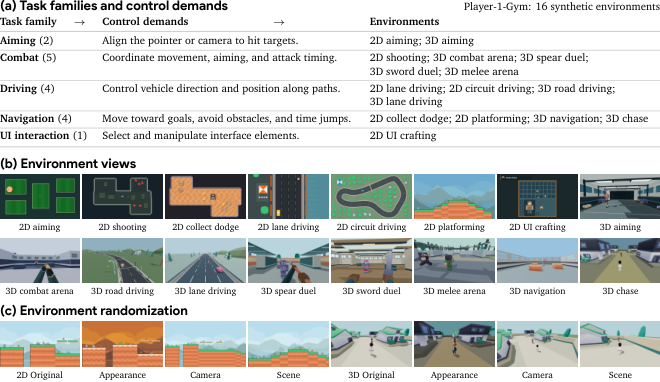
Figure 3 — Player-1-Gym 환경 구성
4. Conclusion & Impact (결론 및 시사점)
본 연구는 합성 경험(synthetic experience)을 활용한 사후 학습이 에이전트의 게임 제어 능력을 비약적으로 향상시킬 수 있음을 입증하였다. 정제된 시연 기반의 초기화와 Player-1-Gym의 합성 환경을 결합한 이 프레임워크는, 타겟 게임별 온라인 학습 없이도 높은 일반화 성능을 확보할 수 있는 효율적인 솔루션을 제공한다. 본 연구의 결과는 향후 디지털 환경에서의 범용적인 컴퓨터 제어 에이전트 발전에 중요한 기술적 토대가 될 것으로 기대된다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] HybridCUA: Learning to Orchestrate GUI and CLI for Computer-Use Agents
- [논문리뷰] MintAct: A Unified Visual Agent for Digital Environments
- [논문리뷰] VBVR-Pro: A Scalable and Verifiable Suite for Native Visual Reasoning
- [논문리뷰] Is Next-Chunk Reasoning RL Really Better than SFT? Revisiting Training Strategies under no-CoT Data
- [논문리뷰] From RLVR to RLSVR: Task Transformation Induces Self-Verifiable Rewards for Open-Ended LLM Self-Improvement
Review 의 다른글
- 이전글 [논문리뷰] More Methods, Better Agents? A Reality Check on Self-Distillation in Agentic Reinforcement Learning
- 현재글 : [논문리뷰] Player-1: Learning to Play from Synthetic Experience
- 다음글 [논문리뷰] ProgAgent: Learning Tool Orchestration through Programmatic Training
댓글