[논문리뷰] OmniXRef: A Unified Framework for Multimodal Multi-Reference Video Editing
링크: 논문 PDF로 바로 열기
메타데이터
저자: Xiaoyan Cong, Tianyu Wang, Hyeonho Jeong, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- OmniXRef-Model: Multimodal(text, image, video) references를 사용하여 source video를 편집하는 unified framework 기반의 단일 스트림 diffusion transformer 모델.
- Reference-bank: 각 편집 작업의 지침(instruction)과 시각적 참조(image/video)를 체계적으로 조직화하여 입력하는 공통 인터페이스.
- Mix-Patchify (MP): 비디오 편집 작업의 특성에 따라 입력되는 reference의 spatial granularity를 동적으로 조정하여 연산 효율을 높이는 기법.
- R^2-RoPE (RoPE with Reserved Reference Slots): 학습 단계에서 reference slot을 예약하고 임의로 할당함으로써, 추론 시 학습보다 더 많은 reference를 유연하게 수용할 수 있도록 개선된 positional encoding 기법.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 현대의 영상 제작에서 텍스트, 이미지, 비디오 등 다양한 양식의 참조를 동시에 활용하여 복잡한 창의적 의도를 반영하는 편집 모델의 부재를 해결한다. 기존의 편집 연구들은 단일 양식의 참조에 국한되거나, 특정 작업(예: camera control)에만 특화되어 있어 여러 참조를 결합한 통합적 편집이 어렵다는 한계가 있다. 저자들은 이러한 제약을 극복하기 위해 참조의 개수, 양식, 속성(Attribute), 조합을 포괄하는 통합적인 OmniXRef 프레임워크를 제안한다 [Figure 1].
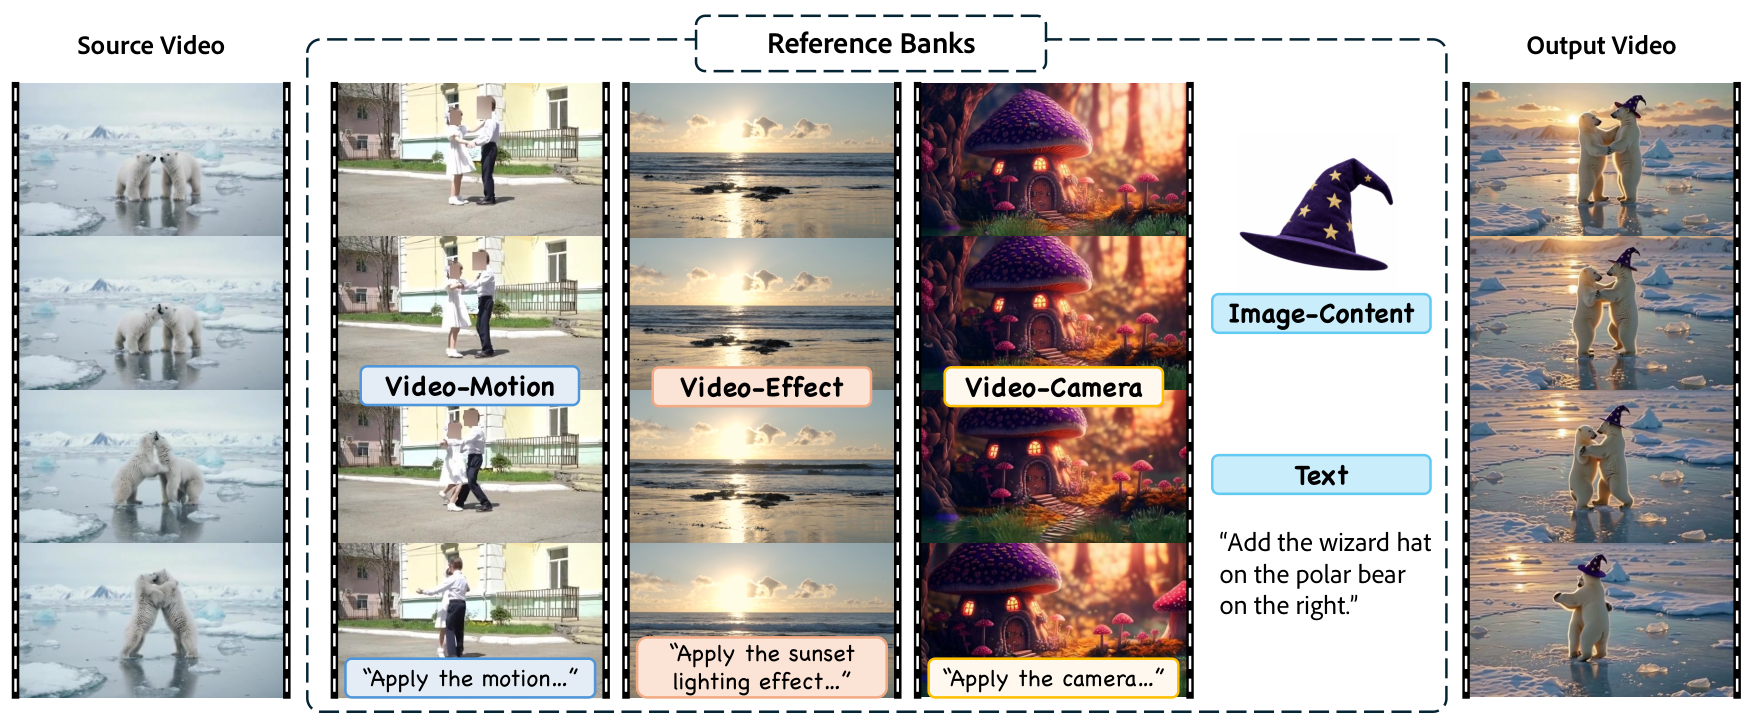
Figure 1 — 다중 참조 편집 예시
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 MLLM(Qwen3-VL-8B-Instruct)과 단일 스트림 DiT를 결합하여 소스 영상과 다중 참조 뱅크를 처리하는 OmniXRef-Model을 제안한다 [Figure 2]. Mix-Patchify 기법을 통해 참조 데이터의 spatial granularity를 작업에 맞게 최적화함으로써 연산 비용을 획기적으로 절감하였고, R^2-RoPE를 도입하여 참조 개수의 확장성을 확보하였다 [Figure 2]. 또한, 약 10M 개의 학습 데이터로 구성된 OmniXRef-Data를 통해 학습하였으며, 교육 과정을 단계적으로 설계한 Curriculum Learning을 통해 성능을 극대화하였다. 실험 결과, OmniXRef-Model은 OmniXRef-Bench의 모든 카테고리(Content, Style, VFX, Camera, Motion)에서 기존의 task-specific 모델 및 상용 모델인 Seedance 2.5, MiniMax-H3 대비 월등한 Reference Adherence (RA) 및 Source Preservation (SP) 성능을 입증하였다 [Table 2]. 특히 카메라 궤적 정확도 평가에서 RotErr 0.874, TransErr 3.961을 기록하며 타 모델 대비 압도적인 정밀도를 보였다 [Table 3].
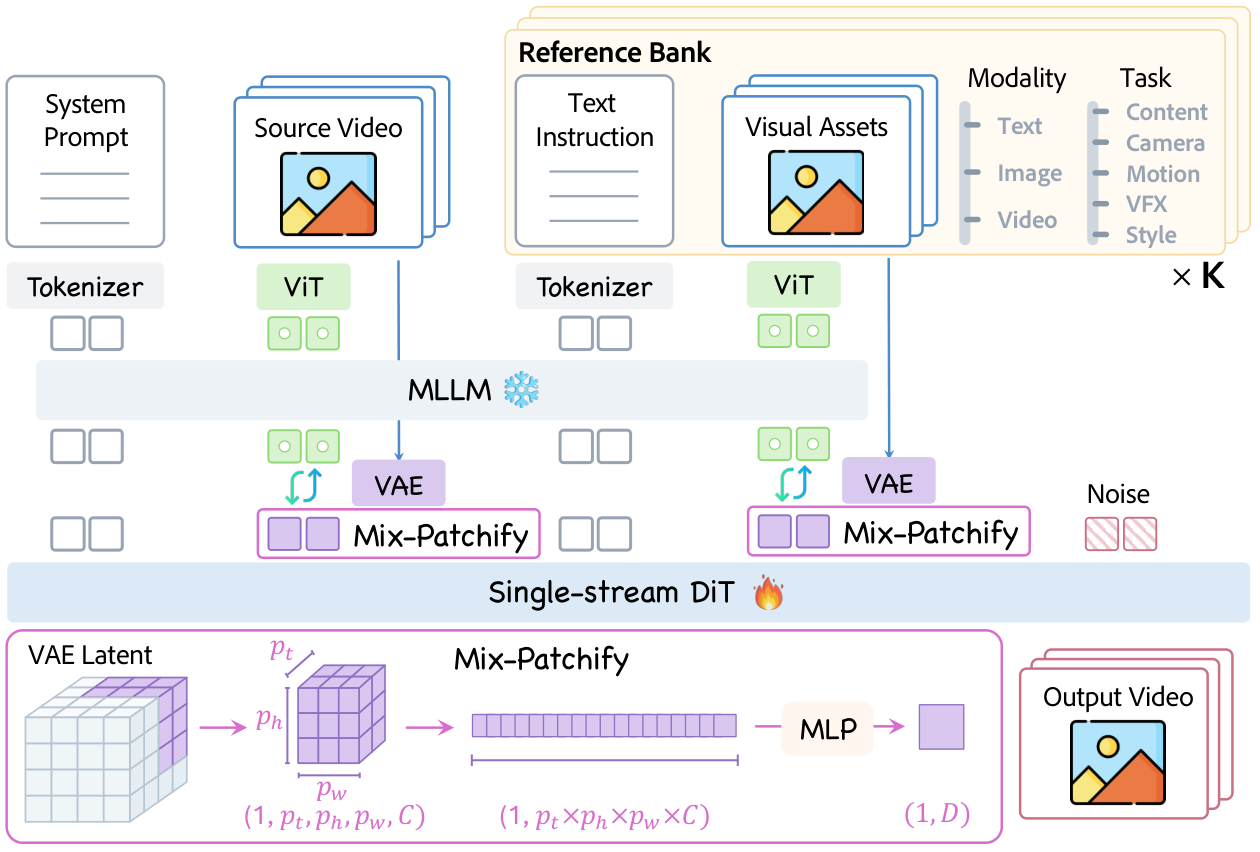
Figure 2 — OmniXRef 모델 구조
4. Conclusion & Impact (결론 및 시사점)
본 논문은 다중 참조를 통한 비디오 편집의 새로운 표준인 OmniXRef를 제시하며, 비디오 편집 연구가 단순 텍스트 기반에서 복합 다중 모달 제어 방식으로 전환되는 계기를 마련했다. 제안된 프레임워크는 참조의 개수나 양식에 구애받지 않는 유연성을 갖추어, 실제 미디어 산업 현장에서의 고도화된 편집 워크플로우를 자동화하는 데 핵심적인 역할을 할 것으로 기대된다. 또한, 정량적 평가를 위한 OmniXRef-Bench는 향후 비디오 생성 및 편집 모델의 평가 프로토콜로서 학계에 중요한 기여를 할 것이다.
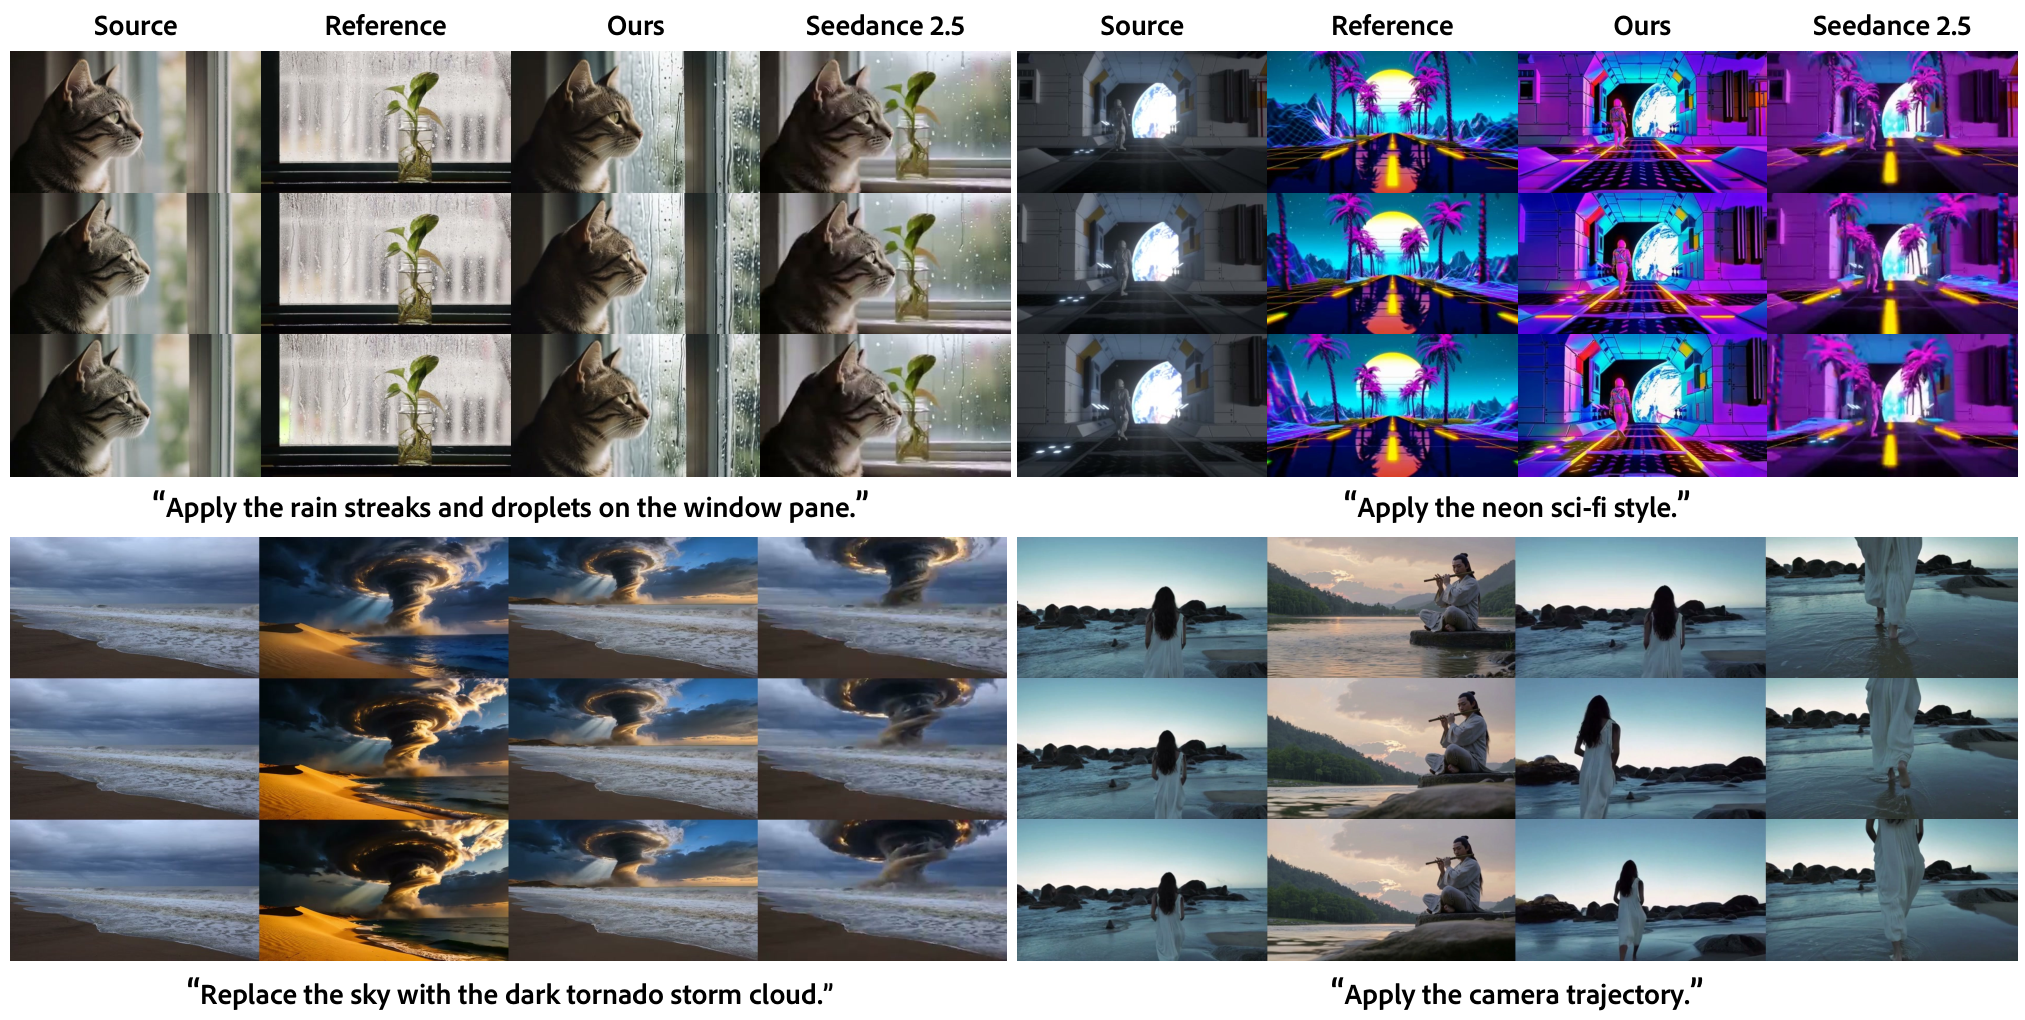
Figure 3 — 정성적 비교 결과
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LooseControlVideo: Directorial Video Control using Spatial Blocking
- [논문리뷰] Bernini: Latent Semantic Planning for Video Diffusion
- [논문리뷰] Kiwi-Edit: Versatile Video Editing via Instruction and Reference Guidance
- [논문리뷰] SkyReels-V4: Multi-modal Video-Audio Generation, Inpainting and Editing model
- [논문리뷰] VINO: A Unified Visual Generator with Interleaved OmniModal Context
Review 의 다른글
- 이전글 [논문리뷰] OfficeTown: Generative Organizations for Evolving Agent Intelligence
- 현재글 : [논문리뷰] OmniXRef: A Unified Framework for Multimodal Multi-Reference Video Editing
- 다음글 [논문리뷰] OpenMobile-2: Building Versatile Mobile Agents with Scalable Environments and App-Native Tools
댓글