[논문리뷰] Tree-Aware Posterior Distillation for Long-Horizon Agentic Reinforcement Learning
링크: 논문 PDF로 바로 열기
메타데이터
저자: Heming Zou, Qi Wang, Yixiu Mao, Yun Qu, Yuyi Guo, Zeyuan Liu, Chenglin Li, Weijie Liu, Saiyong Yang, Xiangyang Ji, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- TreeOPSD: 긴 호흡의 에이전트 작업에서 critic 없이 tree-based 롤아웃을 통해 효율적인 신용 할당(credit assignment)과 분포 매칭을 수행하는 프레임워크.
- Initialize-then-expand: 공유된 접두사(prefix)에서 다수의 경로를 브랜칭하여 롤아웃 트리를 구성함으로써 sparse한 환경에서 turn-level 신용을 산출하는 샘플링 기법.
- Forward KL (Kullback-Leibler): 학생 정책(student policy)을 frozen behavior policy 기반의 정교한 교사(teacher) 분포에 투영하여 policy drift를 방지하는 최적화 목적 함수.
- Turn-level Credit (Vi): 에이전트의 각 단계(turn)가 최종 결과에 기여하는 정도를 tree backup을 통해 산출한 scalar 값.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 긴 호흡의 에이전트 작업에서 terminal reward 기반의 학습이 겪는 credit assignment의 sparse함과 고분산 문제, 그리고 학습 과정에서의 policy staleness 문제를 해결하는 것을 목표로 한다. 기존의 Actor-Critic 방식은 critic 학습의 복잡성과 가치 평탄화(value flattening)에 취약하며, PPO와 같은 중요도 샘플링 기반 방법은 고정된 롤아웃 배치 내에서 정책이 학습되면서 발생하는 drift를 효과적으로 통제하지 못한다. [Figure 1]에서 제시하는 바와 같이, 긴 상호작용 단계에서 단일 terminal reward를 분산하는 것은 무익한 행동에 과도한 보상을 할당하는 원인이 된다. 따라서 저자들은 명시적인 가치 모델 없이도 보상을 효과적으로 전달하고, 순차적인 학습 과정에서 타겟 분포로 수렴할 수 있는 새로운 접근법을 필요로 했다.
Figure 1 — 트리 구조에서의 타겟 생성 및 분포 매칭 개념도
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 논문은 백업된 turn-level 신용을 behavior-relative Bernoulli 교사 분포로 매핑하고, Forward-KL 기반의 분포 매칭을 통해 학생 정책을 업데이트하는 TreeOPSD를 제안한다. 이 기법은 affine map을 통해 트리 구조에서의 credit 백업과 타겟 분포 생성이 commute하게 설계되어, 중복 계산 없이 각 노드의 신용을 효율적으로 산출한다. 학습 과정에서 [Figure 3]과 같이 오버슈트(overshoot) 발생 시 잔차(residual)가 역전되는 자기 보정(self-correction) 메커니즘을 통해 최적화 안정성을 확보했다. [Table 1]의 실험 결과에 따르면, Qwen3-30B-A3B-Thinking-2507 모델 기준 Deep Research 벤치마크에서 기존의 GRPO 대비 평균 정확도를 4.97점 향상시키는 등 탁월한 성능을 보였다. 또한, Multi-Hop QA 환경에서도 일관된 성능 우위를 확인했으며, [Figure 4]와 [Figure 5]는 정량적으로 TreeOPSD가 기존의 listwise 방식이나 고정된 가중치를 사용하는 기법들보다 긴 호흡의 작업에서 더 강력한 최종 정책을 도출함을 보여준다.
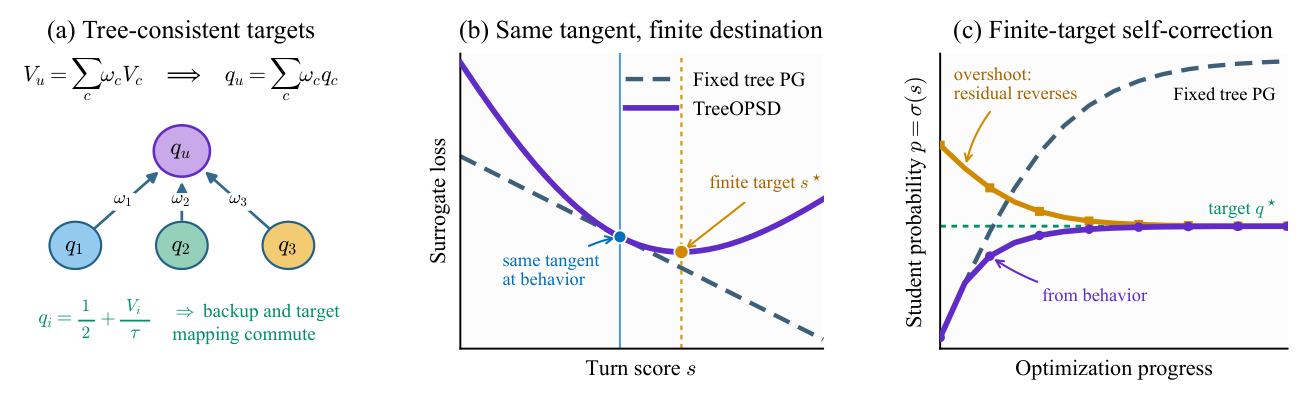
Figure 3 — TreeOPSD의 자기 보정 메커니즘을 보여주는 시각화
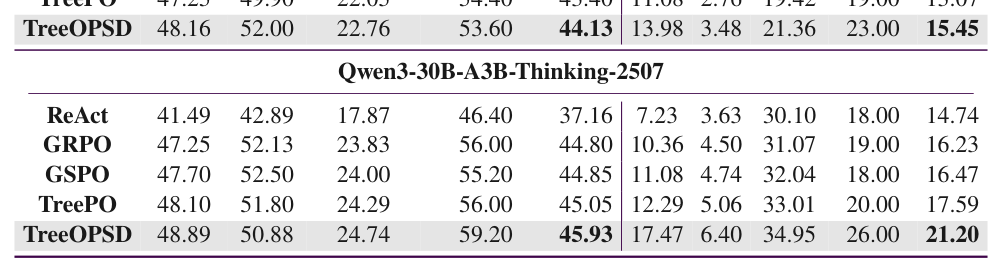
Table 1 — 주요 모델 및 벤치마크 대상 정량적 성능 비교표
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 critic 없는 posterior self-distillation을 통해 긴 호흡의 에이전트 RL에서의 신용 할당과 policy drift 문제를 근본적으로 개선했다. 제안된 Affine 교사 모델은 tree backup과 수학적으로 결합되어 정확한 policy gradient 방향을 보존하면서도, 학습 후반부의 과도한 정책 변경을 억제하는 유연한 타겟을 제공한다. 이 연구는 복잡한 추론 및 환경 상호작용이 필요한 LLM 에이전트의 효율적인 post-training 프레임워크로서, 공정하고 확장 가능한 강화학습 파이프라인의 중요한 이정표를 제시한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] AT^2PO: Agentic Turn-based Policy Optimization via Tree Search
- [논문리뷰] TreeGRPO: Tree-Advantage GRPO for Online RL Post-Training of Diffusion Models
- [논문리뷰] FC-SWE: Failure-Conditioned RL for Long-Horizon Software Engineering Agents
- [논문리뷰] SCOPE: Semantic Bounded Credit Optimization for Prompt Engineering in Text-to-image Generation
- [논문리뷰] TPPO: Tracking-Value PPO For Language Model Reasoning
Review 의 다른글
- 이전글 [논문리뷰] Towards Looped Models Done Right, Part I: Topology, Input Injection, Recurrent-State Design
- 현재글 : [논문리뷰] Tree-Aware Posterior Distillation for Long-Horizon Agentic Reinforcement Learning
- 다음글 [논문리뷰] Xiaomi-Lens-0 Technical Report
댓글