[논문리뷰] Xiaomi-Lens-0 Technical Report
링크: 논문 PDF로 바로 열기
저자: Pei Fu, Yike Liu, Yue Sun, Hanmo Wang, Xiuwen Xi, Ruoceng Zhang, Shaojie Zhang, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Multimodal Large Language Models (MLLMs): 이미지와 텍스트를 모두 이해하고 생성할 수 있는 대규모 언어 모델을 지칭합니다.
- Visual Grounding: 자연어 표현을 이미지 내 특정 Region에 연결하는 foundational capability입니다.
- Referring Expression Comprehension (REC): 모델이 참조된 Target을 Bounding Box 형태로 출력하도록 요구하는 Visual Grounding task입니다.
- Referring Expression Segmentation (RES): 모델이 참조된 Target을 Pixel-level Mask 형태로 출력하도록 요구하는 Visual Grounding task입니다.
- Visual Latents: Language Model이 생성하는
<|mask|>Token의 Contextual State로, Instruction에서 요청되거나 이전 Response에서 참조된 Region을 나타냅니다. - Chain-of-Thought (CoT): 모델의 추론 과정을 Intermediate Step으로 분해하여 설명하는 방식으로, 본 논문에서는 Region-specific Visual Latents와 Interleave됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 MLLMs가 Fine-grained Region Understanding에서 겪는 한계점을 해결하고자 한다. 현재 MLLMs는 이미지 전체에 대한 질문에는 잘 답변하지만, Nearby Object를 오인식하거나 Small Region의 Attribute를 잘못 식별하는 등 특정 Region에 대한 세밀한 이해에 어려움을 겪는다. 이러한 문제의 주된 원인은 Text-only Supervision이 Answer를 뒷받침하는 이미지 Region을 명시적으로 지정하지 않기 때문이다. 기존의 Mask Supervision을 활용하는 MLLMs (예: LISA, Sa2VA, Qwen3-VL-Seg)는 대부분 Mask Prediction을 위해 추가적인 Segmentation Encoder를 사용하거나, Vision Encoder를 Frozen 상태로 유지하여 Mask Loss가 Shared Visual Features에 도달하지 못하게 한다. 이는 Mask Supervision이 Fine-grained Perception 및 Visual Reasoning 능력 향상에 미치는 영향을 충분히 탐색하지 못하게 한다. 따라서 저자들은 MLLM이 자체 Visual Representation에서 Mask를 직접 예측하도록 함으로써 Dense Mask Supervision이 Fine-grained Perception 및 Visual Reasoning을 개선할 수 있는지 연구한다 [Figure 2].
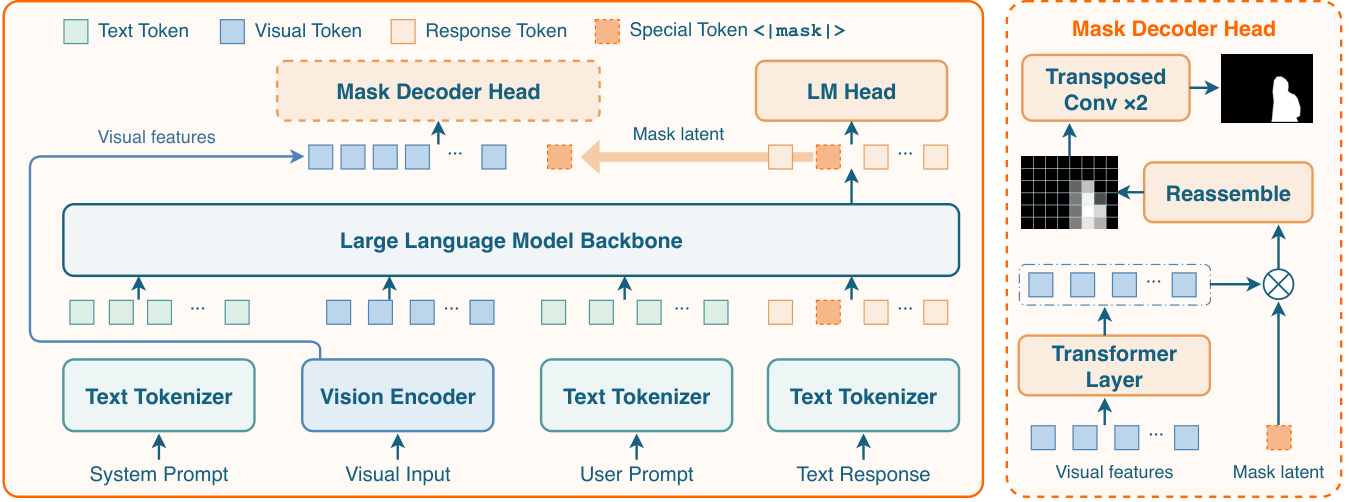
Figure 2 — 제안 모델 아키텍처
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 자체 Visual Representation에서 Mask를 직접 예측하는 4B MLLM인 Xiaomi-Lens-0를 제안한다. 이 모델은 Qwen3.5를 기반으로 하며, Vision Encoder의 Patch Features와 Language Model의 <|mask|> Token States인 Visual Latents를 결합하여 Mask를 예측한다. 특히, Lightweight Decoder는 Spatial Merger 이전에 추출된 Patch-level Grid Features를 사용하며, 추가적인 계층적 Vision Encoder나 Multi-scale Feature Fusion 없이 동작한다. Joint Language and Mask Supervision은 Shared Visual Features와 Language Model States를 모두 업데이트하여, Perception 및 Language Generation에 사용되는 Representation에 Region Extent에 대한 명시적인 Supervision을 제공한다. 또한, "Thinking with Visual Latents" 개념을 도입하여 Textual Reasoning과 Region-specific Visual Latents를 Interleave하며, Grounded Reasoning Traces를 통해 Intermediate Region References에 Pixel-level Supervision을 확장한다 [Figure 6]. 모델은 2단계 Training Recipe를 따르는데, Stage 1에서는 Backbone을 Freeze하고 Mask Decoder를 Pretrain하며, Stage 2에서는 Full Model을 Unfreeze하여 Jointly Fine-tune한다.
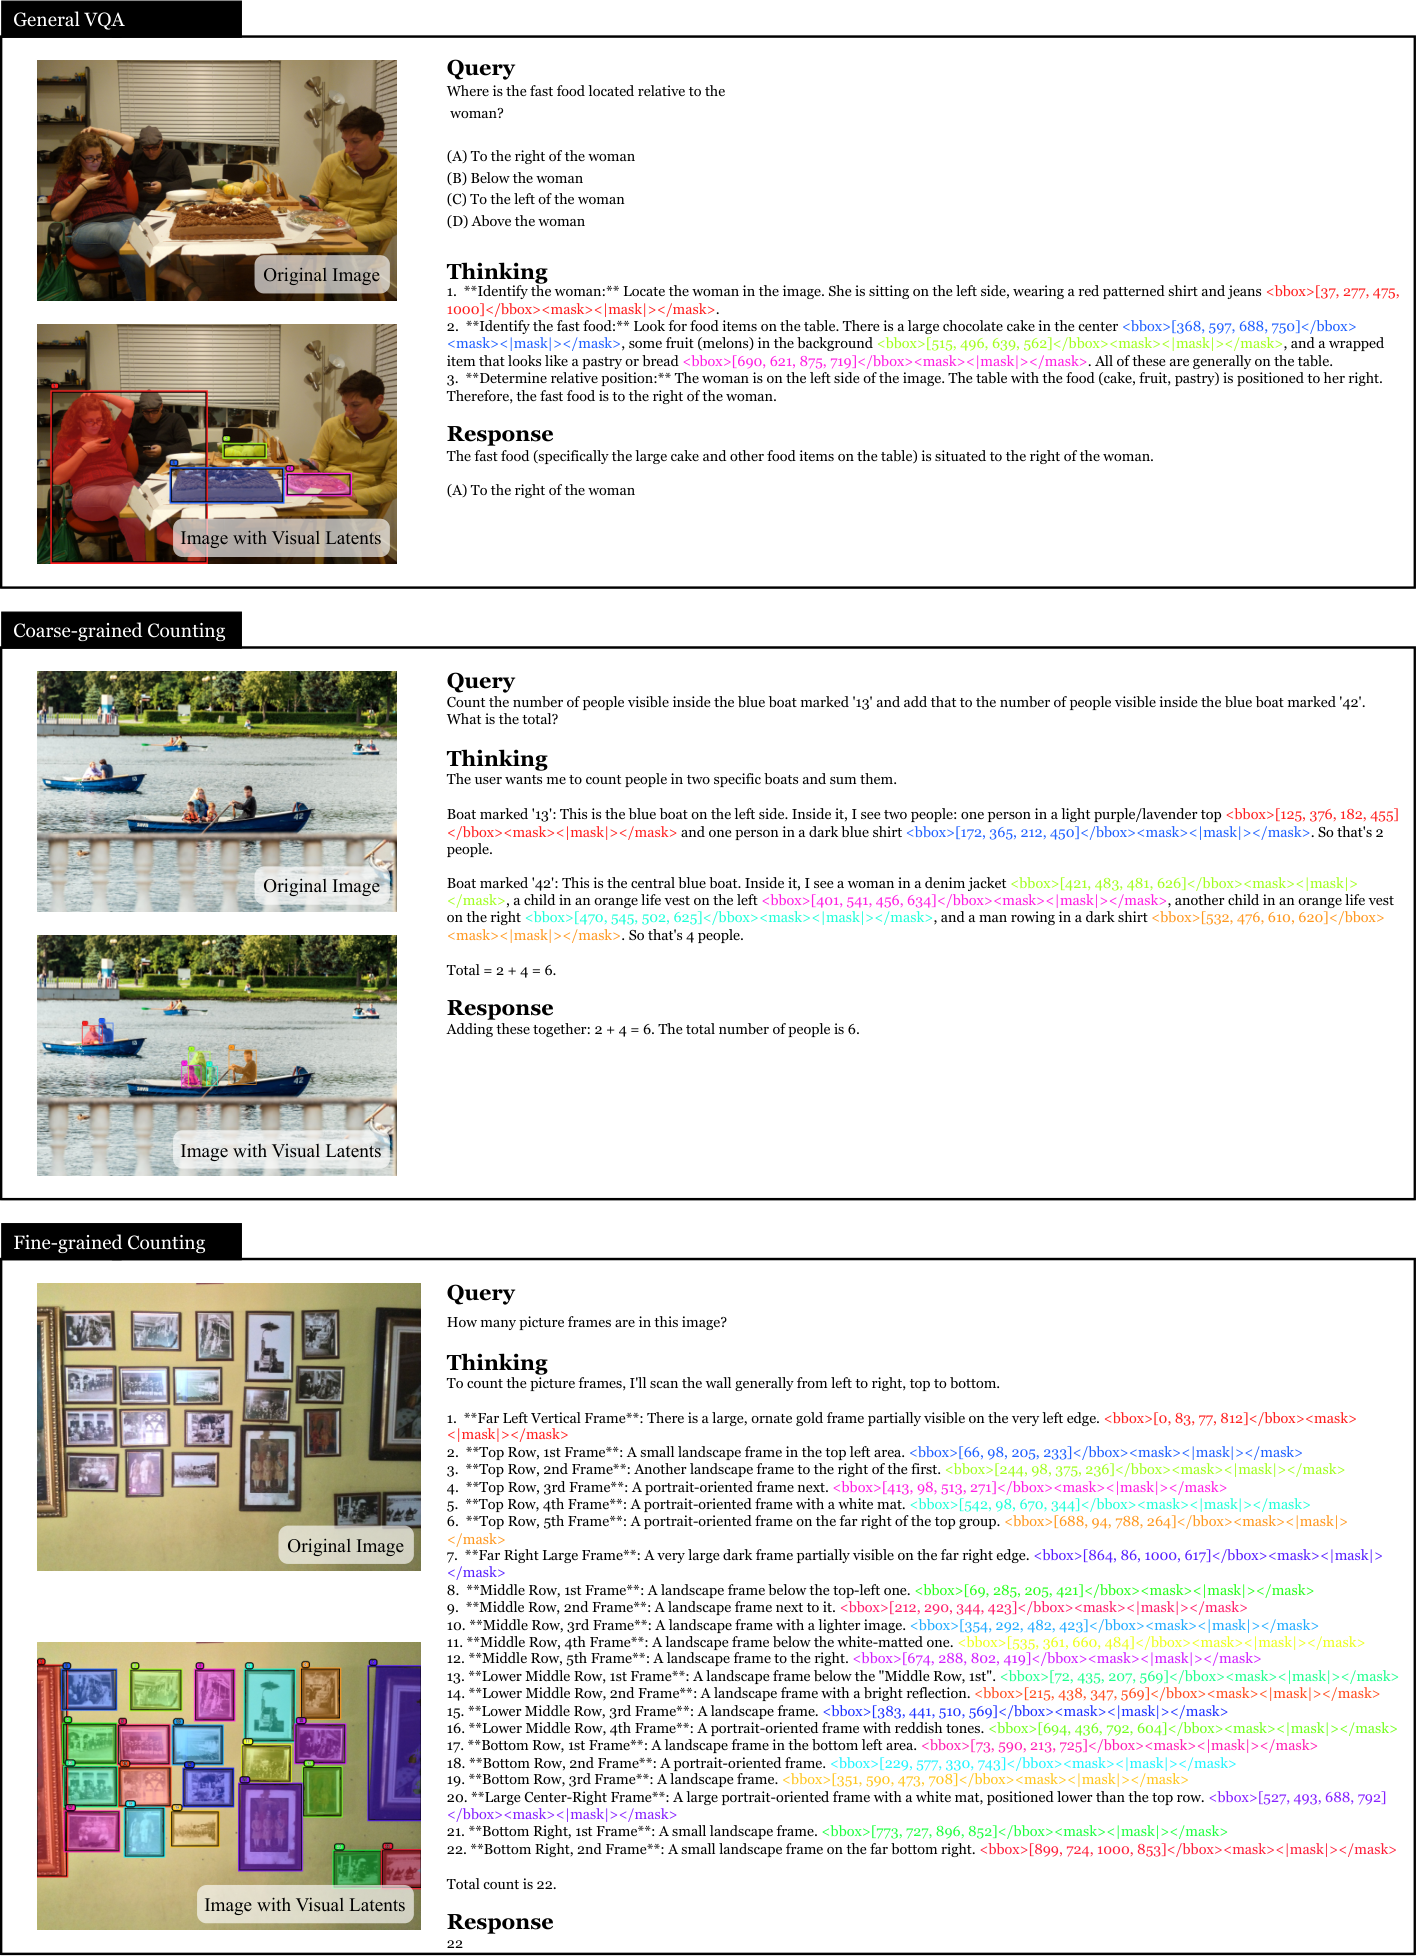
Figure 6 — Visual Latents 활용 추론 예시
Xiaomi-Lens-0는 다양한 Task에서 우수한 성능을 보인다:
- Referring Expression Comprehension (REC): RefCOCO, RefCOCO+, RefCOCOg의 8개 Split 전체에서 Qwen3.5 Backbone 대비 평균 5.6 Points 향상되었으며, 7개 Split에서 1위를, RefCOCOg Test Split에서 2위를 차지했다. 특히 RefCOCO+에서 가장 큰 평균 7.6 Points의 Gain을 보였다.
- Referring Expression Segmentation (RES): 모든 8개 RES Split에서 비교 모델 중 가장 높은 cIoU를 달성했으며, 평균 81.4의 성능으로 Qwen3-VL-Seg4B 대비 2.8 Points 이상 높은 성능을 기록했다. Dedicated Segmentation Model인 SAM 3보다도 7.0에서 12.9 Points 높은 cIoU를 보였다.
- Multi-Instance Grounding: COCO 2017에서 F1@mIoU 63.9를 달성하여 비교 모델 중 최고 성능을 기록했다.
- Fine-grained Perception: MME-RW-en, MME-RW-cn, CV-B, V*, HR-4K, HR-8K, CountQA, ColorB 등 모든 8개 Perception Benchmark에서 Qwen3.5 Backbone을 능가했다. 특히 CountQA Accuracy는 43.8%에서 50.6%로 6.8 Points 상승했고, ColorB는 1.7 Points 개선되어 84.4%를 기록했다.
- Ablation Study: Mask Supervision이 Box Supervision만 적용된 모델 대비 REC에서 1.1에서 2.4 Points, Perception에서 0.2에서 1.4 Points 추가적인 성능 향상을 가져왔다. Grounded Reasoning Traces는 Final Masks의 Sharpness를 향상시켜 RES 성능을 0.5에서 0.8 Points 높였다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Shared Vision Encoder의 Patch-level Grid Features와 Language Model이 생성하는 Mask Token의 Contextual State인 Visual Latents로부터 Region Mask를 직접 Decode하는 Xiaomi-Lens-0를 성공적으로 개발했다. 이 접근 방식은 Mask Loss가 Language Generation에 사용되는 Representation에 도달하게 하며, "Thinking with Visual Latents"를 통해 Grounded Chain-of-Thought의 Intermediate Region에도 Pixel-level Supervision을 확장한다.
이 연구는 Spatial Encoder 없이도 MLLM이 Referring Expression Segmentation (RES), Referring Expression Comprehension (REC), Multi-Instance Grounding 등 다양한 Spatial Prediction Task에서 SOTA 성능을 달성할 수 있음을 입증했다. 나아가, Mask Supervision이 Box Localization뿐만 아니라 Text Answer로 측정되는 Fine-grained Perception 및 Visual Reasoning 능력까지 향상시킨다는 점을 정량적으로 보여주었다. 새롭게 제시된 LensBench Benchmark는 Instruction Semantics와 Visual Domain 변화에 따른 Region Prediction 성능을 평가하는 데 기여하며, 특히 Panoramic Scene에서의 Implicit Multi-target Selection이 여전히 도전적인 영역임을 밝혀냈다. 이러한 결과는 MLLM의 Fine-grained Visual Understanding을 심화하고, 다양한 Real-world Application에서의 잠재력을 확장하는 데 중요한 시사점을 제공한다.
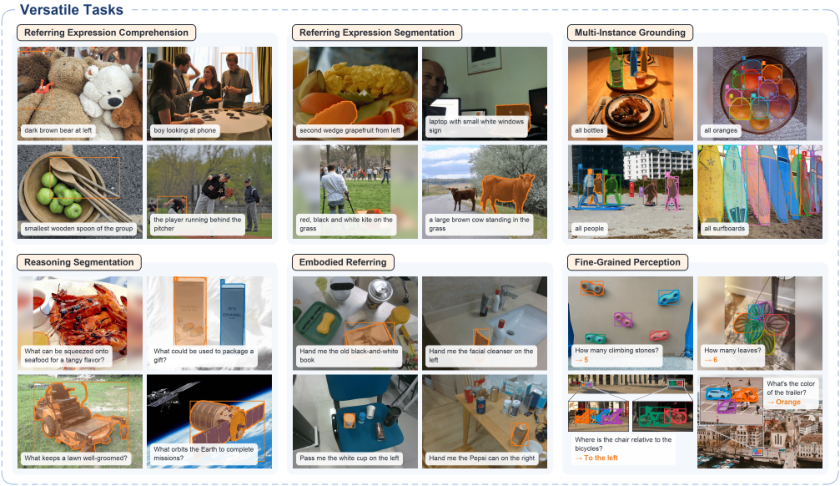
Figure 1 — 모델 적용 태스크 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Video-CoE: Reinforcing Video Event Prediction via Chain of Events
- [논문리뷰] ExpVid: A Benchmark for Experiment Video Understanding & Reasoning
- [논문리뷰] MARS2 2025 Challenge on Multimodal Reasoning: Datasets, Methods, Results, Discussion, and Outlook
- [논문리뷰] Visual Grounding Safety in Vision-Language Models
- [논문리뷰] GroundingPI: A Grounding Foundation Model towards Physical Intelligence with Visual Primitives
Review 의 다른글
- 이전글 [논문리뷰] Tree-Aware Posterior Distillation for Long-Horizon Agentic Reinforcement Learning
- 현재글 : [논문리뷰] Xiaomi-Lens-0 Technical Report
- 다음글 없음
댓글