[논문리뷰] Factorization-Guided Training and Inference for Diffusion-Drafted Speculative Decoding
링크: 논문 PDF로 바로 열기
저자: Jiakun Fan, Min Xiao, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Speculative Decoding: Lightweight Drafter를 사용하여 여러 토큰을 제안하고, 이를 Target Model의 단일 Forward Pass에서 병렬로 Verification하여 Large Language Model (LLM) Inference를 가속화하는 기법입니다.
- Diffusion Drafter: Speculative Decoding에서 Draft Proposal 생성을 병렬화하기 위해 Diffusion Model을 활용하여 여러 Draft 토큰을 동시에 예측하는 Drafter입니다.
- Mean Accepted Tokens (MAT): 각 Speculative Decoding Round에서 Target Model에 의해 유효하다고 Verification되어 수락된 토큰들의 평균 개수입니다. 이는 Inference 효율의 주요 지표 중 하나입니다.
- Position-wise Loss Factorization: DScout의 Training Strategy로, 각 토큰 위치의 Loss 기여도를 Inclusion (포함 여부), Weighting (가중치), Prediction Loss로 분해하여 Supervision 할당을 분석하고 최적화하는 방법론입니다.
- Acceptance-Weighted Loss (AWL): Drafter의 예측이 Target Model에 의해 수락될 가능성에 따라 각 토큰 위치의 Loss에 동적으로 가중치를 부여하는 Training Loss 구성 요소입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
Speculative Decoding은 LLM Inference 가속화를 위한 효과적인 방법론으로 각광받고 있지만, 단순히 더 많은 Draft Proposal을 생성하거나 더 높은 Mean Accepted Tokens (MAT)를 달성하는 것만으로는 항상 최적의 Throughput으로 이어지지 않는다는 문제가 있습니다. 기존 Diffusion Drafter인 DFlash는 여러 토큰을 동시에 예측하여 Proposal 생성을 병렬화하지만, Verification이 연속된 Prefix만 수락하기 때문에 Early Rejection이 발생하면 이후의 정확한 예측이 무효화되어 MAT Gain이 제한됩니다. 더욱이, MAT가 높아지더라도 Per-Round Latency 증가를 충분히 상쇄하지 못하면 전체 Throughput은 오히려 감소할 수 있습니다. 이러한 한계점은 Training 과정에서 Prefix Dependence를 고려하고, Inference 시에는 MAT와 Latency 간의 복합적인 Trade-off를 고려하여 최적의 Configuration을 탐색할 필요성을 제기합니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Diffusion Drafter의 Training 및 Inference Optimization을 위해 두 가지 상호보완적인 Factorization을 활용하는 DScout을 제안합니다 [Figure 1]. 첫째, DScout은 Training 과정에서 Position-wise Loss를 Inclusion, Weighting, Prediction Loss로 Factorize하여 Prefix Acceptance와 Supervision 할당을 정렬하고 MAT를 개선합니다. 이를 위한 Training Recipe는 Mixed-Horizon Training, Intra-Block Unmasking, 그리고 Acceptance-Weighted Loss (AWL)를 통합합니다. 특히, AWL은 Drafter의 예측에 대한 Prefix-Dependent Acceptance Score에 기반하여 각 위치의 Loss에 가중치를 동적으로 부여함으로써 Training이 Verification Rule과 더욱 밀접하게 연동되도록 합니다. Mixed-Horizon Training은 다양한 길이의 Prediction Horizon을 사용하여 Early Position에 대한 Supervision을 강화하면서 Long-Horizon Coverage를 유지합니다 [Figure 2]. 둘째, DScout은 Inference 시 Throughput을 MAT와 Per-Round Latency의 비율로 Factorize하여 최적의 Inference Configuration을 탐색하는 과정을 안내합니다. 이를 통해 Target-Conditioning Depth, Drafter Depth, Inference Block Size의 최적 조합을 효율적으로 선택합니다. 예를 들어, Target-Conditioning Depth는 Target Model의 Hidden Feature를 사용하므로 Incremental Overhead가 미미하여 Full Conditioning을 채택합니다 [Figure 3(a)]. Drafter Depth는 MAT Gain과 Latency 간의 Unimodal Trade-off를 활용하여 효율적인 탐색을 가능하게 합니다 [Figure 3(b), Figure 5]. Mixed-Horizon Training은 Retraining 없이 다양한 Inference Block Size에 대한 평가를 지원합니다 [Table 2]. 실험 결과, DScout은 Qwen3-4B 및 Qwen3-8B 모델에서 Autoregressive Decoding 대비 평균 3.84배 및 4.14배의 Mean Speedup을 달성했습니다 [Table 3]. 이는 기존 SOTA Baseline 대비 각각 평균 9.1% 및 7.1% 향상된 수치입니다. 특히, DScout의 Inference Configuration Policy는 Fixed Configuration 대비 최대 9.75%의 추가 Mean Speedup을 제공하여, Workload 및 Concurrency 변화에 맞춰 최적의 Block Size를 선택하는 것의 중요성을 정량화했습니다 [Table 4, Figure 6]. Training Ablation 연구에서는 Mixed-Horizon Training, Intra-Block Unmasking, AWL을 순차적으로 적용했을 때 MAT가 16.1% 증가했습니다 [Figure 4].
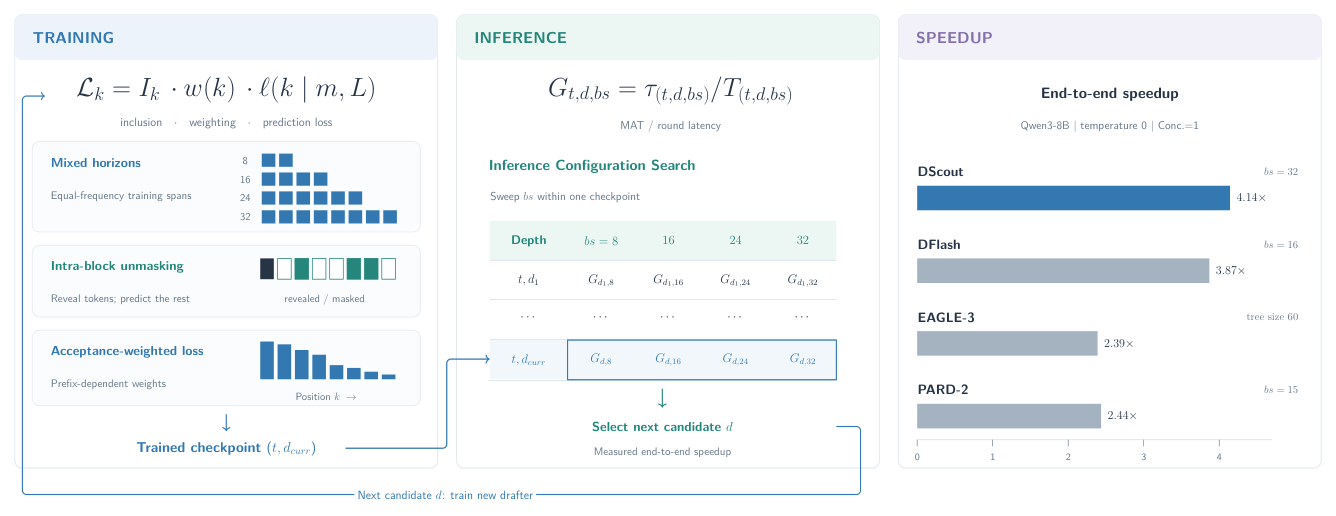
Figure 1 — 전체 Training 및 Inference 프레임워크와 Factorization 개념을 시각적으로 설명하는 핵심 다이어그램.
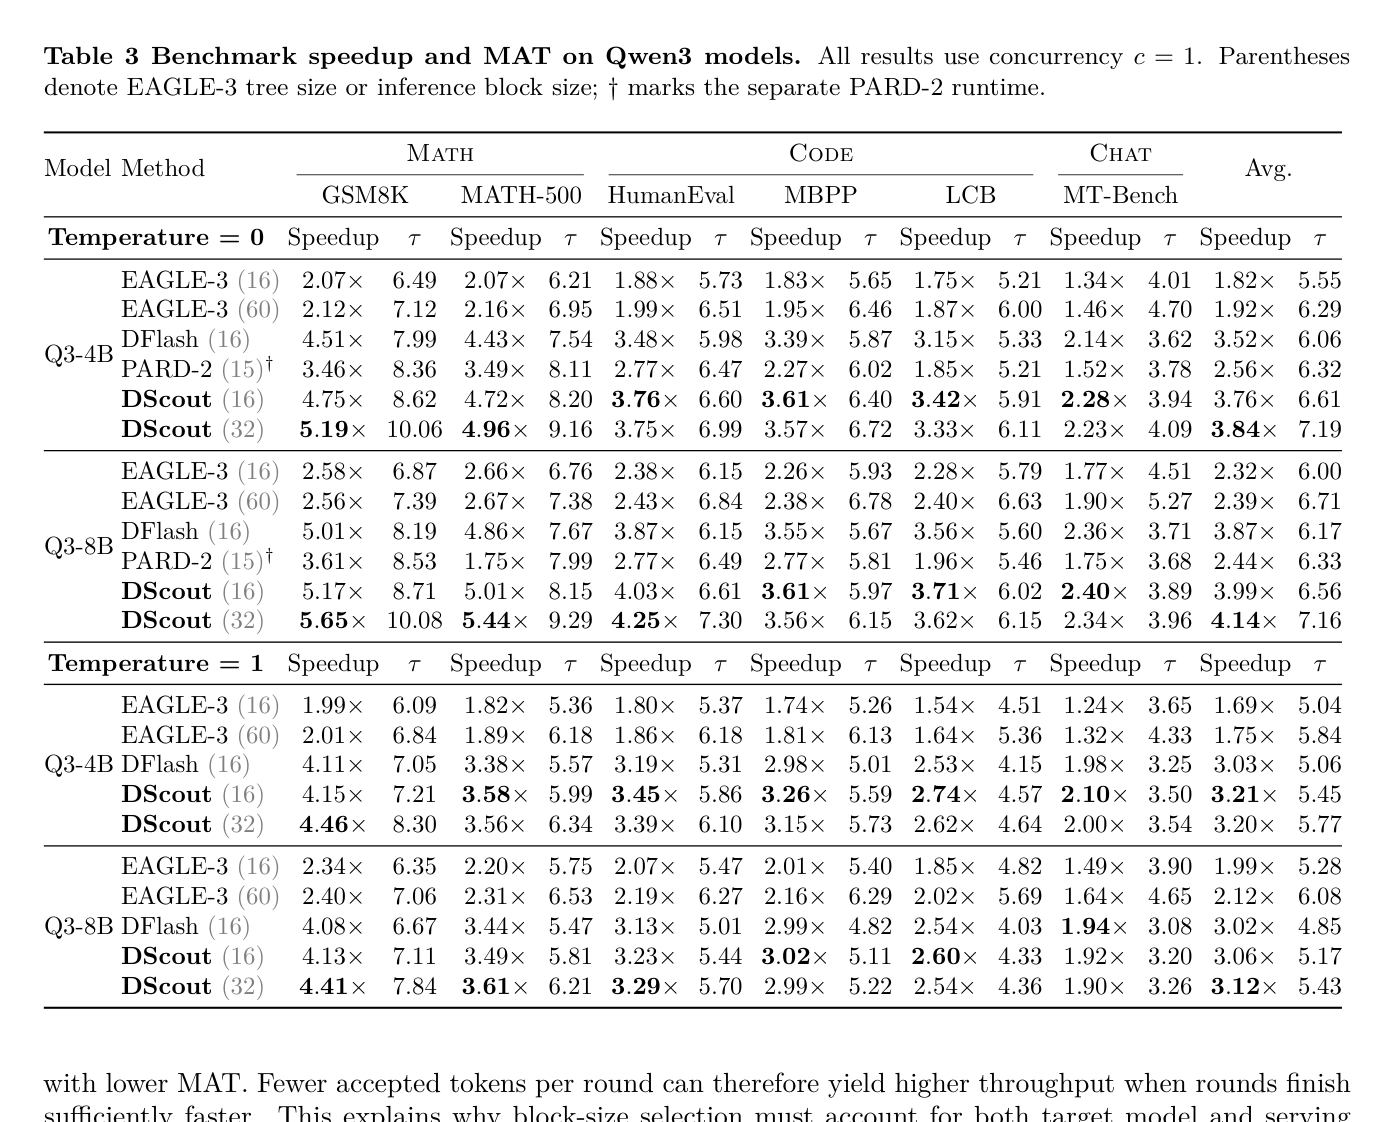
Table 3 — 다양한 Target Model 및 Benchmark에서 DScout의 Speedup과 MAT 성능을 정량적으로 비교하는 핵심 결과 테이블.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Diffusion Drafter 기반 Speculative Decoding의 Training 및 Inference Optimization을 위한 DScout이라는 Factorization-Guided 접근 방식을 성공적으로 제시합니다. DScout의 Position-wise Loss Factorization은 Prefix Acceptance와 Supervision 할당을 효과적으로 정렬하여 MAT를 개선하며, Throughput Factorization은 Inference Configuration Selection을 MAT-Latency Trade-off 관점에서 최적화하도록 가이드합니다. 이러한 Training Recipe와 Inference Configuration Policy는 다양한 모델, Task 및 Serving Load에 걸쳐 End-to-End 성능을 크게 향상시킵니다. 본 연구는 Diffusion Drafter의 Prediction Quality를 Practical Decoding Acceleration으로 전환하는 체계적인 Framework를 제공하며, 향후 Diffusion Drafter 연구에서 Training Strategy 설계 및 Inference Configuration Selection을 위한 중요한 기반을 마련했습니다. 특히, Retraining 없이 온라인으로 Block Size를 조절하는 Adaptive Inference Policy와 같은 미래 연구 방향에 대한 잠재력을 시사합니다.
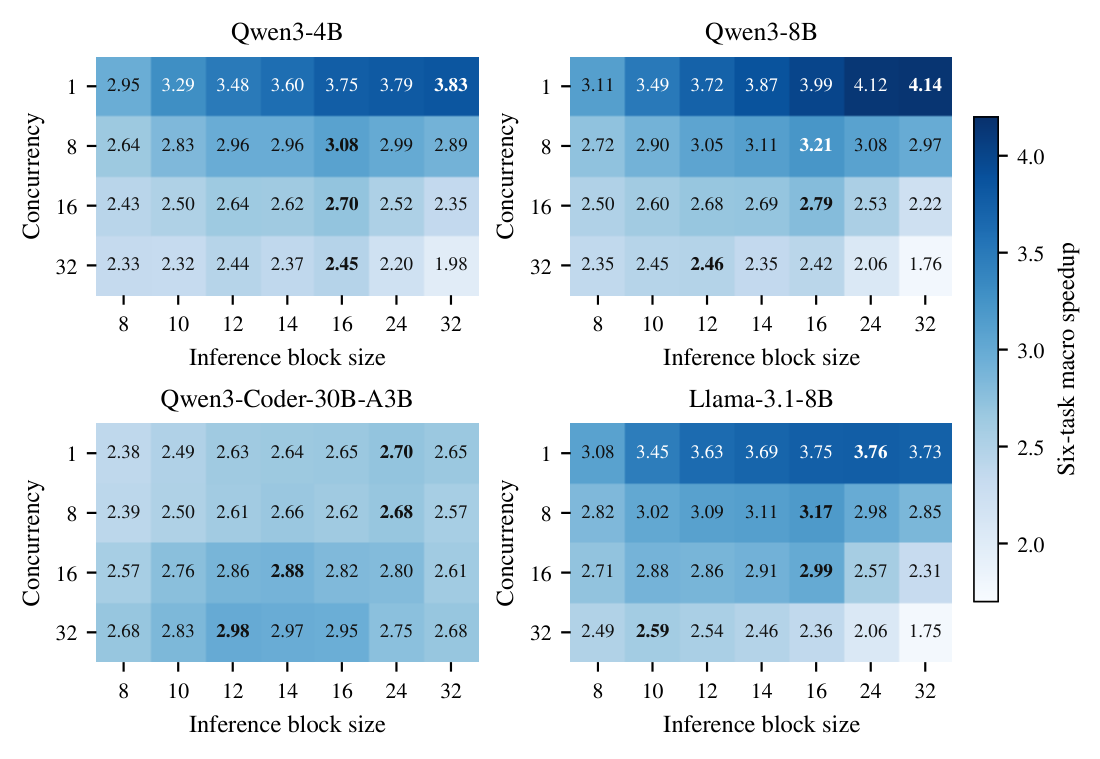
Figure 6 — 다양한 Concurrency 및 Inference Block Size 설정에서 DScout의 Mean Speedup 성능을 보여주는 상세 Grid Chart.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] DLite: History-free Speculative Decoding for Agentic AI
- [논문리뷰] OasisKV: Scaling In-Decode KV Cache Beyond HBM with Lookahead Sparse Prefetching
- [논문리뷰] JetSpec: Breaking the Scaling Ceiling of Speculative Decoding with Parallel Tree Drafting
- [논문리뷰] VIA-SD: Verification via Intra-Model Routing for Speculative Decoding
- [논문리뷰] Speculative Pipeline Decoding: Higher-Accruacy and Zero-Bubble Speculation via Pipeline Parallelism
Review 의 다른글
- 이전글 [논문리뷰] Evidence-First Agentic Verification
- 현재글 : [논문리뷰] Factorization-Guided Training and Inference for Diffusion-Drafted Speculative Decoding
- 다음글 [논문리뷰] FineSplat: Fine Patches, Local Groups, Detailed Splats
댓글