[논문리뷰] Deep Search in Real-World Web Environments
링크: 논문 PDF로 바로 열기
메타데이터
저자: Xiaomin Yu, Hongliang Chen, Zhe Huang, Shilin Yan, Shao-Rong Su, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- OpenDS (Open-Web Deep Search): 실제 웹 환경에서 다단계 검색, 정보 접근 및 추론을 통해 복잡한 질문에 대한 유일한 사실적 답변을 도출하는 다단계 연구 작업.
- OpenDS-World: 200개의 고난도 작업으로 구성된 벤치마크로, 다양한 정보 modality, 이질적인 파일 포맷, 복잡한 대화형 접근 요구사항을 포함함.
- Evidence Acquisition: 검색, 브라우저 상호작용, 데이터 처리 등을 통해 파편화된 정보원으로부터 필요한 근거를 수집하고 통합하는 프로세스.
- Interactive Access Requirements: 단순 검색을 넘어 페이지 내 탐색, 파라미터 입력, 시간 인덱싱, 인터페이스 조작 등 능동적 조작이 필요한 정보 획득 방식.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 실세계 웹 환경에서의 AI 에이전트가 수행하는 Deep Search 능력에 대한 체계적인 평가가 부족하다는 점을 해결하고자 한다. 기존의 정적인 정보 검색 환경과 달리, 실제 웹 정보는 다양한 형식과 방식으로 분산되어 있으며, 에이전트가 자율적으로 웹을 탐색하고 복잡한 상호작용을 거쳐 근거를 통합해야 하는 도전에 직면해 있다 [Figure 2]. 따라서 저자들은 에이전트의 실제적인 검색 및 추론 능력을 측정하기 위한 OpenDS 과업과 이를 기반으로 한 벤치마크인 OpenDS-World를 제안한다 [Figure 3].
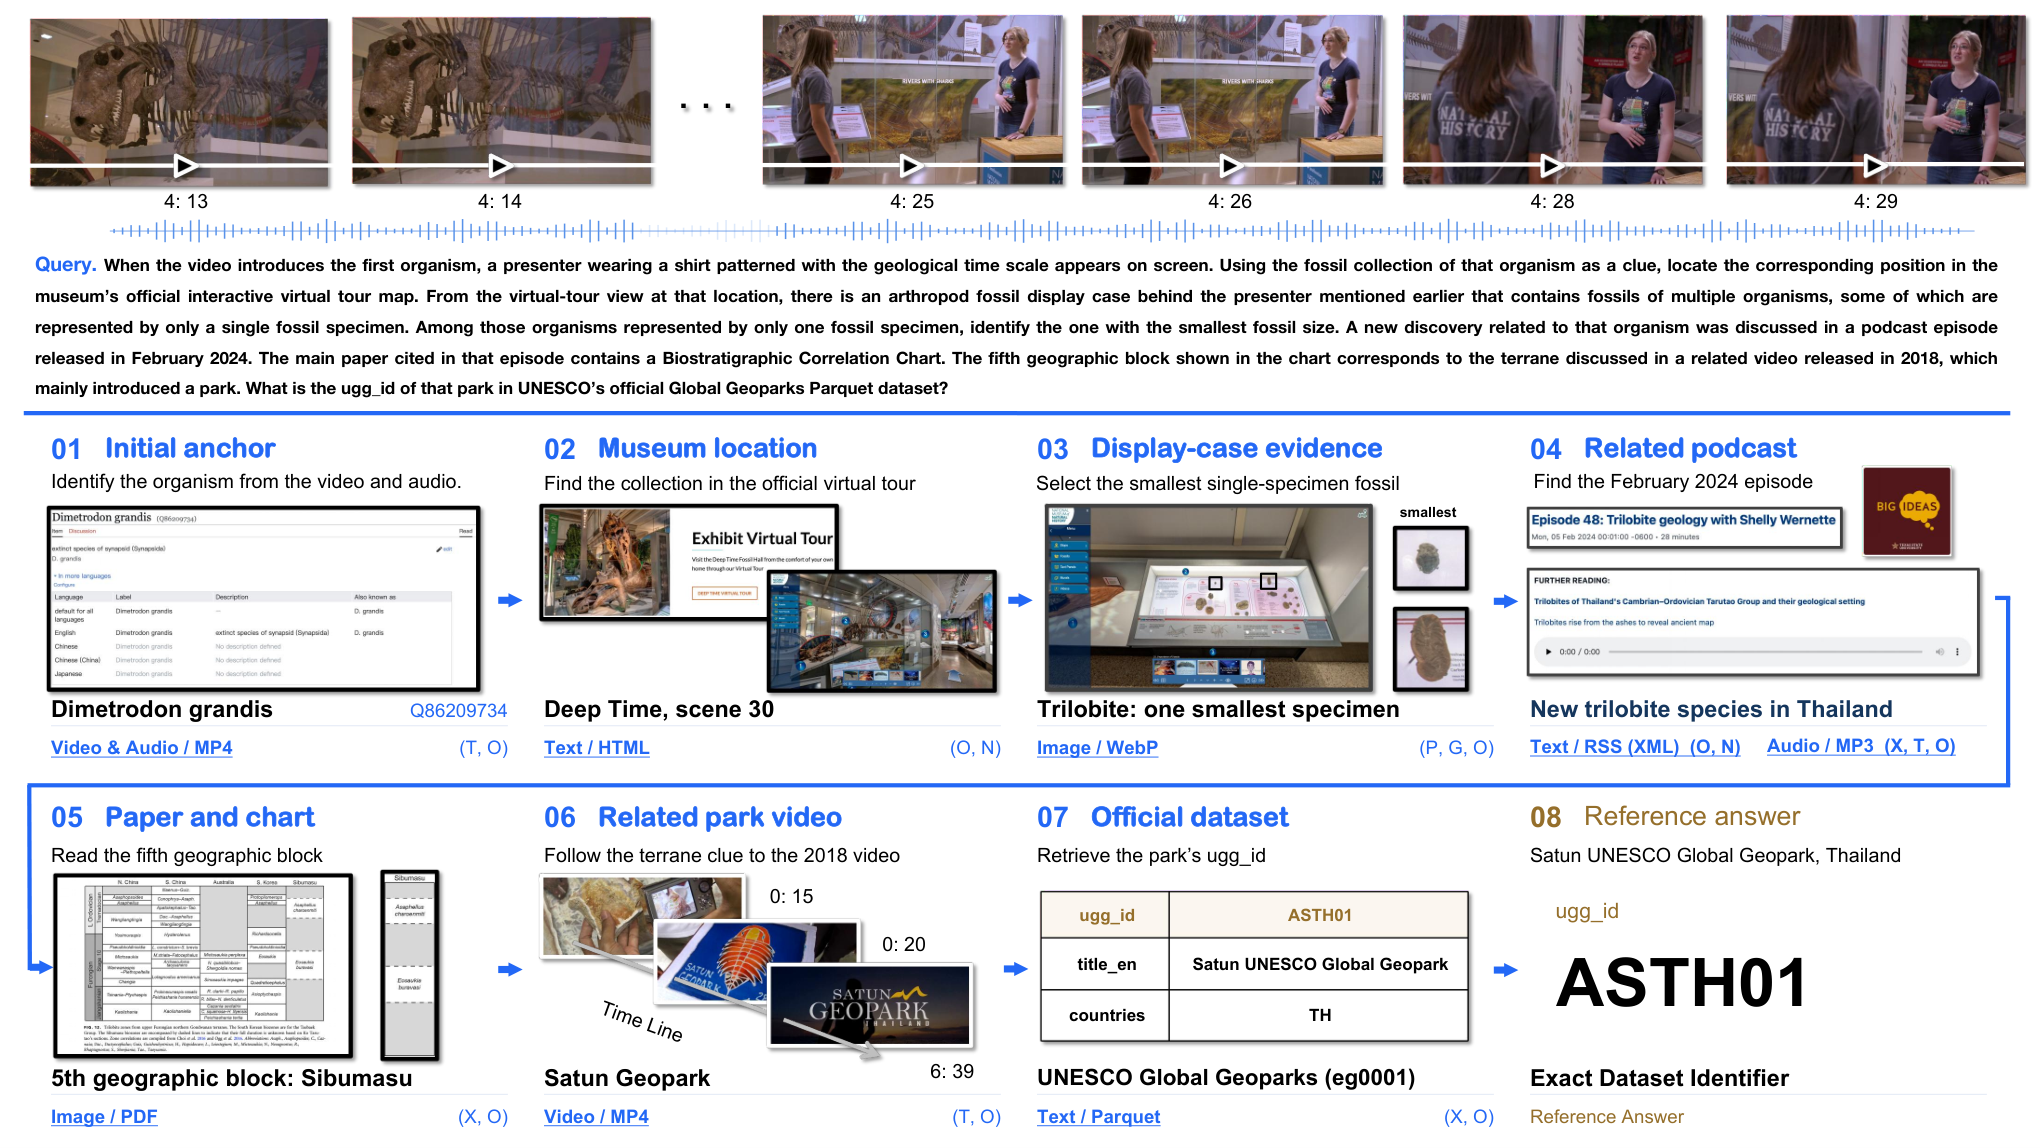
Figure 2 — OpenDS-World 검색 예시
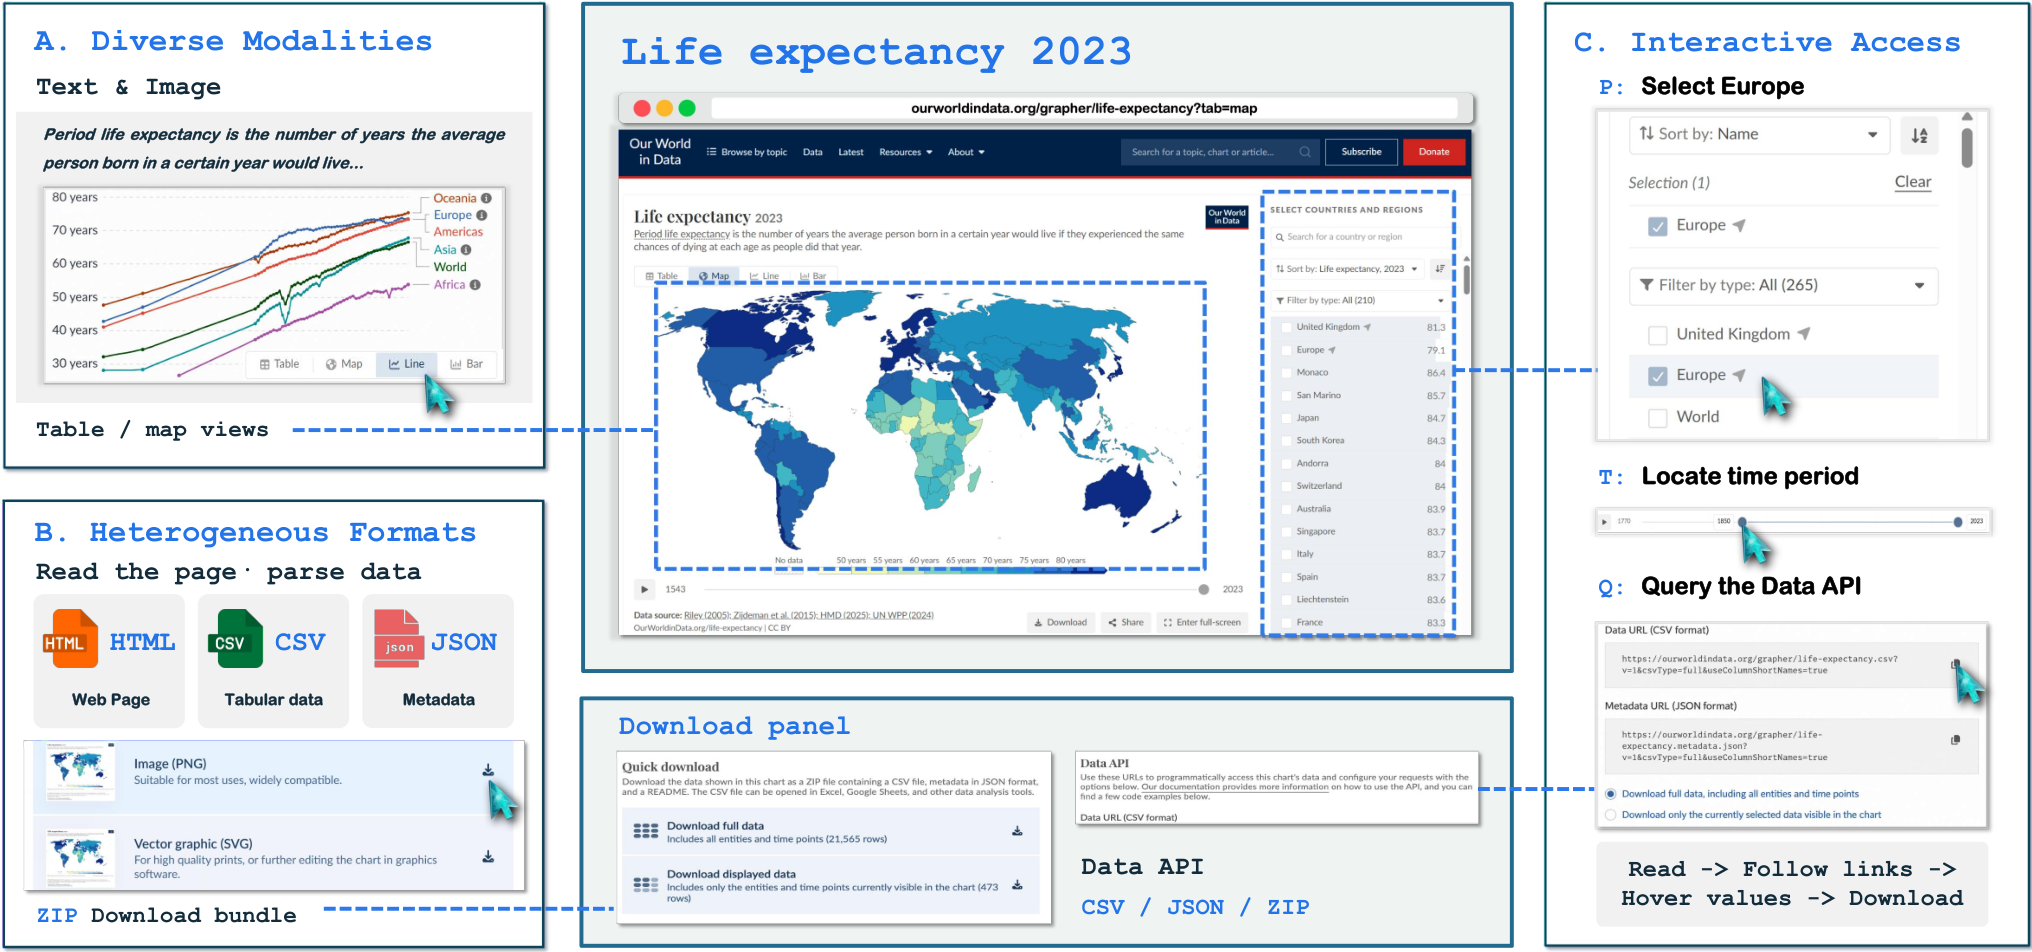
Figure 3 — 실세계 웹 소스의 3대 속성
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 8개 도메인에 걸쳐 200개의 복잡한 질문으로 구성된 OpenDS-World 벤치마크를 구축하였으며, 각 작업은 비디오 기반의 초기 앵커로부터 시작되어 다단계 웹 조사를 거쳐 정답을 도출하도록 설계되었다 [Figure 2]. 에이전트는 검색 도구, GUI 도구, 외부 정보 처리 도구를 사용하여 웹 브라우징과 정보 추출을 수행하며, 12개의 frontier 모델을 대상으로 성능을 비교 평가하였다 [Table 1]. 실험 결과, 최고 성능을 기록한 GPT-6 Astra 모델의 정확도(Accuracy)는 39.0%에 그쳐 현재 모델들이 실세계 웹에서의 복잡한 검색 및 통합에 여전히 큰 어려움을 겪고 있음을 보여주었다. 이는 1,000건의 독립적인 시도에서 21.1%의 정확도를 보인 인간 수행 결과와 비교했을 때, 특정 고난도 태스크에서는 여전히 인간 수준의 전략적 유연성이 부족함을 시사한다 [Figure 1]. 또한, 모델들은 도구 사용 및 장기 기억 관리 측면에서 서로 다른 전략적 한계를 드러냈다.
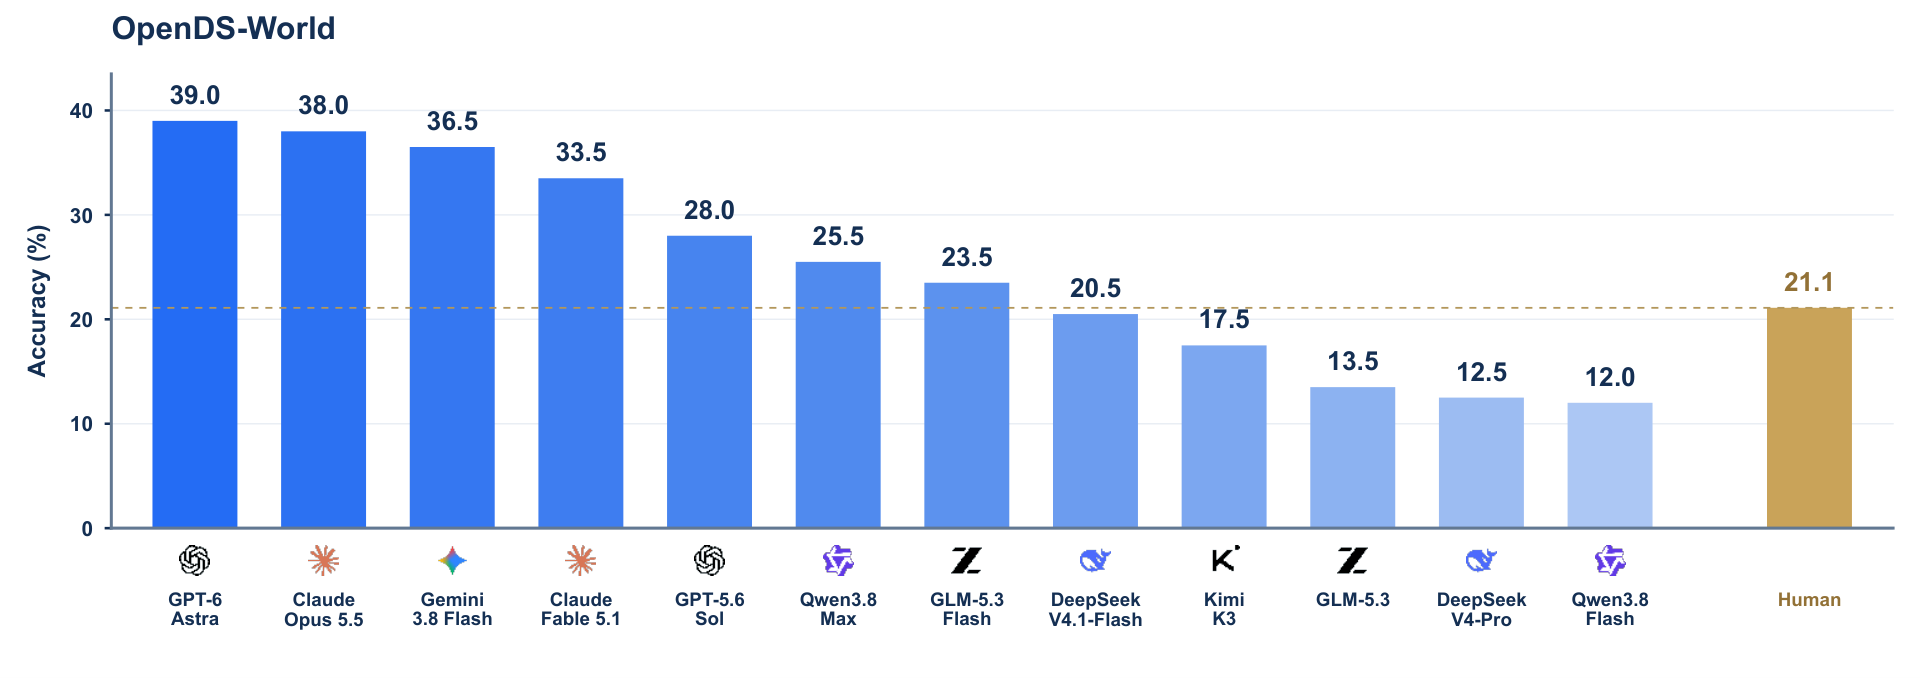
Figure 1 — 모델과 인간의 성능 비교
4. Conclusion & Impact (결론 및 시사점)
본 논문은 실세계 웹 환경에서의 자율적 Deep Search 역량을 측정하는 포괄적인 벤치마크인 OpenDS-World를 성공적으로 도입하였다. 제안된 프레임워크는 단순히 지식을 검색하는 수준을 넘어, 다양한 데이터 형식과 대화형 접근 제약을 처리해야 하는 복잡한 연구 환경을 제공한다. 이 연구는 향후 에이전트가 실제적인 연구 도우미로서 진화하는 데 필요한 검색 전략, 도구 조정, 실패 복구 메커니즘 개발을 위한 필수적인 평가 플랫폼을 제공한다. 학계와 산업계는 본 연구를 통해 에이전트의 정보 수집 및 통합 전략을 보다 정교하게 발전시킬 수 있는 시사점을 얻을 수 있다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] When Search Agents Should Ask: DiscoBench for Clarification-Aware Deep Search
- [논문리뷰] OneSearch-VL: Unified Multimodal Deep Research Agent for Image and Video
- [논문리뷰] MULTI3IR: A Benchmark for Multi-perspective Multi-domain Multi-modal Information Retrieval
- [논문리뷰] SPIEval: Evaluating Large Language Models as Mobile Assistants over Scattered Personal Information
- [논문리뷰] Two-Level Meta-Rubrics for Evaluating Open-Ended Generation: GAMUT, a Benchmark for Factual Completeness
Review 의 다른글
- 이전글 [논문리뷰] Deep Fusion Memory: A Chunk-Level Parametric Memory for Large Language Models
- 현재글 : [논문리뷰] Deep Search in Real-World Web Environments
- 다음글 [논문리뷰] Editing Images into Reusable Layers via Compositional Edit-Prior Distillation
댓글