[논문리뷰] Echo: Coupled Action and Task Status Signal Denoising for Vision Language Action Models
링크: 논문 PDF로 바로 열기
저자: Yufeng Liu, Bohao Fan, Juntu Zhao, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- VLA (Vision Language Action) models: 로봇이 시각적 관찰(visual observations) 및 언어 지시(language instructions)를 로봇 동작(robot actions)으로 매핑하여 조작(manipulation) 작업을 수행하도록 하는 모델입니다.
- Task Status Signal: 로봇 작업 실행이
ongoing,successful completion, 또는failure상태인지 여부를 나타내는 신호입니다. - Stop Signal (SS): 로봇의 실행이 특정 지점에서 종료되어야 하는지 여부를 나타내는 Task Status Signal의 한 종류입니다.
- Failure Signal (FS): 로봇의 실행이 실패 상태에 있는지 여부를 나타내며,
recoverable failure와terminal failure를 구분하는 데 사용되는 Task Status Signal의 한 종류입니다. - Asynchronous Denoising: Echo 프레임워크에서 signal tokens을 action tokens보다 더 빠르게 denoising하여, action denoising의 후속 단계에서 더
clean한 status estimates를 조건으로 활용할 수 있도록 하는 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 로봇이 작업 완료 및 실패를 인식하여 실행 결정을 지원하는 데 필요한 Task Status Signal 예측의 한계를 해결하고자 합니다. 기존 Vision Language Action (VLA) 정책을 Task Status Signal 예측으로 확장하는 방법들은 종종 fine-grained frame-level supervision, 외부 모니터링 모델, 또는 복잡한 아키텍처 설계를 요구합니다. 이러한 접근 방식들은 예측된 신호를 주로 모니터링 용도로 사용하며, Task Status Signal이 action generation을 직접적으로 가이드하는 잠재력은 충분히 탐구되지 않았습니다. 즉, 기존 방법들은 신호 예측의 정확성을 보장하면서도 minimal additional training and inference overhead로 action generation을 직접 개선하는 데 어려움을 겪고 있습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 로봇 동작과 Task Status Signal을 single VLA 내에서 동시에 denoising하는 Echo 프레임워크를 제안합니다. Echo는 Stop Signal (SS)과 Failure Signal (FS)을 각 action chunk의 두 가지 추가 차원으로 표현하고, 이를 로봇 동작과 함께 denoising합니다. 이 신호들은 ongoing execution, successful completion, failure를 구별합니다 [Figure 1]. Echo는 frame-level progress annotations 없이 신호를 학습하기 위해 성공적인 시연(successful demonstrations), 실패한 정책 롤아웃(failed policy rollouts), 사전 개입 실패 세그먼트(pre-intervention failure segments) 및 복구 시연(recovery demonstrations)을 활용하는 complementary supervision scheme을 구축합니다 [Figure 2], [Table 1]. action generation을 신호로 가이드하기 위해, Echo는 신호와 동작 간의 상호작용을 제어하고, Asynchronous Denoising을 통해 신호를 동작보다 빠르게 denoising합니다. 이는 cleaner status estimates가 이후 action denoising 단계에 조건으로 작용하도록 하여 정확한 신호 예측을 유지하면서도 동작 생성을 개선합니다.
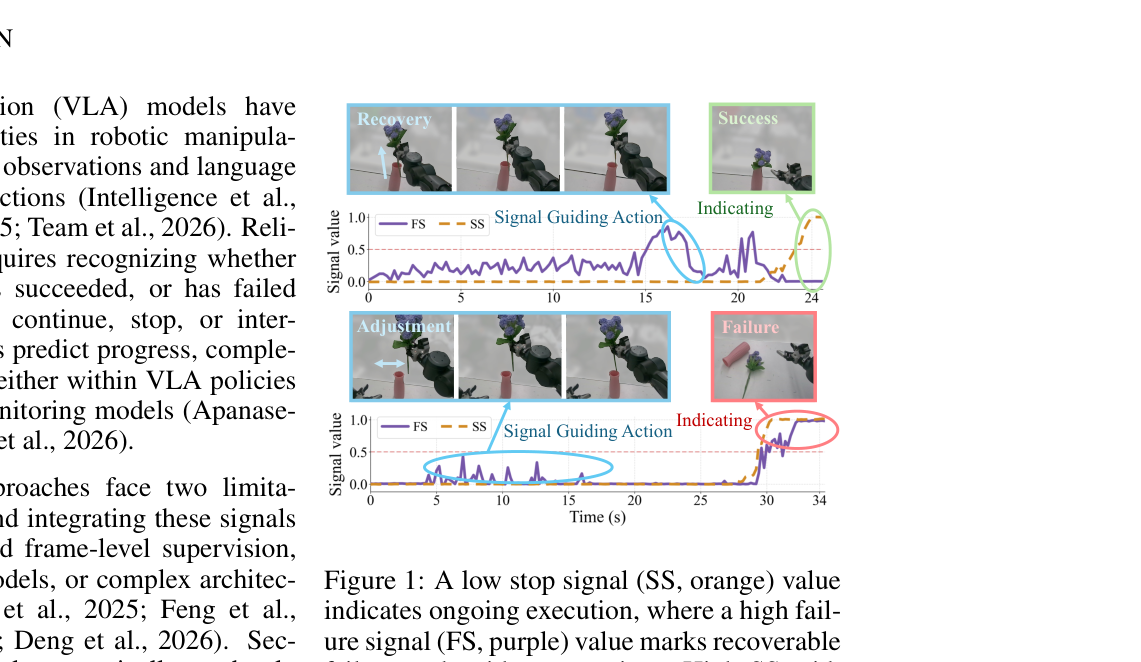
Figure 1 — 제안된 Stop Signal (SS) 및 Failure Signal (FS)의 시각적 표현과 해석을 보여주는 핵심 다이어그램.
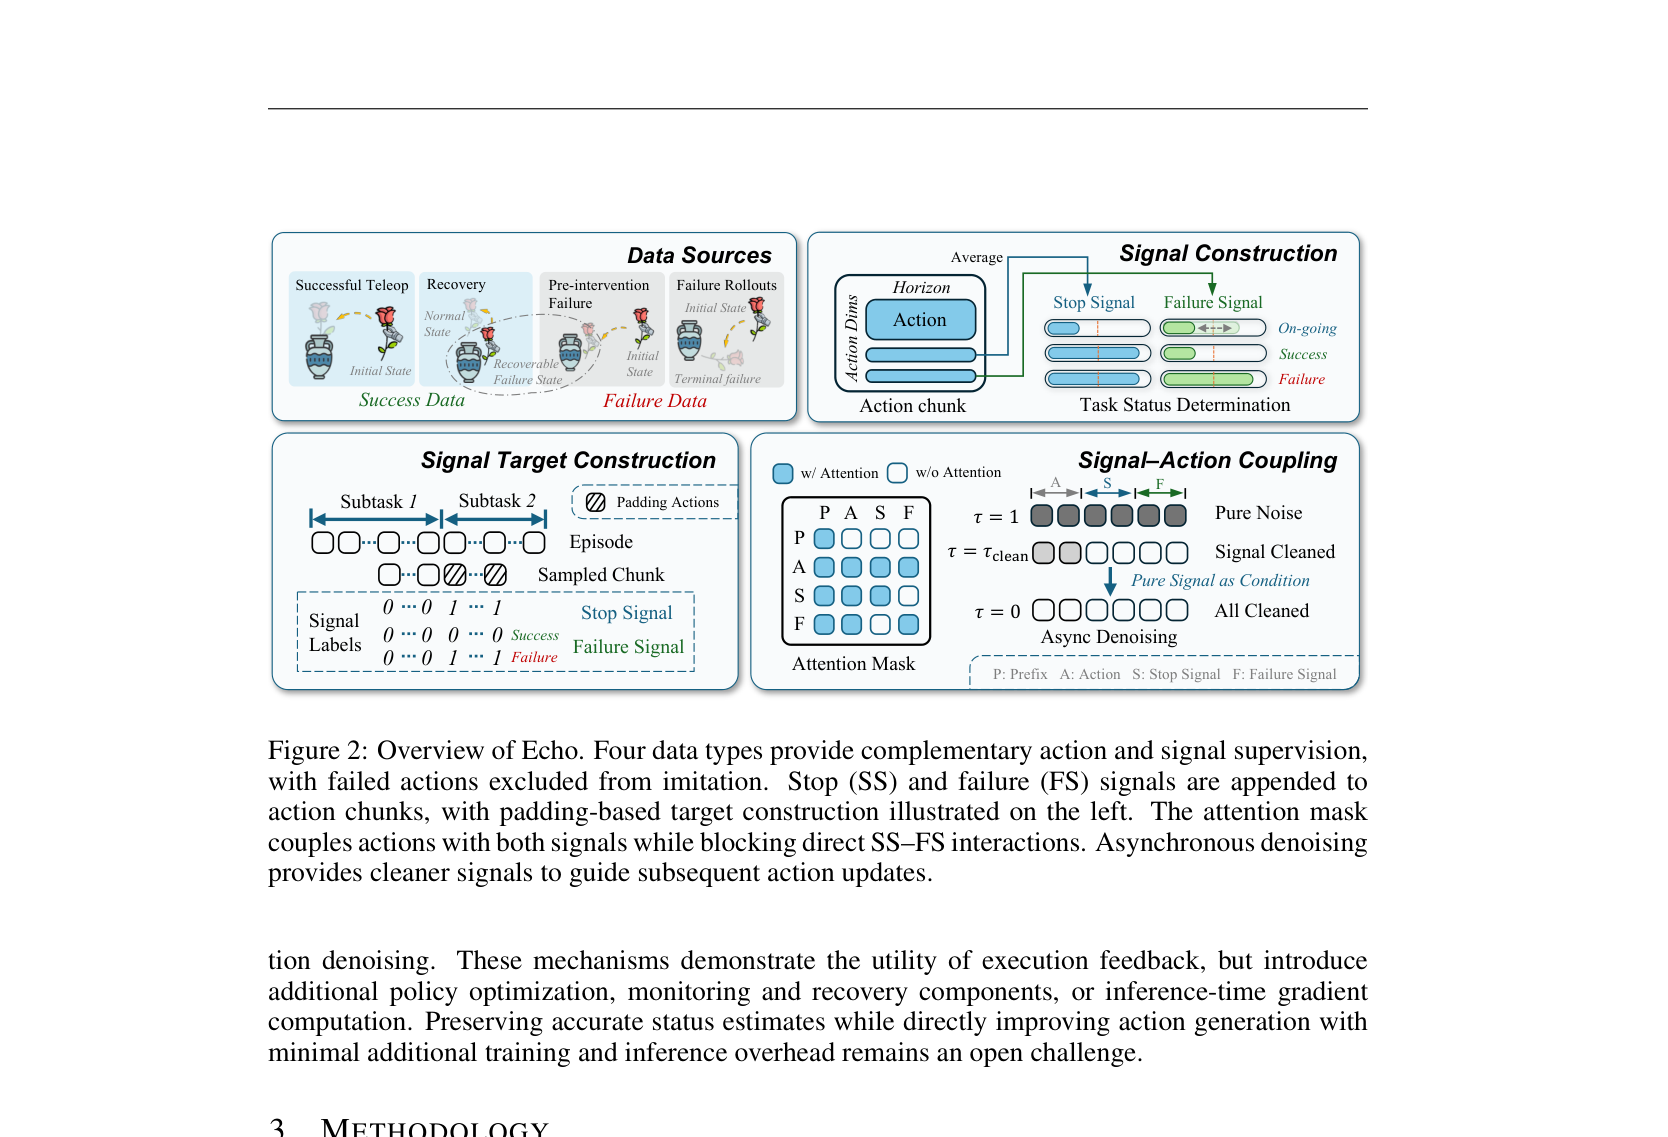
Figure 2 — 제안된 Echo 프레임워크의 전반적인 구조와 구성 요소(data sources, signal construction, signal-action coupling)를 설명하는 핵심 다이어그램.
Echo는 5가지 실제 조작(real-world manipulation) 작업에서 action-only baseline 대비 일관된 정책 성능 향상(consistently improves policy performance)을 입증했습니다. 특히, Insert Flower 작업에서 Task Completion Score는 Echo가 8.33로 action-only π0.5의 5.67을 크게 상회하며, Frame F1은 92.18%, Traj. F1은 96.67%의 높은 status prediction 정확도를 보였습니다 [Table 2], [Table 3]. Out-of-Distribution (OOD) 조건에서 Echo의 성능 향상 폭은 In-Domain (ID) 조건보다 더 컸으며, Insert Flower OOD Task Completion Score는 Echo가 8.00으로 action-only π0.5의 2.00 대비 상당한 개선을 보였습니다 [Table 4]. 컴포넌트 ablation 연구에서는 Signal-to-action attention을 제거했을 때 task completion이 5.00으로 action-only baseline 수준으로 감소하며, Asynchronous Denoising을 사용하지 않으면 task completion이 7.33로 Echo 기본 성능 8.33보다 낮아져 cleaner status estimates가 subsequent action updates를 가이드하는 것의 중요성을 확인했습니다 [Table 5].
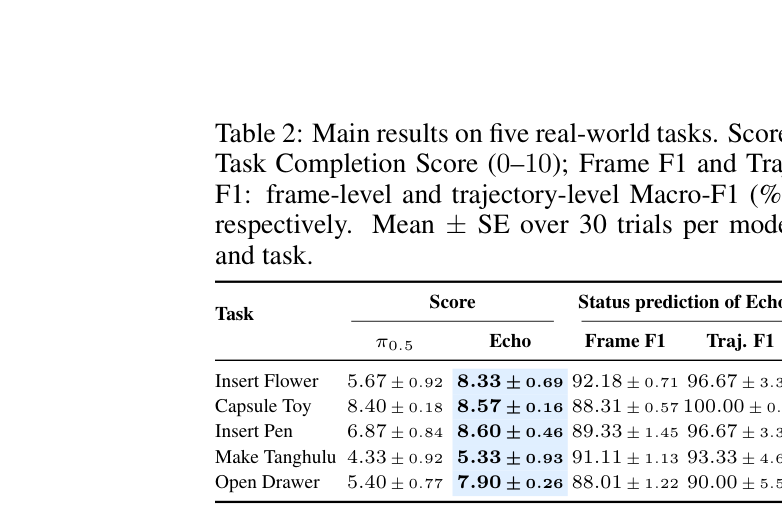
Table 2 — 다섯 가지 real-world tasks에서 Echo의 Task Completion Score, Frame F1, Traj. F1 등 핵심 정량적 성능 결과를 제시하는 테이블.
4. Conclusion & Impact (결론 및 시사점)
Echo는 single VLA 내에서 로봇 동작과 Task Status Signal을 공동으로 denoising하는 compact framework입니다. 이 모델은 frame-level progress annotations 없이 성공, 실패, 복구 데이터를 통해 신호를 학습하며, controlled interactions 및 Asynchronous Denoising을 사용하여 action generation을 가이드합니다. real-world manipulation experiments를 통해 Echo는 정확한 status prediction과 향상된 task completion을 입증하며, Task Status Signal이 모니터링뿐만 아니라 action generation을 직접적으로 개선하는 데 효과적임을 보여주었습니다. 이 연구는 로봇 시스템이 minimal additional overhead로 작업 상태를 인식하고, 이를 기반으로 adaptive하고 corrective behavior를 생성할 수 있는 가능성을 열어 robust robotic manipulation 분야에 중요한 시사점을 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] World Guidance: World Modeling in Condition Space for Action Generation
- [논문리뷰] RynnVLA-002: A Unified Vision-Language-Action and World Model
- [논문리뷰] EBT-Policy: Energy Unlocks Emergent Physical Reasoning Capabilities
- [논문리뷰] AgentVQA: A Unified Benchmark for Agentic Visual Understanding
- [논문리뷰] LeWAM: End-to-End World and Action Modeling with JEPAs
Review 의 다른글
- 이전글 [논문리뷰] Easy-3Dfy: Object-Level Geometric Composition for Single-Image 3D Scene Construction
- 현재글 : [논문리뷰] Echo: Coupled Action and Task Status Signal Denoising for Vision Language Action Models
- 다음글 [논문리뷰] Every Weight Is a Path of Shared Discrete Decisions
댓글