[논문리뷰] Predictive Closure: A Set-Level Characterization of JEPA's Feature Selection
링크: 논문 PDF로 바로 열기
저자: Mosh Levy, Aly Lidayan, Yoav Goldberg
1. Key Terms & Definitions (핵심 용어 및 정의)
- JEPA (Joint-Embedding Predictive Architecture): Encoder와 Predictor가 함께 훈련되어 다음 관측(observation)의 latent representation을 예측하는 representation을 생성하는 아키텍처입니다.
- Predictive Closure: JEPA의 feature selection을 set-level에서 특성화하는 개념으로, latent representation이 가장 높은 Predictive Information을 갖는 feature set을 선택하는 것을 의미합니다.
- Predictive Information: 현재 feature set의 값이 미래 feature set의 값에 대해 제공하는 상호 정보량(Mutual Information)을 지칭합니다.
- Aleatoric Uncertainty: Full current observation이 알려져 있더라도 feature set의 다음 값이 여전히 불확실한 정도를 나타내는 용어입니다.
- Predictive Leakage: Feature set의 현재 값에서 예측할 수 있는 것을 넘어, 전체 current observation이 feature set의 다음 값을 얼마나 잘 예측하는지 나타내는 지표입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Joint-Embedding Predictive Architecture (JEPA)의 latent representation이 어떤 feature를 인코딩하는지 명확히 설명하는 데 초점을 맞춥니다. JEPA는 planning 및 기타 downstream tasks에 유용한 representation을 학습하지만, 어떤 feature를 포함해야 하는지에 대한 명시적인 지침이 없어, 어떤 feature들이 최종 representation에 포함될지 불분명합니다. 특히, 신호등과 같이 예측하기 어려운 feature가 representation에 포함될 것인지에 대한 의문이 제기되었습니다 [Figure 1]. 기존 연구들은 JEPA의 feature selection을 개별 feature의 예측 가능성(predictability)에 기반하여 설명해왔으며, 이는 예측 불가능한 feature가 representation에서 제외될 수 있다는 우려를 낳았습니다. 그러나 저자들은 feature 간의 관계, 예를 들어 신호등의 현재 색상이 자전거 운전자의 다음 움직임을 예측하는 데 도움이 되는 경우처럼, prediction error가 feature 간의 관계에 의해 영향을 받는다는 점을 지적하며, 개별 feature만을 평가하는 기존 접근 방식의 한계를 제기합니다.
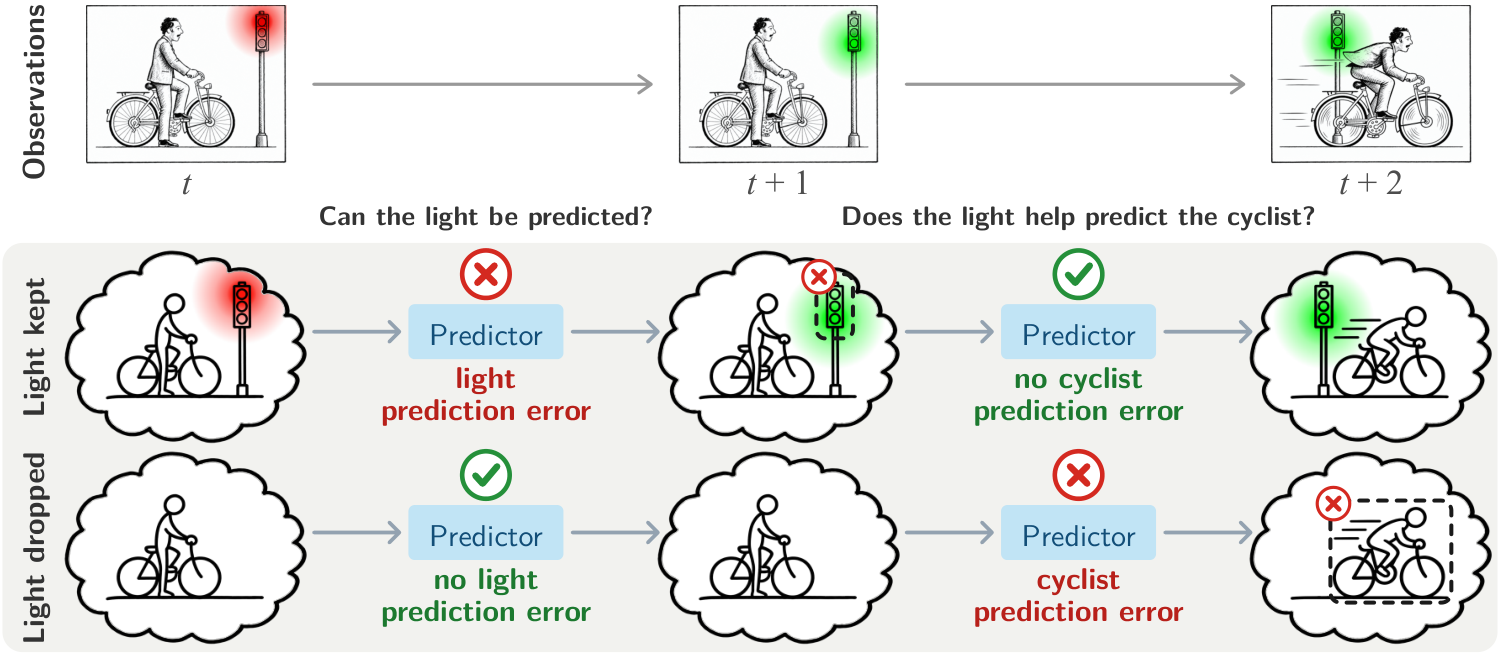
Figure 1 — JEPA Latent Representation 내 신호등 포함 여부
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 JEPA의 feature selection이 개별 feature가 아닌 feature set의 Joint Properties에 따라 결정된다는 Predictive Closure 특성화를 제안합니다. 이 방법론은 JEPA의 training objective를 재구성하여, 이상적으로 훈련된 encoder가 현재 feature set과 다음 feature set의 값 사이의 Predictive Information (Mutual Information)을 최대화하는 Feasible Set을 선택함을 이론적으로 증명합니다 [Equation 2]. Predictive Information은 다시 Aleatoric Uncertainty와 Predictive Leakage라는 두 가지 구성 요소로 분해될 수 있으며 [Equation 3], 이를 통해 특정 feature가 set의 predictive leakage를 줄이거나(즉, 다른 feature 예측에 도움을 주거나), 자체의 다음 값이 set의 현재 값에 의해 결정될 때 representation에 기여하는 방식을 설명합니다.
저자들은 통제된 실험을 통해 Predictive Closure의 예측들을 검증했습니다.
- Cross-subsidization: 예측 불가능한 신호등(traffic light) feature가 다른 이미지 feature를 예측하는 데 더 유용해질수록, 그 자체의 미래는 예측 불가능하더라도 latent representation에서 더 잘 Decodable해짐을 확인했습니다 [Figure 2].
- Set Switching: 한 feature set 내의 예측 관계를 강화하면, 다른 경쟁 set의 관계가 변하지 않아도 representation에서 해당 set의 decodability가 증가하고 경쟁 set의 decodability는 감소함을 보였습니다 [Figure 3].
- Feasibility Dependence: 상호 예측 가능한 feature set의 크기를 latent capacity 이상으로 늘리면, 개별 feature의 예측 가능성은 유지되더라도 해당 set의 representation이 감소하고, 궁극적으로는 다른 set이 더 잘 표현될 수 있음을 입증했습니다 [Figure 4].
- Steering with an auxiliary loss: 단일 이미지 C의 reconstruction을 목표로 하는 auxiliary objective를 추가하면, 직접적으로 reconstruction 대상이 아닌 예측 파트너 D의 representation이 강화되고, 경쟁 feature set A/B의 representation은 감소할 수 있음을 관찰했습니다 [Figure 5].
- Steering with side information: Predictor에 특정 이미지 C를 side information으로 제공하면, 직접적으로 타겟팅되지 않은 예측 파트너 D의 representation이 강화될 수 있음을 보여주었습니다 [Figure 6].
이러한 정량적 결과들은 JEPA의 feature selection이 개별 feature의 예측 가능성뿐만 아니라 feature set 내의 상호 예측 관계 및 latent capacity에 의해 복합적으로 결정됨을 명확히 보여줍니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 JEPA의 representation learning을 Feature Set의 Joint Predictive Value를 통해 새롭게 특성화합니다. 연구는 JEPA가 feasible feature set 중 현재와 다음 상태 간의 Predictive Information (Mutual Information)을 최대화하는 Predictive Closure를 선택한다는 것을 이론적으로 도출하고 실험적으로 검증했습니다. 이 Set-Level 관점은 기존 JEPA 시스템에서 관찰된 feature encoding 현상들을 설명할 뿐만 아니라, 예측 불가능한 feature도 다른 feature를 예측하는 데 유용할 경우 representation에 포함될 수 있음을 시사합니다. 또한, auxiliary objectives나 predictor side information을 활용하여 특정 feature를 직접적으로 타겟팅하지 않고도 predictive partner의 representation을 강화하는 Indirect Steering 가능성을 제시합니다. 이는 task-relevant feature의 representation을 향상시키기 위한 JEPA 시스템 설계에 중요한 방향을 제시하며, 향후 biological representation learning 모델에 대한 이해에도 기여할 수 있을 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] LaLa-World: Scaling Latent World Models with Natural Language Actions
- [논문리뷰] Right Screen, Wrong Transition: World Models as Verifiers for GUI Agents
- [논문리뷰] Lexical Reference Frames: Interpreting LM Residual Streams in Native Semantics
- [논문리뷰] Adaptive Latent Capacity for World Models
- [논문리뷰] LatentPress: Context Compression Beyond Text and Vision
Review 의 다른글
- 이전글 [논문리뷰] PaperFormalizer: Author-in-the-Loop Autoformalization of Research Papers in Lean
- 현재글 : [논문리뷰] Predictive Closure: A Set-Level Characterization of JEPA's Feature Selection
- 다음글 [논문리뷰] RSIHub: A Composable Framework for Agent-Evolution Methods
댓글