[논문리뷰] RoboJev: An Open Vision-Language Judge for Robot Success Detection
링크: 논문 PDF로 바로 열기
저자: Josef Liyanjun Chen, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- RoboJev-27B: 본 논문에서 제안하는 open-weight vision-language model로, 로봇 조작 작업의 성공 여부를 판단하는 detector임.
- JEV-27B-VL: RoboJev의 기반 모델로, 로봇 작업의 시각적 데이터를 해석하기 위한 사전 학습된 vision-language backbone임.
- LoRA (Low-Rank Adaptation): 사전 학습된 언어 모델의 파라미터를 고정한 상태에서 특정 태스크를 위해 일부 weight만을 효율적으로 fine-tuning하는 기술임.
- AUROC (Area Under the Receiver Operating Characteristic curve): 모델의 이진 분류 성능(성공/실패)을 평가하는 지표로, 임계값 변화에 따른 모델의 변별력을 측정함.
- ECE (Expected Calibration Error): 모델의 예측 확률이 실제 성공률과 얼마나 일치하는지를 측정하는 지표로, 예측값의 신뢰도를 평가함.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 연구는 복잡한 로봇 조작 태스크 수행 시, 어떤 에피소드가 성공적으로 완료되었는지 자동으로 판별할 수 있는 신뢰성 있는 평가 도구의 부재 문제를 해결하고자 한다. 기존의 로봇 평가 방식은 저수준의 휴리스틱(trajectory length, smoothness 등)에 의존하거나 상업용 API에 종속되어 있어, 투명한 로봇 정책 평가와 일반화된 학습 reward 신호를 얻기 어렵다는 한계가 있다. 저자들은 이러한 한계를 극복하기 위해 공개된 weight를 가지며 재사용 가능한 시각-언어 기반의 성공 판별 모델인 RoboJev-27B를 제안한다. 이는 [Figure 2]에 제시된 바와 같이 태스크 지침과 시각적 프레임들을 입력받아 단일 forward pass를 통해 성공 확률을 출력하는 구조를 갖는다.
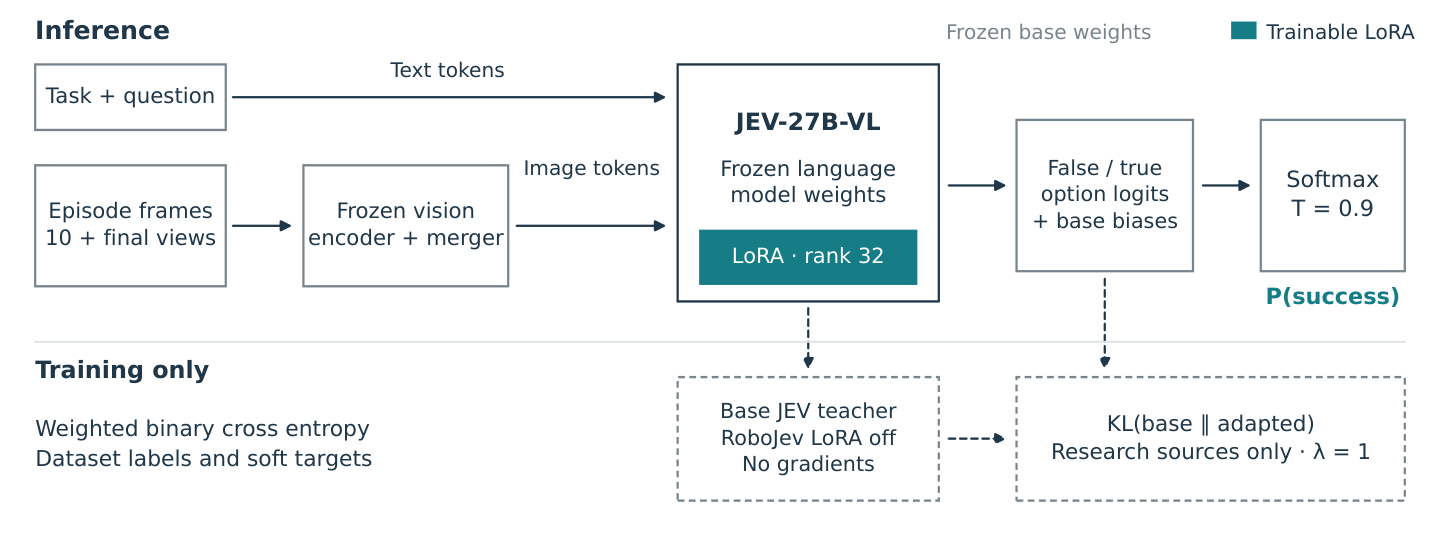
Figure 2 — RoboJev-27B의 학습 및 추론 아키텍처 구조를 직관적으로 설명함.
## 3. Method & Key Results (제안 방법론 및 핵심 결과)
RoboJev-27B는 JEV-27B-VL의 언어 모델 컴포넌트에 rank-32 LoRA를 적용하고 비전 인코더를 고정하여, 총 52,598개의 에피소드 데이터셋을 활용해 fine-tuning함으로써 구현되었다. 모델은 학습 시 연구용 데이터셋에 대해 원본 모델과의 거리를 유지하도록 source-specific KL penalty를 적용하여 성능을 안정화하였고, 이진 분류 성능을 극대화하기 위해 calibrate된 두 토큰 readout 방식을 사용한다. [Table 3]에 따르면, RoboJev-27B는 held-out SO-101 데이터셋에서 95.2%의 Balanced Accuracy와 0.993의 AUROC를 달성하여 기존 baseline 모델들을 유의미하게 상회하였다. 또한, unseen lab/robot 데이터셋에 대해서도 0.890의 AUROC와 78.2%의 Balanced Accuracy를 기록하며 일반화 성능을 입증하였다.
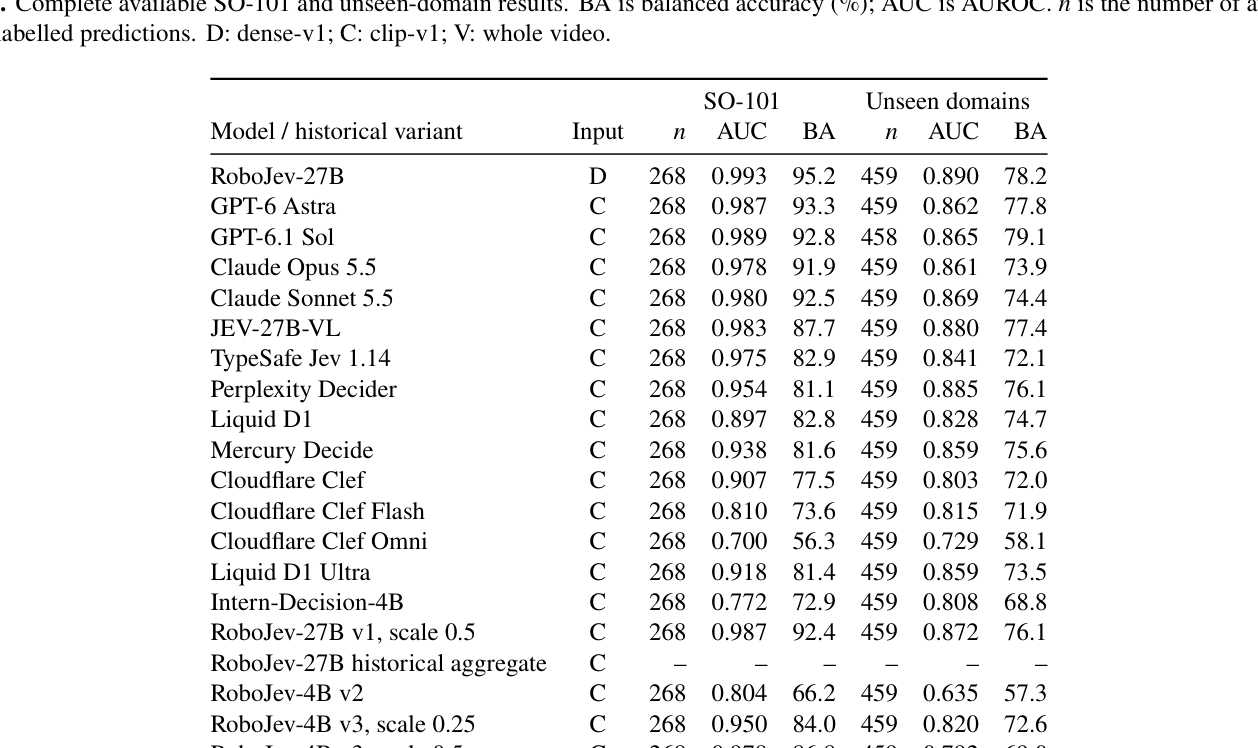
Table 3 — 주요 데이터셋(SO-101 및 Unseen domains)에서의 모델별 정량적 성능 지표 비교
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 다양한 로봇 플랫폼과 태스크 환경에서 사용할 수 있는 범용적인 성공 판별 모델인 RoboJev-27B를 통해 로봇 학습 평가의 자동화와 투명성을 높이는 데 기여한다. 이 연구는 단순히 고성능 모델을 제공하는 것에 그치지 않고, 추론 비용을 1,000번 예측당 $0.19 수준으로 최적화하여 현장 적용성을 크게 개선하였다. 향후 본 연구에서 공개한 모델 weight와 평가 툴은 로봇 강화학습 정책을 위한 reward 신호 생성 및 대규모 로봇 에피소드 데이터의 재평가 작업에 표준적인 도구로 활용될 것으로 기대된다.
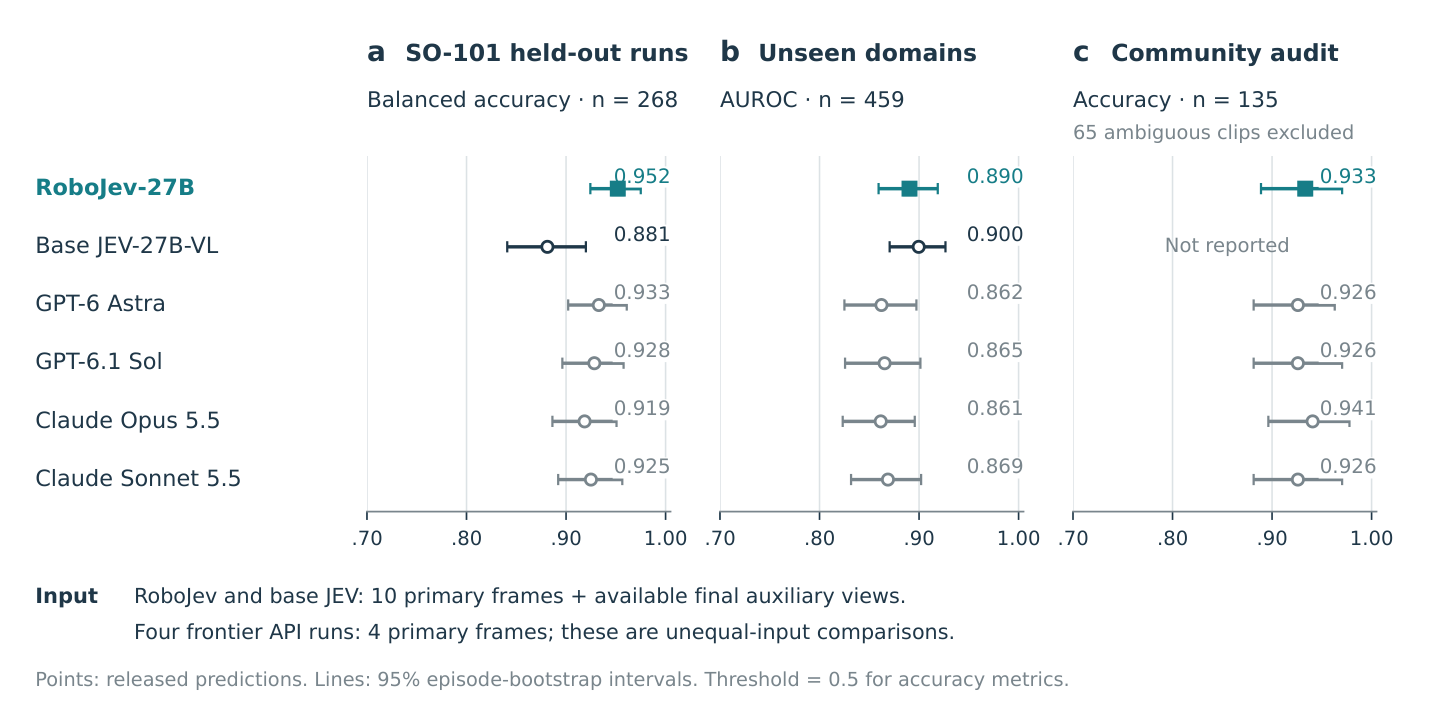
Table 1 — 모델 평가에 사용된 데이터셋의 구성과 규모를 요약하여 실험의 신뢰성을 보여줌.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Stable-Layers: Fine-Tuning Image Layer Decomposition Models with VLM-Scored Reinforcement Learning
- [논문리뷰] PhyGDPO: Physics-Aware Groupwise Direct Preference Optimization for Physically Consistent Text-to-Video Generation
- [논문리뷰] RobotArena infty: Scalable Robot Benchmarking via Real-to-Sim Translation
- [논문리뷰] RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions
- [논문리뷰] OBB-PBD: Extending Parallel Box Decoding to Oriented Bounding Boxes for Referring Expression Grounding in Aerial Imagery
Review 의 다른글
- 이전글 [논문리뷰] RoboHarness: A Simple Harness Outperforms VLA and World Action Models
- 현재글 : [논문리뷰] RoboJev: An Open Vision-Language Judge for Robot Success Detection
- 다음글 [논문리뷰] RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions
댓글