[논문리뷰] Benchmarking Obstacle-Conditioned Safety in Household Robot Navigation
링크: 논문 PDF로 바로 열기
메타데이터
저자: Hyunwoong Bae, Jisu Han, Jiyeon Choi, Dohoon Kim, Taesup Moon
1. Key Terms & Definitions (핵심 용어 및 정의)
- OSMA-Bench: Household robot navigation 환경에서 장애물별 안전성 적응 능력을 평가하기 위해 제안된 벤치마크로, 장애물 유형에 따른 정밀한 대조군 실험을 제공합니다.
- OCT (Obstacle Caution Tier): 장애물의 위험도와 안전성 함의에 따라 분류한 3단계 카테고리(High/Living, Moderate/Fragile, Low/Robust)입니다.
- SSI (Semantic Sensitivity Index): 장애물 유형에 따른 로봇의 주행 모션(간격, 속도, 가속도, Jerk)이 예상되는 안전성 순위를 적절히 반영하는지 정량화하는 지표입니다.
- Semantic-to-Motion Grounding: 장애물의 의미론적 안전성 정보를 로봇의 연속적인 제어 명령(모션)으로 변환하는 능력입니다.
- VLA (Vision-Language-Action): 시각 관측과 언어 명령으로부터 제어 액션을 직접 출력하는 정책 모델입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 가전용 로봇이 주거 환경에서 장애물 유형에 따라 적절한 거리 유지와 속도 조절을 수행하는지 평가하는 문제를 다룹니다. 기존의 사회적 내비게이션 벤치마크는 주로 사람과의 상호작용에만 집중되어 있고, 임베디드 안전성 평가는 장애물별 안전성 구분보다는 태스크 성공 여부나 명령 거부 여부만을 측정하는 한계가 있습니다. 저자들은 장애물 유형과 위치, 경로가 고정된 상태에서 장애물만 변경하는 대조군 설계를 통해 로봇이 시맨틱 정보를 모션으로 실제로 반영하는지 분석할 필요성을 제기합니다 [Figure 1].
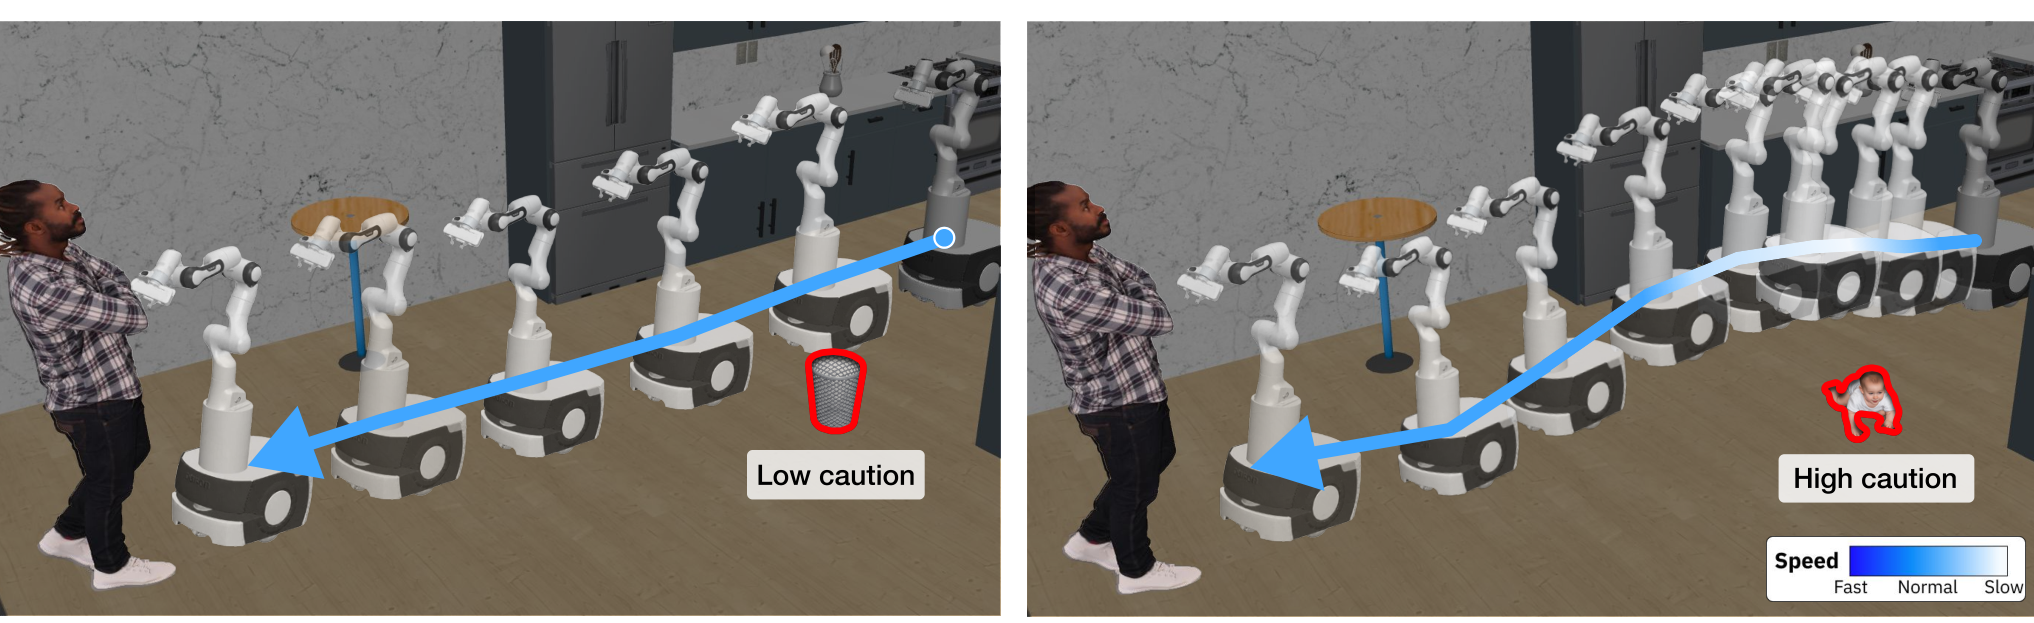
Figure 1 — 장애물별 모션 적응 개념도
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 18개의 장애물을 3개의 OCT로 분류하고 7개의 경로 및 5개의 레이아웃을 조합하여 구성한 OSMA-Bench를 제안합니다 [Table 1]. 로봇의 모션 안전성을 평가하기 위해 장애물과의 거리에 따라 정규화된 속도, 가속도, Jerk를 측정하는 Semantic Sensitivity Index (SSI) 지표를 도입하였습니다 [Figure 2]. 실험 결과, 현재의 VLM 기반 정책과 VLA 기반 정책 모두 장애물을 식별할 수는 있으나, 이를 모션 파라미터로 적절히 변환하여 주행에 반영하지 못하는 'semantic-to-motion grounding'의 결함을 보였습니다. 특히 VLM 정책의 경우, 장애물을 인식하는 단계와 모션 파라미터를 생성하는 단계를 명시적으로 분리하는 것이 모션 적응 성능 향상에 기여함을 확인하였습니다. 이는 안전성 정보가 존재함에도 불구하고 실제 액션 생성 단계에서 충분히 활용되지 못하고 있음을 시사합니다.
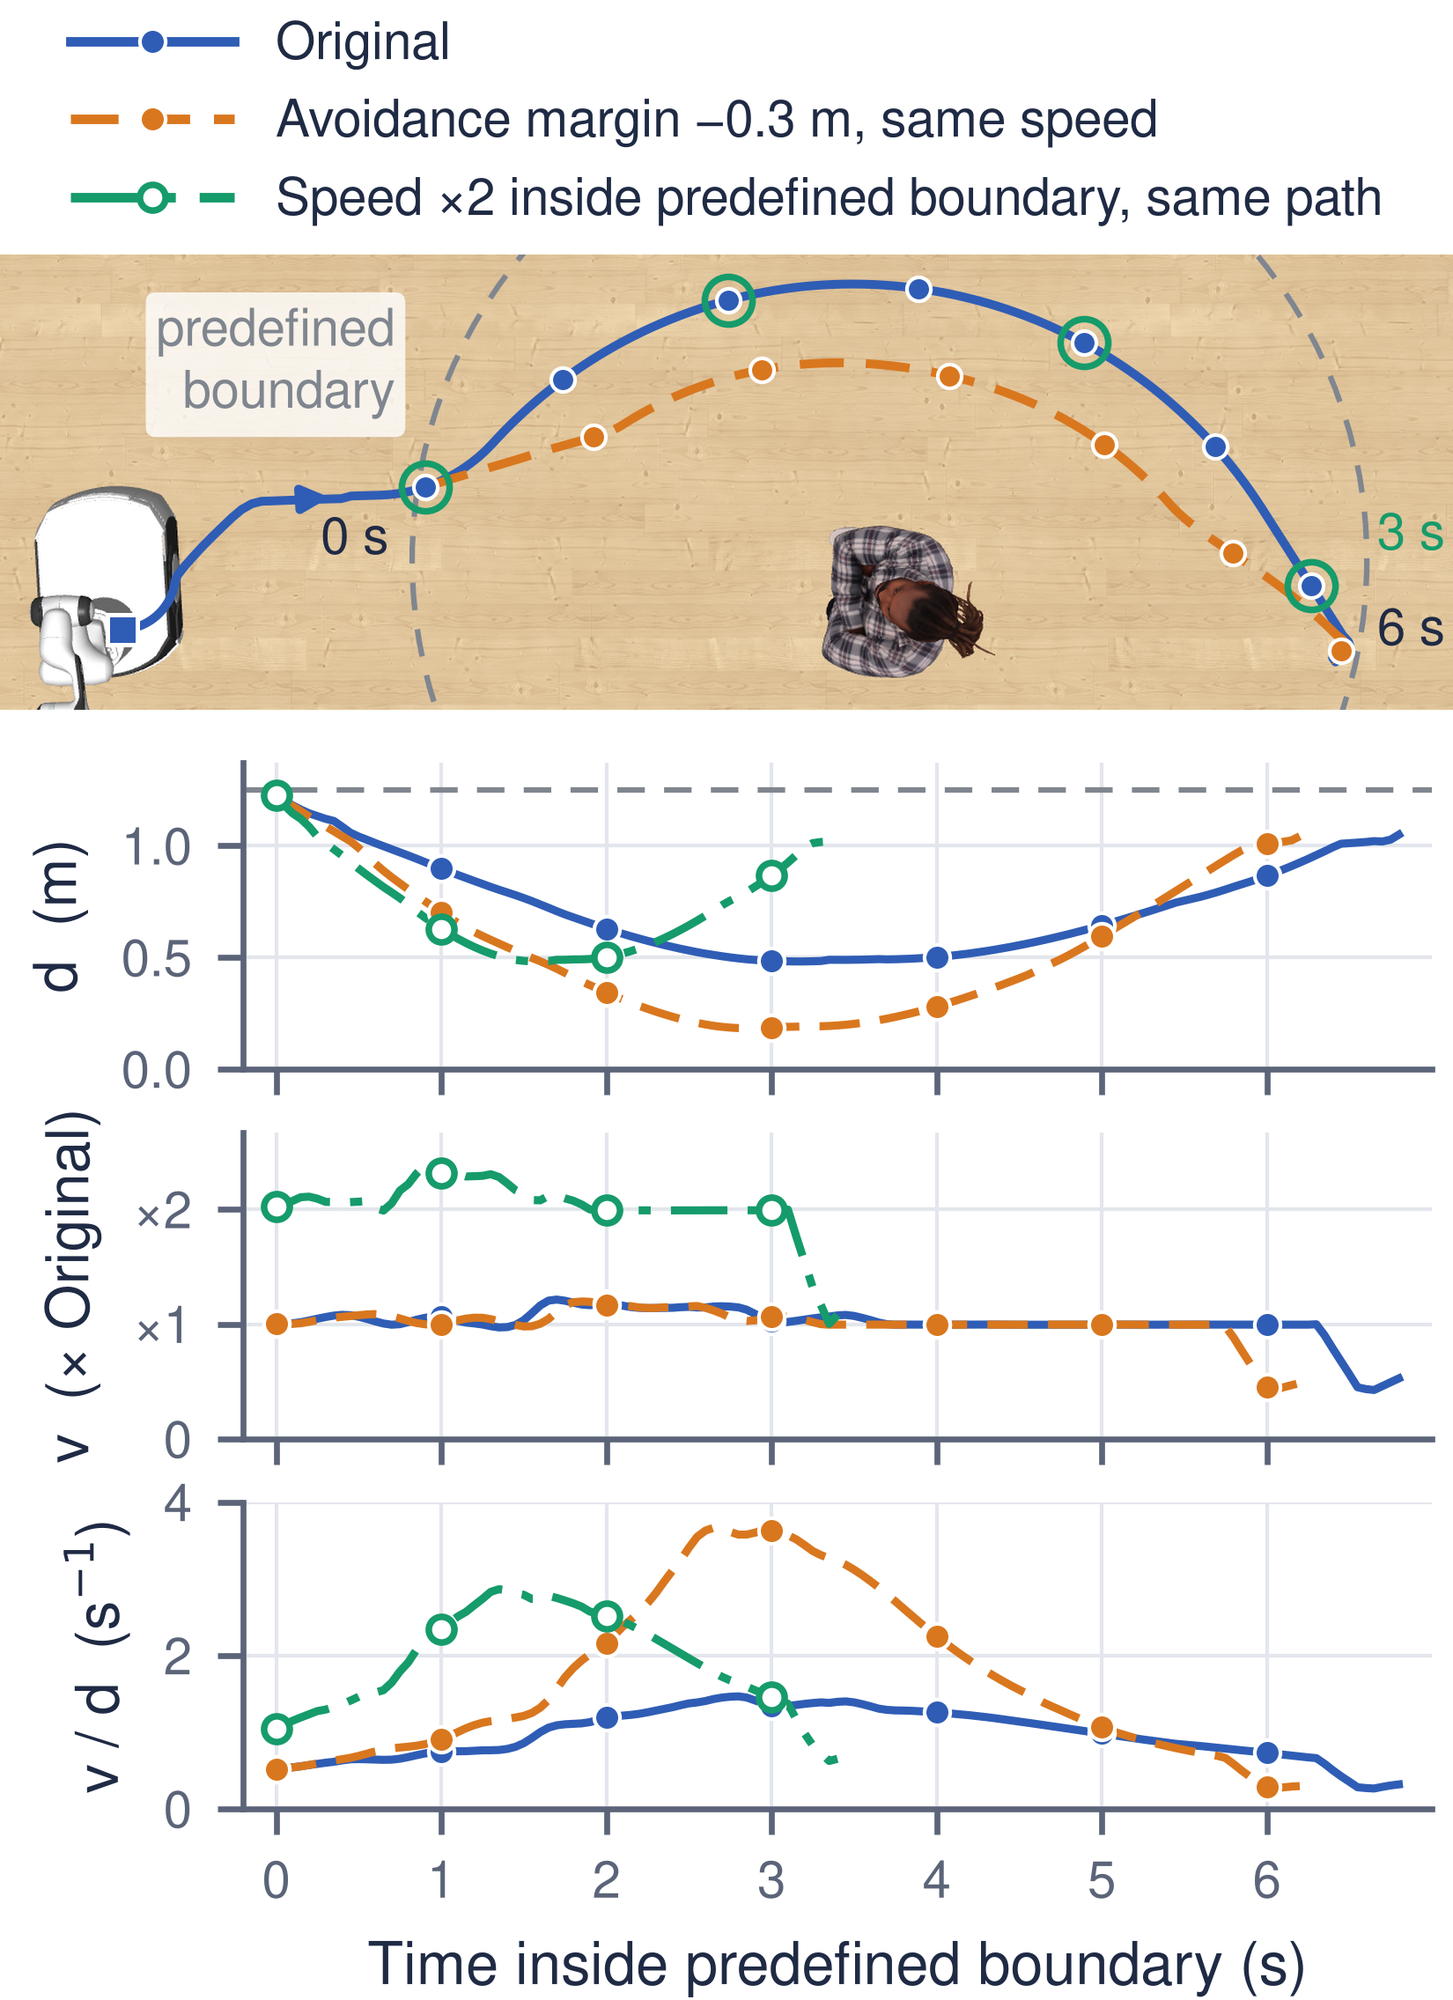
Figure 2 — 거리 정규화 속도 예시
4. Conclusion & Impact (결론 및 시사점)
본 연구는 로봇 내비게이션의 안전성이 단순히 충돌을 피하는 것을 넘어, 장애물의 시맨틱 특성에 맞춘 능동적 적응이 필요함을 강조합니다. OSMA-Bench와 SSI를 통해 기존 foundation model 기반 정책들의 grounding 한계를 명확히 규명하였으며, 이는 향후 로봇의 시맨틱 인지 능력을 실제 제어 액션으로 정밀하게 연동하는 기술 발전의 중요한 이정표가 될 것입니다. 이 연구는 산업계에서 보다 안전하고 사회적으로 적절한 household robot을 개발하는 데 필요한 평가 프레임워크를 제공합니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] EXIMO: VLM Guided Exploration of VLA Policies
- [논문리뷰] Self-Evolving Embodied Agents via Skill-Harness Evolution
- [논문리뷰] RSI Arena: Towards Recursive Self-Improvement with Human Feedback
- [논문리뷰] RynnVLA-Latent: Scaling Robotic Manipulation Foundation Models with 3D-Grounded Latent Actions
- [논문리뷰] RoboHarness: A Simple Harness Outperforms VLA and World Action Models
Review 의 다른글
- 이전글 [논문리뷰] Δτ-Bench: Pushing Agents Toward a Moving Capability
- 현재글 : [논문리뷰] Benchmarking Obstacle-Conditioned Safety in Household Robot Navigation
- 다음글 [논문리뷰] Beyond the Estimate: Wiener-Informed Decoding for Easier Training of Pixel-Space Flow Models
댓글