[논문리뷰] LociArt: A Unified Paradigm for Free-Style Local Video Stylization
링크: 논문 PDF로 바로 열기
저자: Yuxuan Chen, Feng Xie, Jiagao Hu, Fuhao Li, Zepeng Wang, Fei Wang, Daiguo Zhou
1. Key Terms & Definitions (핵심 용어 및 정의)
- GRNStyle: Generative Refinement Networks(GRN)를 기반으로 구축된 모델로, 영역별(local) 비디오 스타일화를 위해 영역과 스타일을 통합 제어하는 방법론입니다.
- Polar Style-Aware Mask: 스타일 식별자(Style Identity)를 등규범(equal-norm) 방향으로 임베딩하여 영역 제어와 스타일 적용을 통합하는 방식입니다.
- Representation–Geometry Mask Conditioning: VAE 인코딩된 마스크 특징과 원시 마스크(raw-mask)의 기하학적 지원을 결합하여 시공간적 맥락과 공간적 충실도를 동시에 유지하는 조건부 기법입니다.
- LociArt-100K Dataset: 100K 규모의 로컬 스타일화 데이터셋으로, 객체 제거, 매팅, 합성을 통해 생성된 정밀한 시공간적 페어 데이터를 포함합니다.
- SPS (Style Prototype Similarity): 지역화된 영역의 스타일 충실도를 평가하기 위해 도입된 핵심 정량 지표입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 비디오 내 특정 객체나 영역만을 선택하여 스타일을 변경하고, 비대상 영역(non-target content)의 원본 상태를 정밀하게 보존해야 하는 Free-style local video stylization 문제를 해결합니다. 기존의 전역적(global) 스타일화 방법은 국소적 편집 시 스타일과 대상 영역 간의 불명확한 연관성 문제로 인해 주변부로 스타일이 번지거나(leakage) 시공간적 일관성이 훼손되는 한계가 있습니다. 또한, 기존 연구들은 국소적 변화를 정밀하게 학습하거나 평가할 수 있는 대규모 페어 데이터셋과 평가 프로토콜이 부족하다는 문제에 직면해 있습니다 [Figure 1].
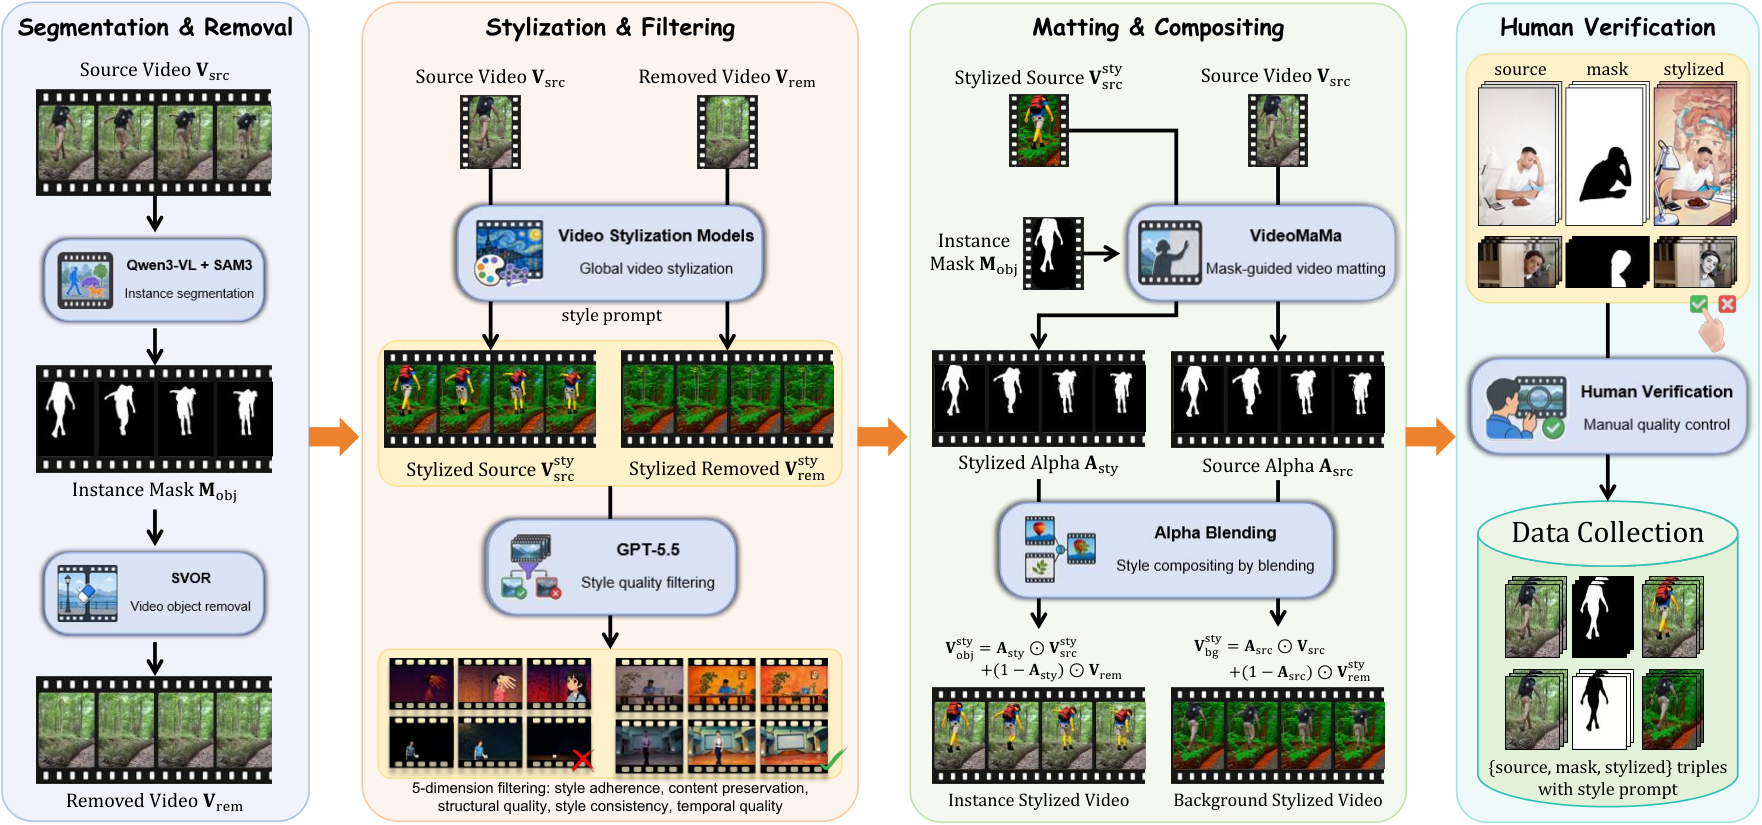
Figure 1 — 데이터 구축 파이프라인 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 정교한 데이터 구축 파이프라인과 GRNStyle 모델을 결합한 통합 패러다임 LociArt를 제안합니다. 제안된 GRNStyle은 극좌표 기반의 스타일 인식 마스크를 통해 스타일 식별자를 영역에 바인딩하며, Representation–Geometry Mask Conditioning을 통해 인코딩된 맥락 정보와 기하학적 지원을 통합하여 정밀한 시공간적 제어를 수행합니다 [Figure 2]. 주요 실험 결과, GRNStyle-2B 모델은 LociArt Benchmark에서 foreground SPS 0.407, background SPS 0.705를 기록하며 기존 방식 대비 우월한 성능을 보였습니다 [Table 1]. 또한, TC (Temporal Consistency) 지표에서 0.983을 달성하여 높은 수준의 시공간적 안정성을 입증하였으며, 기존 이미지 기반 및 비디오 편집 모델들과 비교하여 정성적·정량적 측면에서 모두 우수한 스타일 충실도와 보존력을 보였습니다 [Figure 3].
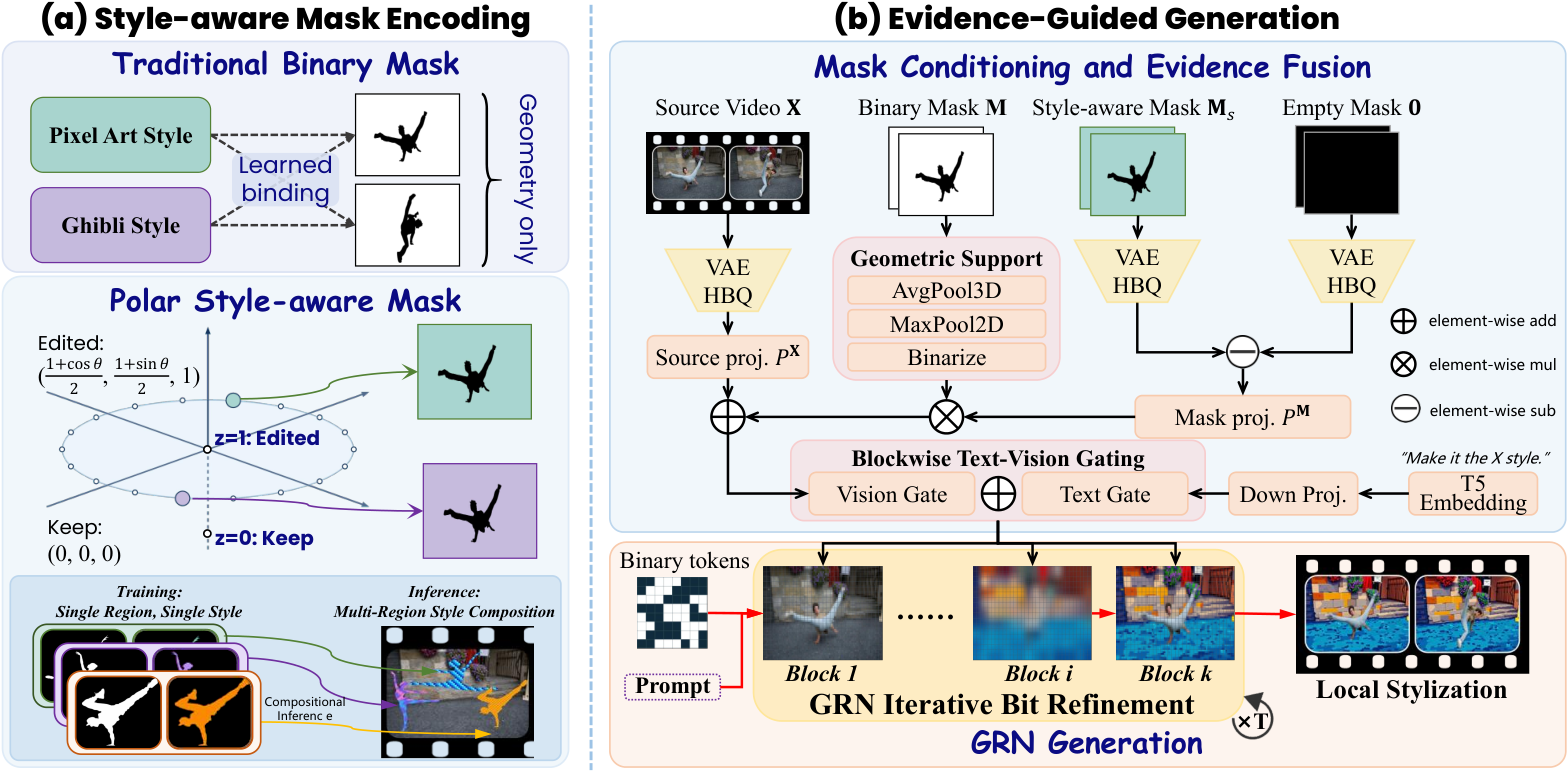
Figure 2 — GRNStyle 아키텍처 개요
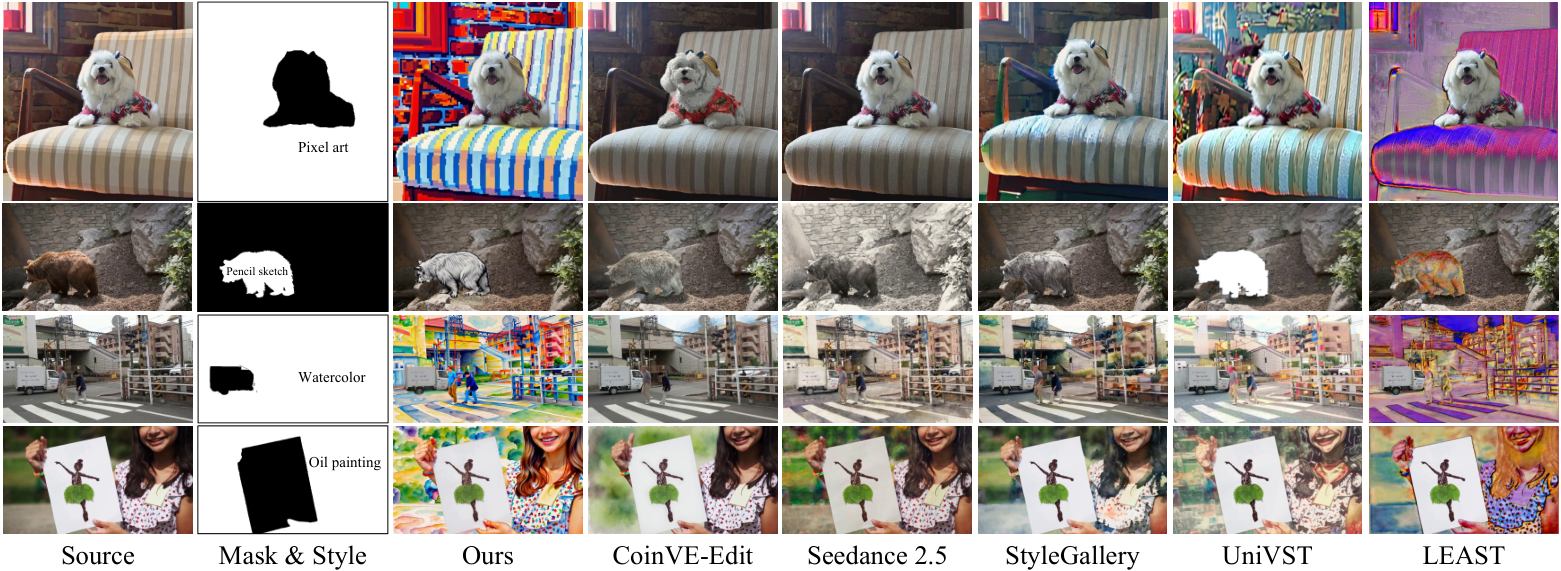
Figure 3 — 로컬 스타일화 정성적 비교
4. Conclusion & Impact (결론 및 시사점)
본 연구는 국소적 비디오 스타일화 작업을 체계화하고 이를 구현하기 위한 효과적인 모델링과 대규모 데이터셋을 성공적으로 제시하였습니다. 특히 Polar style-aware mask와 Representation-geometry conditioning은 복합적인 영역 제어를 가능하게 하여, 단일 영역 학습만으로도 다중 영역·다중 스타일 작성이 가능한 확장성을 확보하였습니다. 이러한 결과는 학계의 비디오 편집 연구를 고도화할 뿐만 아니라, 디지털 영상 제작 및 광고 분야와 같은 산업계에서 정밀한 비디오 예술 편집 워크플로우를 자동화하는 데 중요한 기반 기술이 될 것입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] World Observer: Joint Actor-Observer Generation for Persistent World Modeling
- [논문리뷰] GRNEdit: Efficient General Video Editing from a New Binary-Evidence Perspective in Generative Refinement Networks
- [논문리뷰] Out of Sight but Not Out of Mind: Hybrid Memory for Dynamic Video World Models
- [논문리뷰] TrajLoom: Dense Future Trajectory Generation from Video
- [논문리뷰] DreamStyle: A Unified Framework for Video Stylization
Review 의 다른글
- 이전글 [논문리뷰] Lipi-Ghor: A Large-Scale, Diarized, Multi-Domain Bengali Speech Corpus and a Scalable Pipeline for Building It
- 현재글 : [논문리뷰] LociArt: A Unified Paradigm for Free-Style Local Video Stylization
- 다음글 [논문리뷰] MLE-World: Predicting Machine Learning Experiment Outcomes with a Learned World Model
댓글