[논문리뷰] Nemotron-Labs-Diffusion-Uni: Elastic Self-Refining Unified Diffusion LLM with Cross-Paradigm On-Policy Distillation
링크: 논문 PDF로 바로 열기
메타데이터
저자: Shufan Li, Hanrong Ye, Greg Heinrich, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- NLD-Uni: Visual understanding과 generation을 모두 수행하기 위해 고안된 unified discrete diffusion large language model입니다.
- Cross-Paradigm OPD (On-Policy Distillation): 서로 다른 패러다임의 모델(예: Autoregressive VLM, continuous flow model)로부터 knowledge를 추출하여 unified DLLM으로 전이시키는 학습 프레임워크입니다.
- Progressive Self-Refining Diffusion: 고정된 mask 상태가 아닌, token age를 도입하여 중간 상태를 거쳐 점진적으로 정제하는 새로운 확산 과정입니다.
- Elastic-MoT (Elastic Mixture-of-Transformer): 작업의 필요성에 따라 서로 다른 expert tower(understanding/generation)를 동적으로 로드하는 모델 아키텍처입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 기존 unified DLLM(Discrete Diffusion Language Model)이 특화된 VLM이나 continuous flow model에 비해 성능 격차가 크다는 문제를 해결하고자 합니다. 기존의 Masked Diffusion Model(MDM)은 훈련 시의 binary mask 환경과 추론 시의 생성 환경이 불일치하며, 복잡한 visual generation을 수행하기에는 iterative refinement 능력이 부족합니다 [Figure 1]. 또한, 강력한 AR VLM이나 continuous diffusion teacher로부터 직접적인 지식 증류(distillation)를 수행하려 할 때, 서로 다른 생성 패러다임으로 인해 ill-formed supervision이 발생하는 한계가 있습니다. 이러한 성능 격차를 줄이기 위해 저자들은 새로운 아키텍처와 학습 패러다임을 제안합니다.
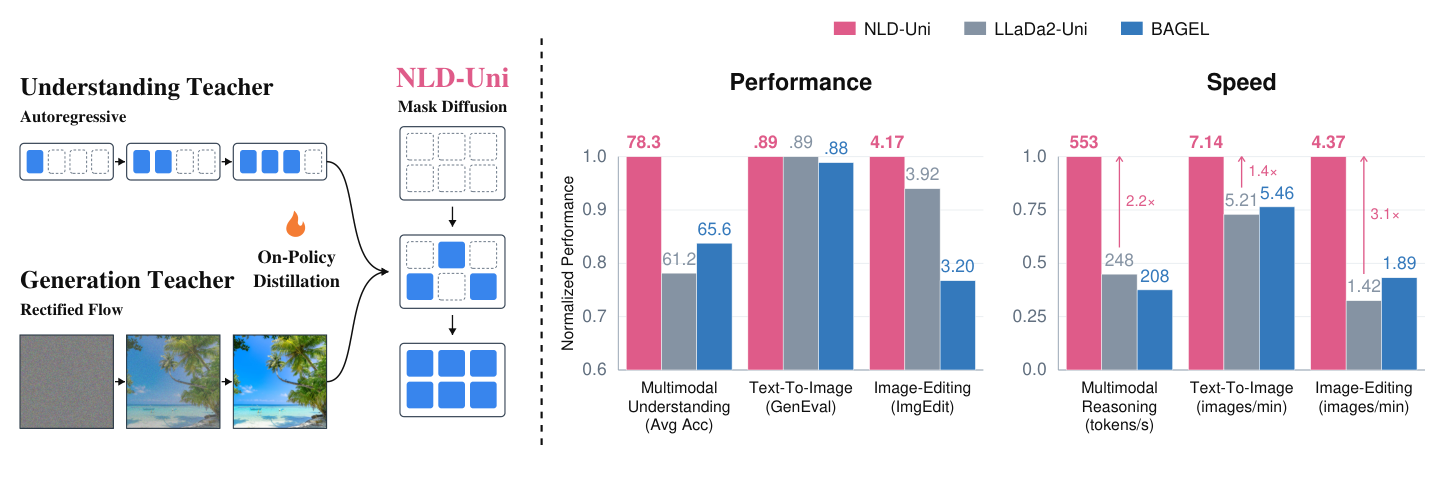
Figure 1 — NLD-Uni의 개요 및 성능 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 NLD-Uni를 통해 Cross-Paradigm OPD와 Progressive Self-Refining 과정을 제안합니다. 첫째, transitivity를 활용한 증류를 통해 AR VLM teacher의 이해 능력을 diffusion view로 전이시키며, 연속적인 teacher-refined target을 생성하여 generation 능력을 향상시킵니다 [Figure 5, Figure 6]. 둘째, Ball-tree 기반의 계층적 구조를 통해 token age를 도입하고, masked 상태에서 clean 상태로 직접 점프하는 대신 중간 단계를 거쳐 점진적으로 self-refining하는 메커니즘을 적용하였습니다 [Figure 4].
실험 결과, NLD-Uni는 다양한 visual understanding 및 reasoning 벤치마크에서 state-of-the-art 성능을 달성했습니다. 특히 MathVista와 Geometry3k 같은 multimodal reasoning task에서 기존 diffusion 모델 대비 상당한 성능 향상을 보였으며, HPSv3 지표 기준으로는 continuous diffusion 모델인 Flux.1-dev나 Qwen-Image를 상회하는 결과를 얻었습니다 [Table 1, Table 2, Table 3]. 이는 unified DLLM이 특화 모델들의 성능에 근접할 수 있음을 입증합니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 unified diffusion LLM의 학습 패러다임을 근본적으로 개선하여 이해와 생성 능력의 동시 성장을 가능하게 하였습니다. 제안된 Cross-Paradigm OPD는 이종 패러다임 간의 지식 전이 가능성을 확인해주었으며, Progressive Self-Refining은 discrete diffusion의 visual fidelity를 크게 향상시켰습니다. 이러한 연구 성과는 향후 범용 multimodal 인공지능 모델 설계에 있어 unified architecture의 확장성과 효율성을 증명하는 중요한 이정표가 될 것으로 기대됩니다.
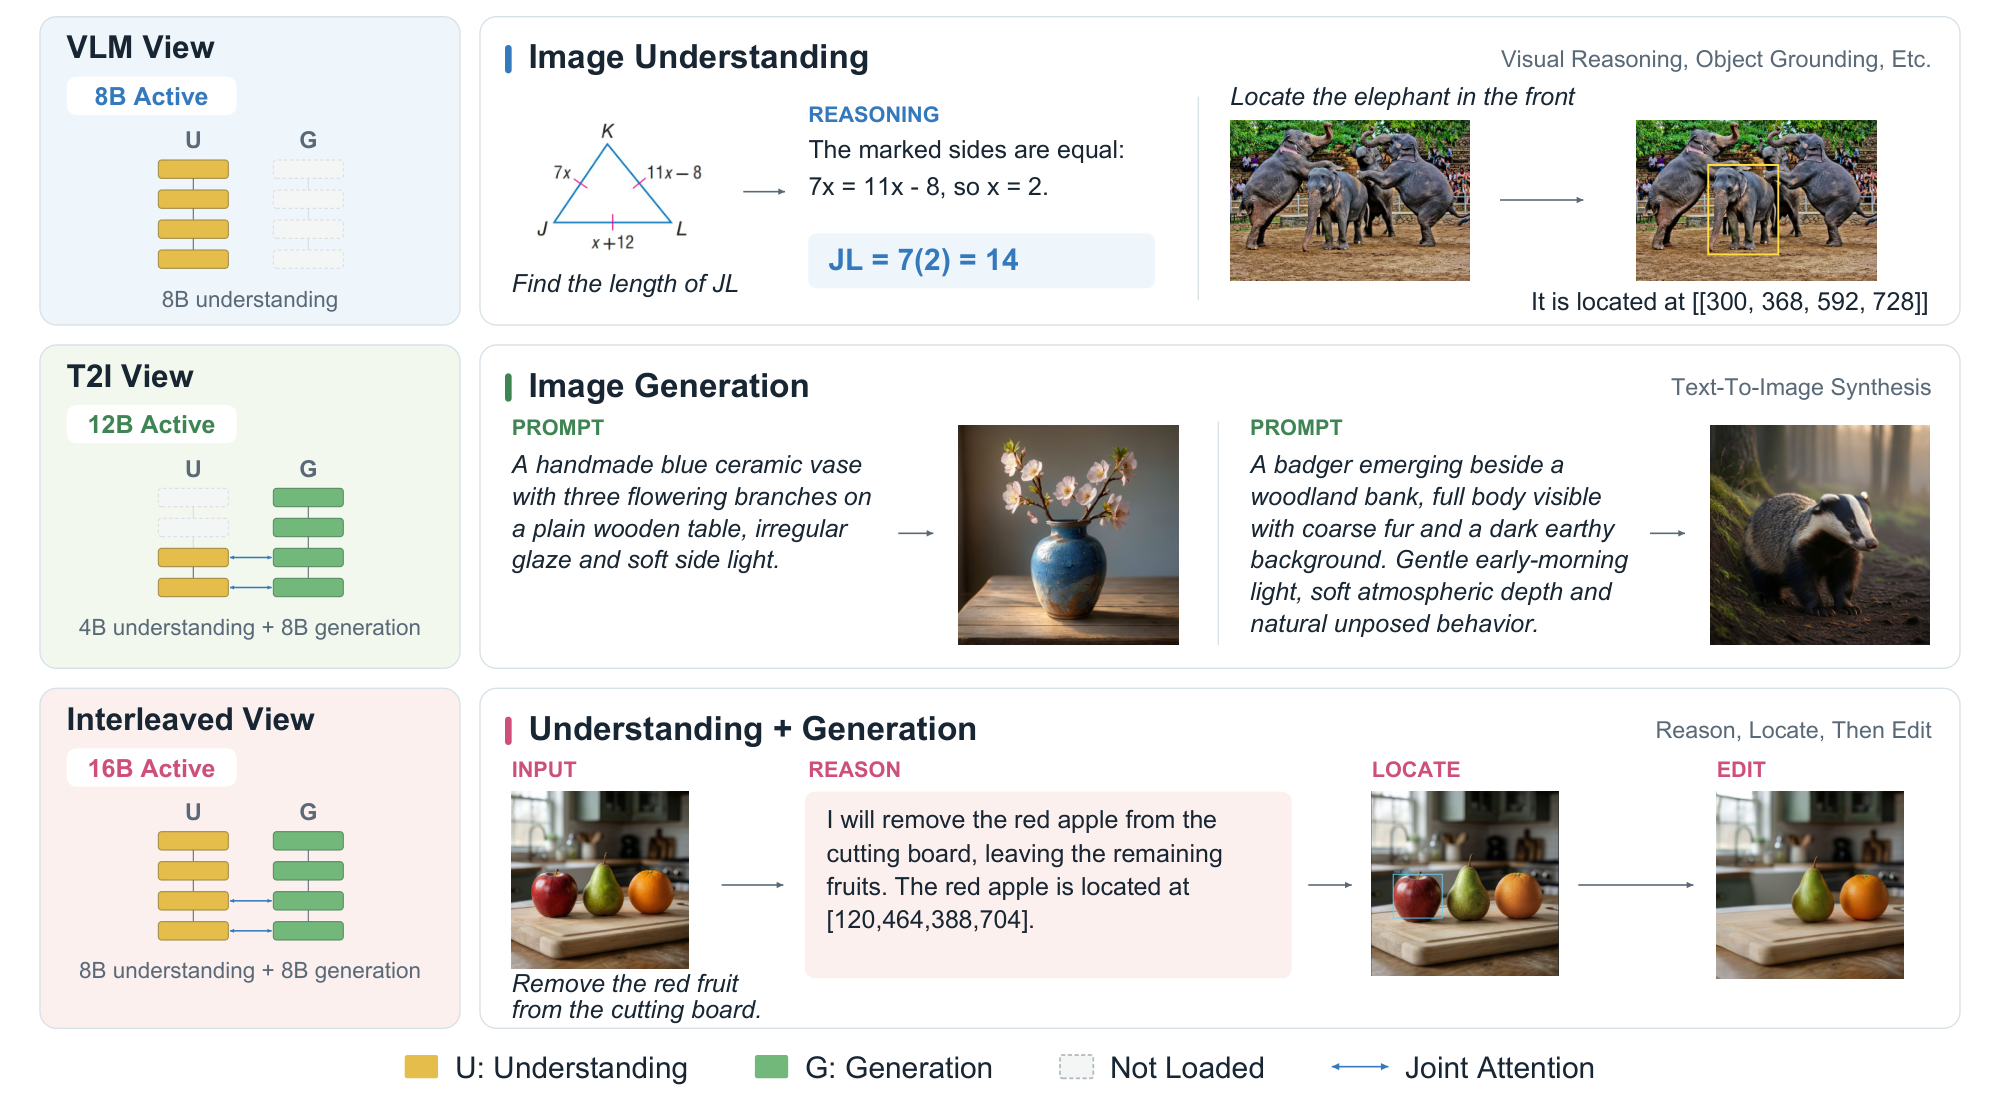
Figure 2 — Elastic-MoT 아키텍처 및 작업 예시
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] OvisOCR3 Technical Report
- [논문리뷰] Can Discrete Tokens Serve as Semantically Lossless Representations of Visual Signals?
- [논문리뷰] MultiAgent-OPD: End-to-End Training of Hierarchical Multi-Agent Systems with On-Policy Distillation
- [논문리뷰] MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
- [논문리뷰] Editing Images into Reusable Layers via Compositional Edit-Prior Distillation
Review 의 다른글
- 이전글 [논문리뷰] Multiscale Policy Optimization for Long-Horizon LLM Agents
- 현재글 : [논문리뷰] Nemotron-Labs-Diffusion-Uni: Elastic Self-Refining Unified Diffusion LLM with Cross-Paradigm On-Policy Distillation
- 다음글 [논문리뷰] Omni-InteractScope: Benchmarking Proactive and Agentic Interaction in Continuous Omnimodal Streams
댓글