[논문리뷰] HALO: Human-Grounded Granular Evaluation of Proactive Agents
링크: 논문 PDF로 바로 열기
메타데이터
저자: Wenqi Pei, Xinyu Wang, Jinrui Liu, Cynthia Zhuge, Jie Sheng, Zihan Wang, Tenghao Huang, Muhao Chen et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- Proactive Agents: 사용자의 명시적인 요청 없이도 관찰된 활동을 바탕으로 필요를 예측하고, 스스로 Assistance를 시작하는 AI 에이전트.
- HALO-Arena: Proactive Agent의 의사결정 과정을 평가하기 위해 구조화된 데이터베이스와 비정형 문서를 활용한 실행 가능한(executable) 벤치마크 환경.
- HALO-8K: 10개 모델로부터 수집된 8,000개의 응답을 전문가가 평가한 데이터셋으로, Action Level, Acceptability, 그리고 Timing/Intensity에 대한 상세한 Human Diagnosis를 포함.
- Action Levels: 에이전트가 수행하는 행위의 강도에 따른 분류로, L0 (Observation), L1 (Attention), L2 (Preparation), L3 (Execution)으로 구분됨.
- Over-proactivity: 에이전트가 지나치게 성급하게 개입(Premature timing)하거나, 너무 강도 높은 개입(Excessive intensity)을 수행하여 실패하는 현상.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Proactive Agent의 평가가 자동화된 점수나 이진 결과(Binary verdict)에 의존하여, 실제 인간 관점에서의 타당성과 구체적인 실패 원인 진단이 부족하다는 문제점을 해결하고자 한다. 기존의 Baseline 연구들은 주로 단순한 Task 수행 성공 여부에 집중할 뿐, 개입(Intervention)이 적절한 시점과 강도로 이루어졌는지, 혹은 자제(Restraint)가 필요한 상황에서 올바르게 멈췄는지를 정밀하게 분석하지 못한다 [Figure 1]. 이러한 한계는 에이전트가 사용자에게 유용한 도움을 주는 것인지, 아니면 불필요한 간섭을 하는 것인지에 대한 정성적 평가를 불가능하게 만든다. 따라서 저자들은 에이전트의 개입, 자제, 시점, 강도, 그리고 정보 습득 능력을 종합적으로 평가하기 위한 새로운 프레임워크를 제안한다.
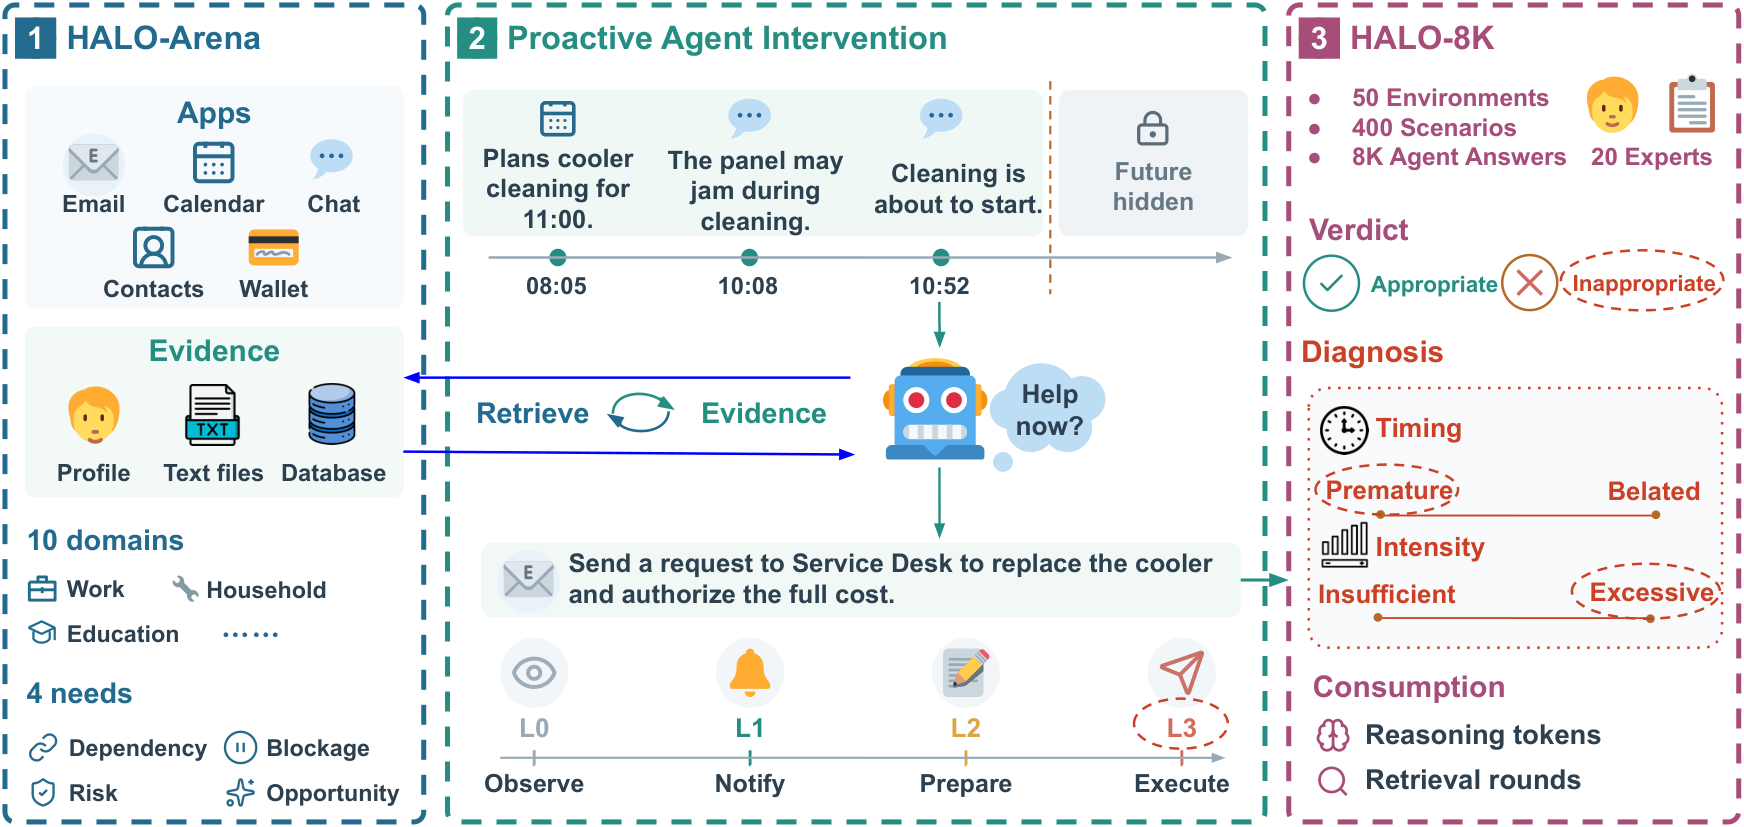
Figure 1 — HALO 에이전트 평가 프레임워크 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 Proactive Agent의 성능을 다각도로 진단하기 위해 HALO-Arena를 구축하고, 이를 통해 생성된 8,000개의 응답을 인간 전문가가 직접 분석한 HALO-8K 데이터셋을 제안한다 [Figure 1, Figure 2]. 제안하는 방법론은 에이전트가 특정 상황에서 증거(Evidence)를 검색하고, 이를 바탕으로 개입 여부와 수준을 결정하는 능력을 평가하는 데 초점을 맞춘다. 주요 실험 결과에 따르면, 가장 우수한 성능을 보인 Proprietary 모델은 72.88%의 Acceptability를 기록한 반면, Open-source 모델은 평균 47.55%의 수준에 머물러 큰 성능 격차를 보였다 [Table 1]. 특히, 에이전트의 실패 사례 중 61.20%가 Over-proactivity(성급하거나 과도한 개입)로 인한 것이라는 핵심 사실을 밝혀냈다 [Figure 3]. 또한, 정보 습득(Evidence acquisition) 과정이 동반될수록 Acceptability가 유의미하게 상승하며 Insufficient 진단 비율이 감소하는 정량적 상관관계를 확인하였다.
4. Conclusion & Impact (결론 및 시사점)
본 연구는 Proactive Agent가 단순한 Task 수행 능력을 넘어, 인간의 맥락과 허용 범위를 고려한 섬세한 의사결정을 수행해야 함을 강조한다. HALO 프레임워크를 통해 구축된 평가체계는 향후 에이전트 연구가 단순한 개입 빈도 증대가 아니라, 개입과 자제의 균형(Balance between intervention and restraint) 및 적절한 시점(Timing)과 강도(Intensity)를 최적화하는 방향으로 발전하도록 유도할 것이다. 본 논문은 산업계와 학계의 에이전트 모델들이 실사용 환경에서 더 신뢰할 수 있는 능동적 조력자로 거듭나기 위한 표준적인 평가 지표를 제시했다는 점에서 큰 의의가 있다.
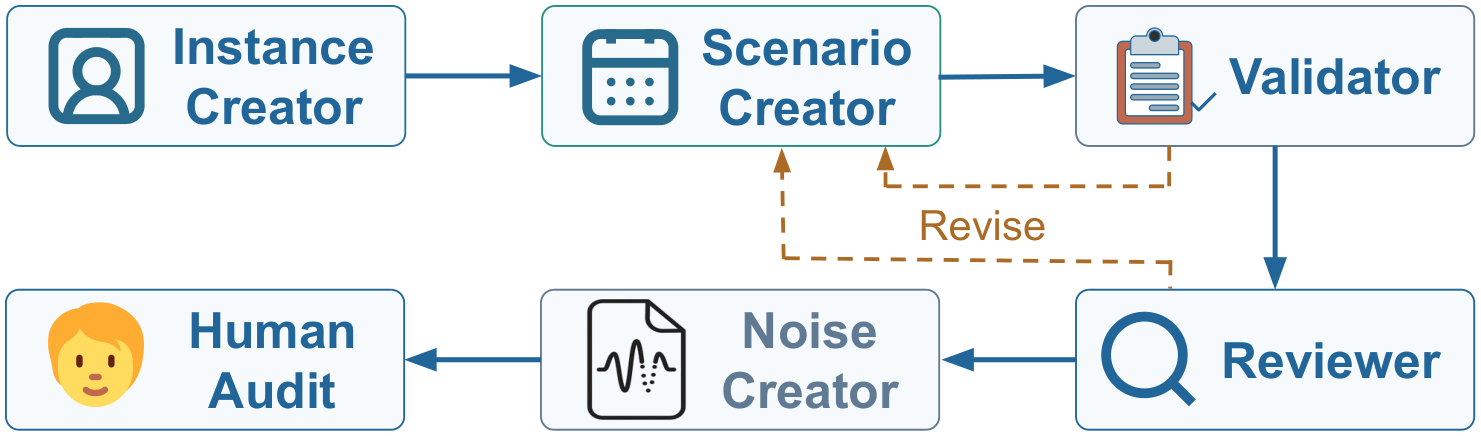
Figure 2 — HALO-Arena 데이터셋 구축 파이프라인
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Mycelium: A Meta-Study of Hallucination Detection Across Provenance, Typology, and Granularities
- [논문리뷰] Deep Search in Real-World Web Environments
- [논문리뷰] A Decade in a Day: Synthesizing Agent-Native Interfaces from Human-Oriented Software Evolution
- [논문리뷰] Foundations of Proactive Agents: Principles, Technical Layers, and Proactivity-Gym
- [논문리뷰] OmniSeek: Native Tool Integration for Multi-turn Audio-Visual Reasoning
Review 의 다른글
- 이전글 [논문리뷰] GLOW-FM: Efficient Generative Low-Light Image Enhancement with One-Step Latent Flow Matching
- 현재글 : [논문리뷰] HALO: Human-Grounded Granular Evaluation of Proactive Agents
- 다음글 [논문리뷰] HiFOR: Hierarchical Foresight with Action-Guided World Grounding for Vision-Language-Action Model
댓글