[논문리뷰] WorldBridge: Bridging Video and Action for Task Generalization in World Action Models
링크: 논문 PDF로 바로 열기
메타데이터
저자: Jun Cen, Yubo Guo, Hao Li, et al.
1. Key Terms & Definitions (핵심 용어 및 정의)
- World Action Models (WAMs): 시각적 예측과 행동 생성을 결합하여 로봇의 물리적 상호작용을 모델링하는 프레임워크입니다.
- Video-to-Action Bridge: 시각적 미래 예측을 로봇이 실행 가능한 구체적인 모터 행동으로 변환하는 역학 모델(Inverse Dynamics Model)의 역할을 수행합니다.
- Flow Matching: 시각적 데이터와 행동 데이터의 생성 과정을 최적화하기 위해 사용되는 확률적 생성 모델링 기법입니다.
- Mixture-of-Transformers (MoT): 비디오와 행동 전문가(Expert)를 분리하여 운영하면서 공동 주의(Joint Attention)를 통해 정보를 교환하는 아키텍처입니다.
- Action Forcing: 학습 과정에서 행동 토큰별로 독립적인 노이즈 레벨을 할당하여, 모델이 컨텍스트 비디오 정보에 더 강하게 의존하도록 유도하는 기법입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Embodied AI 모델이 훈련 범위를 벗어난 새로운 태스크로 확장할 때 발생하는 일반화 문제를 해결하고자 합니다. 기존 연구들은 시각적 예측에는 뛰어나지만, 이를 실제 물리적 행동으로 변환하는 과정에서의 연결성(bridge)이 부족하여 태스크 수행 능력이 저하되는 한계가 있습니다. 저자들은 비디오 데이터가 시각적 진화에 대한 풍부한 정보를 제공함에도 불구하고, 적절한 행동 라벨이 결합되지 않으면 태스크 전이가 제한됨을 확인했습니다 [Figure 2]. 따라서 비디오 데이터의 커버리지를 확장하고 sparse한 행동 데모를 효과적으로 활용하여 비디오-행동 간의 연결을 최적화하는 새로운 접근 방식이 필요합니다.
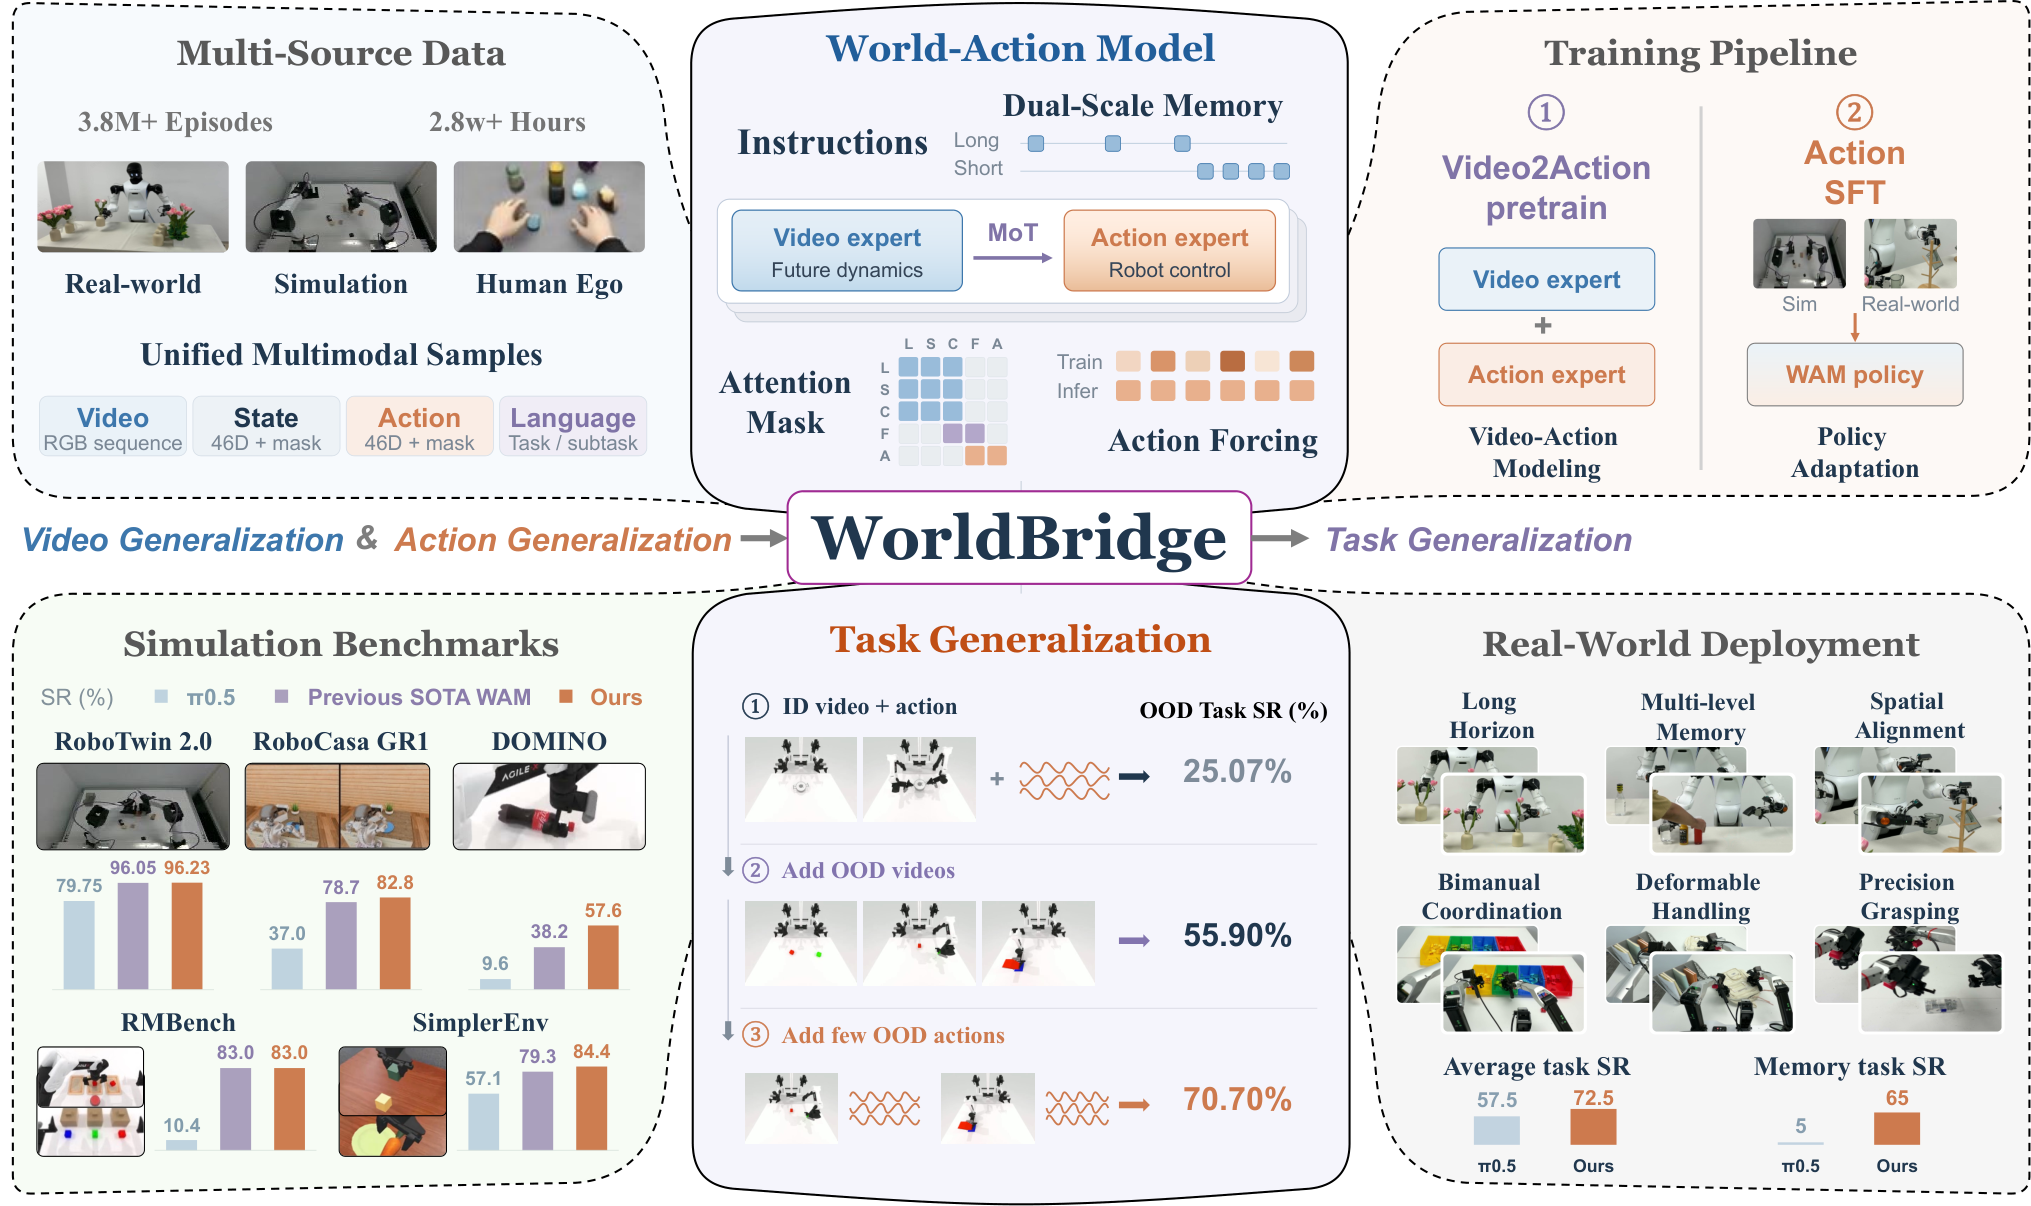
Figure 2 — 데이터 세팅별 태스크 일반화 성능 비교
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 시각적 dynamics와 행동 생성 경로를 결합한 WorldBridge 프레임워크를 제안합니다. WorldBridge는 비디오 전문가와 행동 전문가로 구성된 Mixture-of-Transformers 아키텍처를 채택하고, 시각적 기억을 위해 두 가지 시간적 척도의 메모리 시스템을 도입했습니다 [Figure 3]. 학습 단계에서는 비디오-행동의 독립적인 노이즈 샘플링과 Action Forcing을 통해 모델이 시각적 컨텍스트를 바탕으로 제어 능력을 내재화하도록 설계하였습니다. 또한, 로봇 데이터와 인간의 Ego-centric 데모를 통합하는 표준화된 데이터 파이프라인을 구축하여 Heterogeneous 데이터 활용성을 극대화했습니다 [Figure 5]. 실험 결과, WorldBridge는 RoboTwin 2.0 벤치마크에서 96.23%의 성공률을 달성하였으며, 특히 OOD(Out-of-Distribution) 태스크에서 비디오 데이터와 단 한 개의 행동 데모만으로도 성공률을 70.70%까지 크게 향상시키는 성과를 보였습니다 [Figure 2]. 이외에도 RoboCasa GR1 TableTop(82.8%) 및 DOMINO Level-1(57.6%) 등 다수의 벤치마크에서 State-of-the-Art 성능을 기록하며, 실제 로봇 플랫폼에서의 범용성을 입증했습니다.
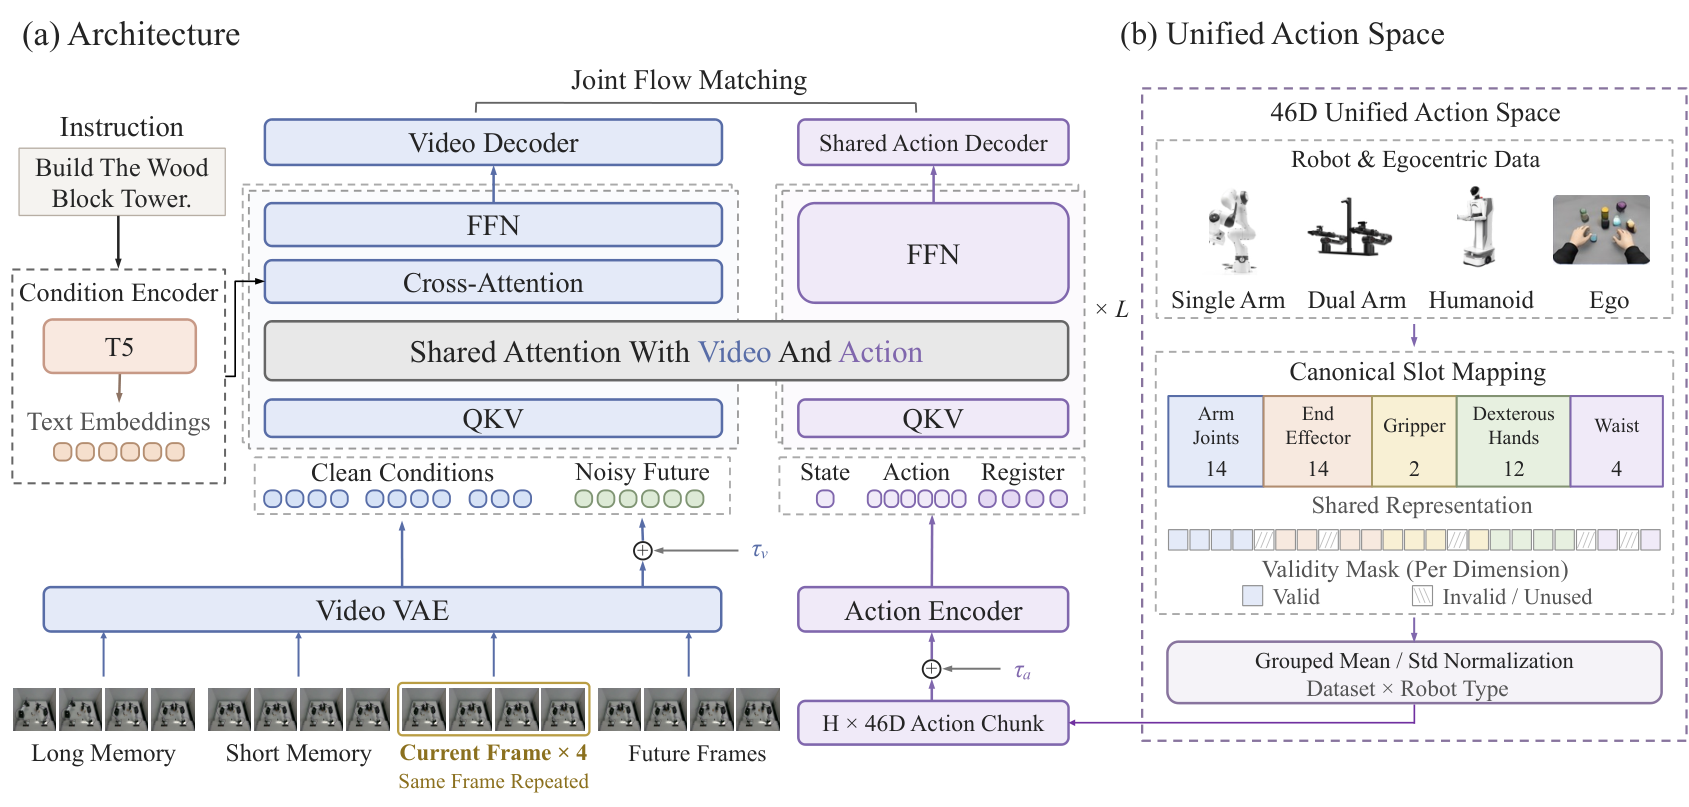
Figure 3 — WorldBridge 모델 아키텍처
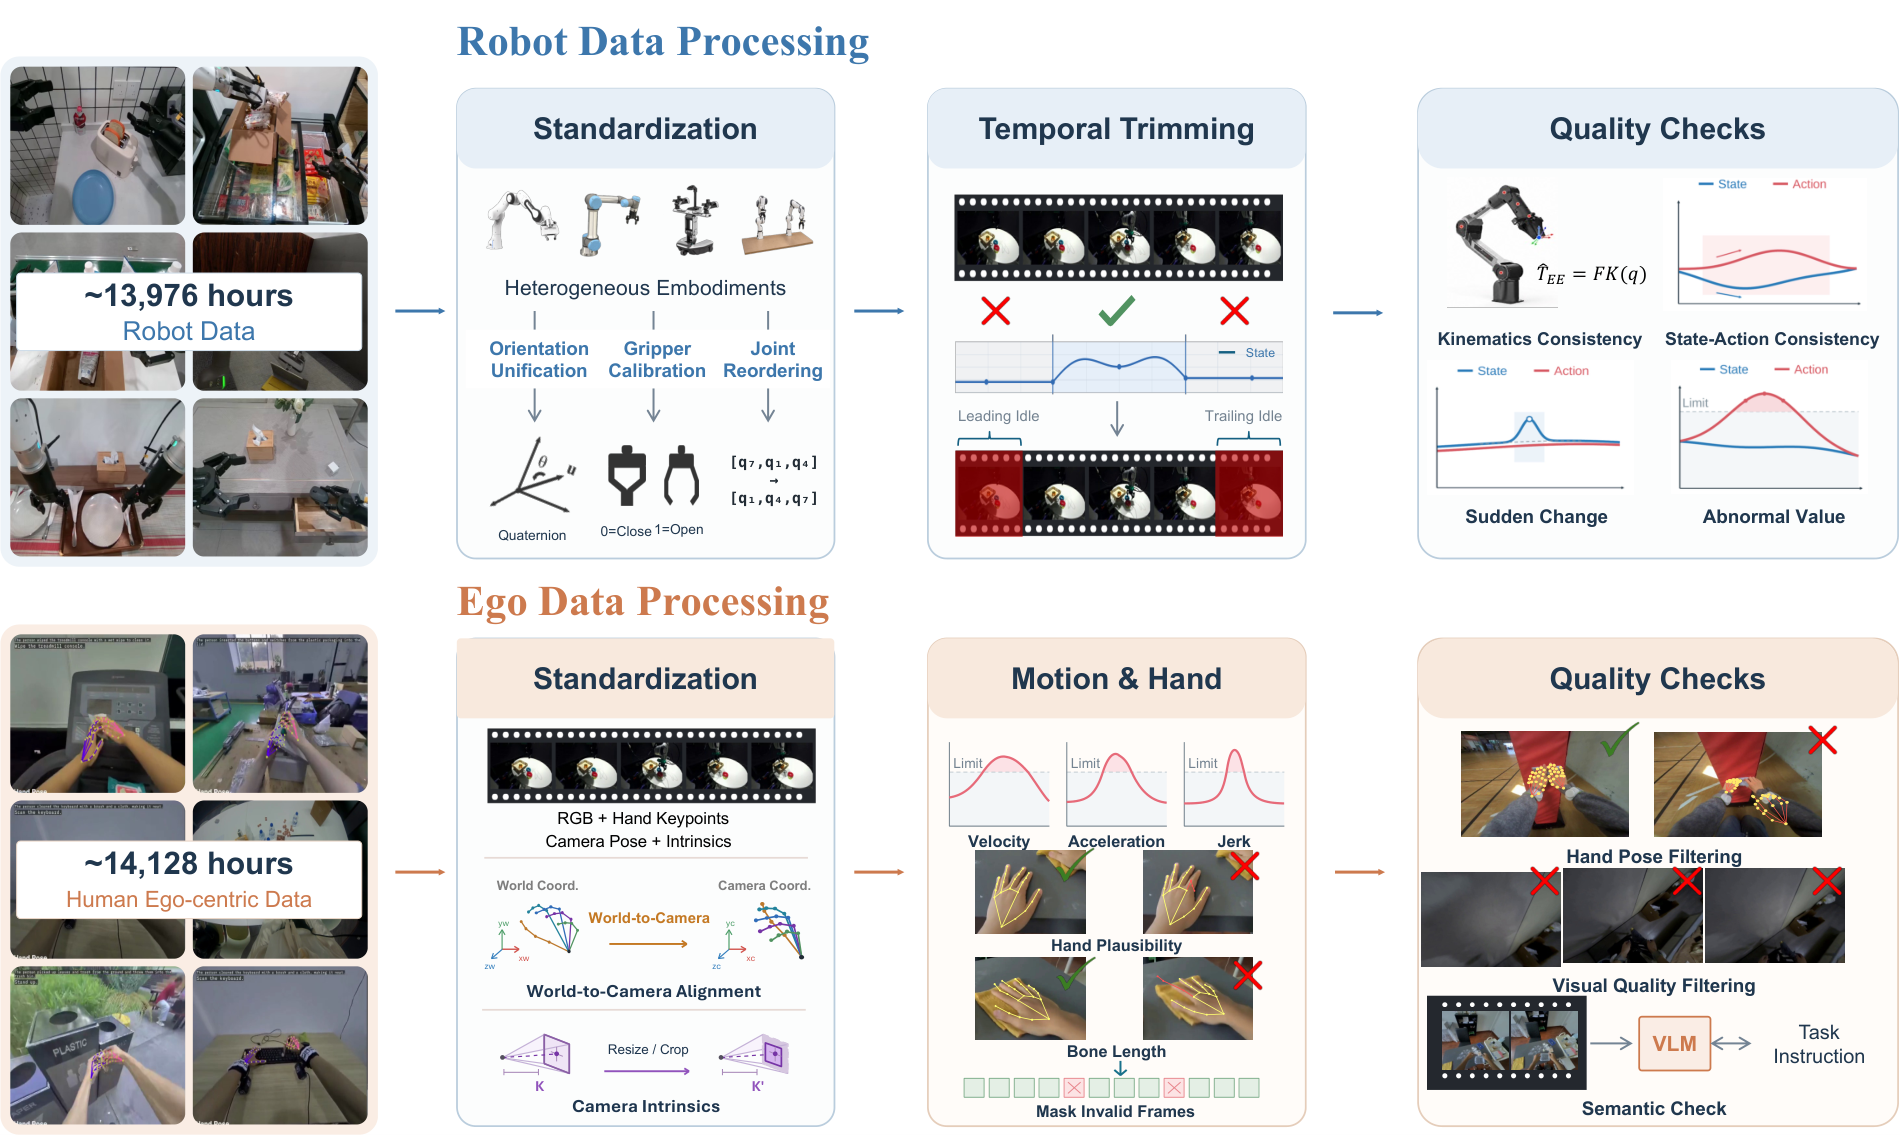
Figure 5 — 통합 데이터 처리 파이프라인
4. Conclusion & Impact (결론 및 시사점)
본 연구는 태스크 일반화의 핵심이 시각적 예측과 행동 제어 사이의 정교한 연결에 있음을 증명했습니다. 비디오 데이터의 확장이 잠재적 태스크 전이 범위를 넓히고, sparse한 행동 데모가 이를 구체적인 제어 지능으로 강화한다는 점을 정량적으로 규명했습니다. WorldBridge는 이 가설을 뒷받침하는 효율적인 구조를 제시하며, 다양한 로봇 플랫폼과 데이터 소스를 통합할 수 있는 강력한 프레임워크로 자리 잡았습니다. 이 연구는 향후 Embodied AI가 대규모 데이터로부터 학습하여 범용적인 로봇 에이전트로 진화하는 데 중요한 기술적 토대를 제공할 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Agentic World Action Models
- [논문리뷰] UniWAM: Unified World-Action Model
- [논문리뷰] Native Action-Prior Learning from Videos for World Action Models
- [논문리뷰] GigaWorld-Policy-0.5: A Faster and Stronger WAM Empowered by AutoResearch
- [논문리뷰] ImageWAM: Do World Action Models Really Need Video Generation, or Just Image Editing?
Review 의 다른글
- 이전글 [논문리뷰] Wizard: Manipulate Any World in Real Time via Agentic Control
- 현재글 : [논문리뷰] WorldBridge: Bridging Video and Action for Task Generalization in World Action Models
- 다음글 [논문리뷰] rTaste: Do Research Agents Have Taste? Evaluating Early Stage Research Judgment
댓글