[논문리뷰] Diagnosing the Reference Gap: What Visual Scaffolds Can and Cannot Fix in Multimodal Reasoning
링크: 논문 PDF로 바로 열기
메타데이터
저자: Guizhen Chen, Weiwen Xu, Wotao Yin, Anh Tuan Luu, Hou Pong Chan
1. Key Terms & Definitions (핵심 용어 및 정의)
- Reference Gap: MLLM이 시각적 정보를 인식하고 있음에도 불구하고, 추론 과정에서 언어와 시각적 객체(entities, regions, locations) 간의 안정적인 연결을 유지하지 못하는 현상입니다.
- Visual Routines: 시각적 추론을 수행하기 위해 필요한 일련의 기본 연산(예: marking, indexing, bounded activation, focus shifting)입니다.
- ReGap-Bench: 시각적 장면, 질문, 정답은 고정하고 시각적 참조(Reference) 조건만 변경하여 Reference Gap을 정량적으로 평가하기 위해 제안된 벤치마크입니다.
- Visual Scaffolds: 모델의 시각적 추론을 보조하기 위해 입력 이미지에 추가되는 구조적 요소(예: Numbering, Shading, Grid lines)입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 MLLM이 복잡한 다단계 시각 추론 문제에서 객체를 인식하고도 이를 추적하거나 구별하는 데 실패하는 근본 원인인 Reference Gap을 진단합니다 [Figure 1]. 기존 연구들은 주로 고해상도 인코더 등을 사용하여 '인식(Perception)' 능력 강화에 집중했으나, 저자들은 이 문제가 인식 단계가 아닌 언어와 시각적 요소 사이의 '참조 유지' 능력 부재에서 기인한다고 분석합니다. 따라서 시각적 참조를 외부화하는 것(Visual Scaffolds)이 추론 성능을 개선할 수 있는지 검증하고, 나아가 어떤 참조 체계가 어떤 시각적 연산에 유효한지를 체계적으로 파악하고자 합니다.
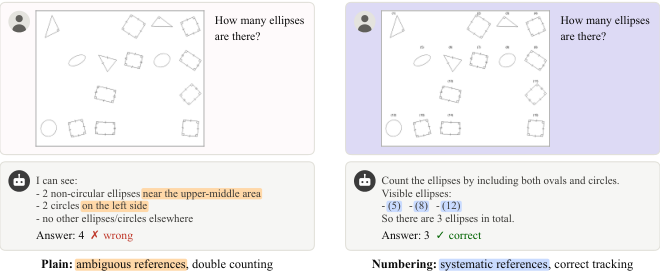
Figure 1 — Reference Gap 예시
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 시각적 루틴 이론에 기반하여 Numbering(indexing/marking), Shading(bounded activation), Grid lines(focus shifting/boundary tracing) 등 세 가지 유형의 Visual Scaffolds를 도입하고 이를 ReGap-Bench 내 5개 작업에 적용하여 평가합니다 [Figure 2]. 주요 실험 결과, 과업에 적합한(Task-matched) 참조 체계를 사용할 경우 정확도가 최대 25%까지 향상되는 성능 우위를 보였으며, 단순히 정보를 추가하는 것이 아니라 참조가 필요한 시각적 루틴과 일치할 때만 효과가 있음을 입증했습니다 [Figure 3, Figure 4, Figure 6]. 또한, 모델 크기를 2B에서 235B까지 확장해도 Reference Gap은 완전히 해소되지 않음을 확인했습니다 [Figure 8]. 마지막으로, 이러한 참조 체계를 inference 시점에 동적으로 선택 및 생성하는 Training-free Visual Skill을 제안하여 CartoMapQA 과제에서 성능 향상을 달성했습니다 [Table 2].
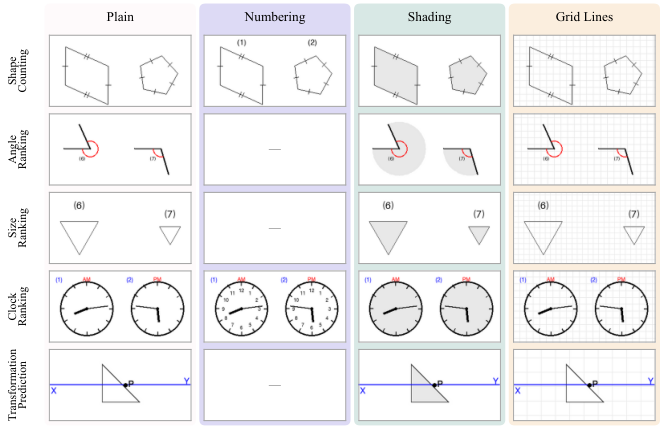
Figure 2 — ReGap-Bench 구성
4. Conclusion & Impact (결론 및 시사점)
본 논문은 Reference Gap이 다단계 멀티모달 추론의 명확한 병목 현상임을 규명하고, 시각적 루틴을 지원하는 참조 체계가 이를 해결할 수 있는 강력한 방법임을 제시합니다. 이 연구는 모델의 추가 학습 없이도 추론 성능을 개선할 수 있는 유연한 전략을 제안했다는 점에서 큰 의의가 있습니다. 본 연구의 결과는 향후 MLLM의 복잡한 시각적 과제 해결 능력을 강화하기 위한 새로운 설계 방향성을 제시하며, 특히 에이전트 환경에서 외부 시각적 도구를 활용하는 실질적인 기반 기술로 활용될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] On-Policy Self-Training: Data-Free Self-Improvement in Large Language Models
- [논문리뷰] MMVistaReason: Toward Open-Data and Post-Training Recipes for Multimodal Reasoning
- [논문리뷰] OpenTumorBoard: A Real-World Benchmark of Multidisciplinary Tumor Board Discussion Trajectories
- [논문리뷰] LoopVL: Recurrent Visual Intelligence
- [논문리뷰] SciGen-Verifier: A Multimodal Reasoner for Explainable Verification in Scientific Image Generation
Review 의 다른글
- 이전글 [논문리뷰] Democratizing Robot-Use Agents: A Unified Harness with Open Models
- 현재글 : [논문리뷰] Diagnosing the Reference Gap: What Visual Scaffolds Can and Cannot Fix in Multimodal Reasoning
- 다음글 [논문리뷰] FLAMIA: FLAsh MIcroscaling Attention for Fast and Causally Safe Training on Blackwell
댓글