[논문리뷰] SIMIT: Self-Improving Vision-Language Models via Imagination at Test-Time
링크: 논문 PDF로 바로 열기
메타데이터
저자: Mehmet Onurcan Kaya, Desmond Elliott, Dim P. Papadopoulos
1. Key Terms & Definitions (핵심 용어 및 정의)
- SIMIT (Self-Improving Vision-Language Models via Imagination at Test-Time): 정답(Ground-truth)이나 외부 모델 없이도 모델이 스스로 질문과 정답, 이미지를 합성하여 학습 데이터를 생성하고 자가 개선을 수행하는 프레임워크.
- UMM (Unified Multimodal Model): 이미지 이해와 생성 능력을 동시에 갖추어 데이터 합성부터 학습까지 스스로 수행하는 모델(논문에서는 BAGEL-7B를 활용).
- Visualization Routing: 모델이 생성할 이미지의 유형을 판단하여 Native Image Generation을 수행할지, 아니면 Structured Rendering Skills를 활용할지 결정하는 프로세스.
- Adaptive Budget Allocation (ABA): 테스트 쿼리에 대한 모델의 초기 자신감(Confidence)을 기반으로 합성할 샘플의 수($K$)를 동적으로 할당하는 메커니즘.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 Vision-Language Model(VLM)이 배포 후 직면하는 미지의 태스크나 도메인에 대응하기 위해, 외부 자원 없이 자체적으로 학습 데이터를 생성하여 개선하는 Test-Time Self-Improvement 문제를 해결하고자 합니다. 기존의 Test-Time Scaling 방식은 모델 파라미터를 업데이트하지 않아 재사용성이 낮고, 기존의 Test-Time Training 방법은 자기 모델의 예측이나 투표 결과에 의존하여 시스템적 오류를 강화(Reinforce)하는 한계가 있습니다 [Figure 1]. 저자들은 모델이 정답을 미리 알고 문제를 해결하는 대신, 쿼리와 관련된 합성 데이터를 '상상(Imagination)'하여 생성함으로써 이러한 오류 전파 없이 스스로를 개선할 수 있는 새로운 접근 방식을 제안합니다.
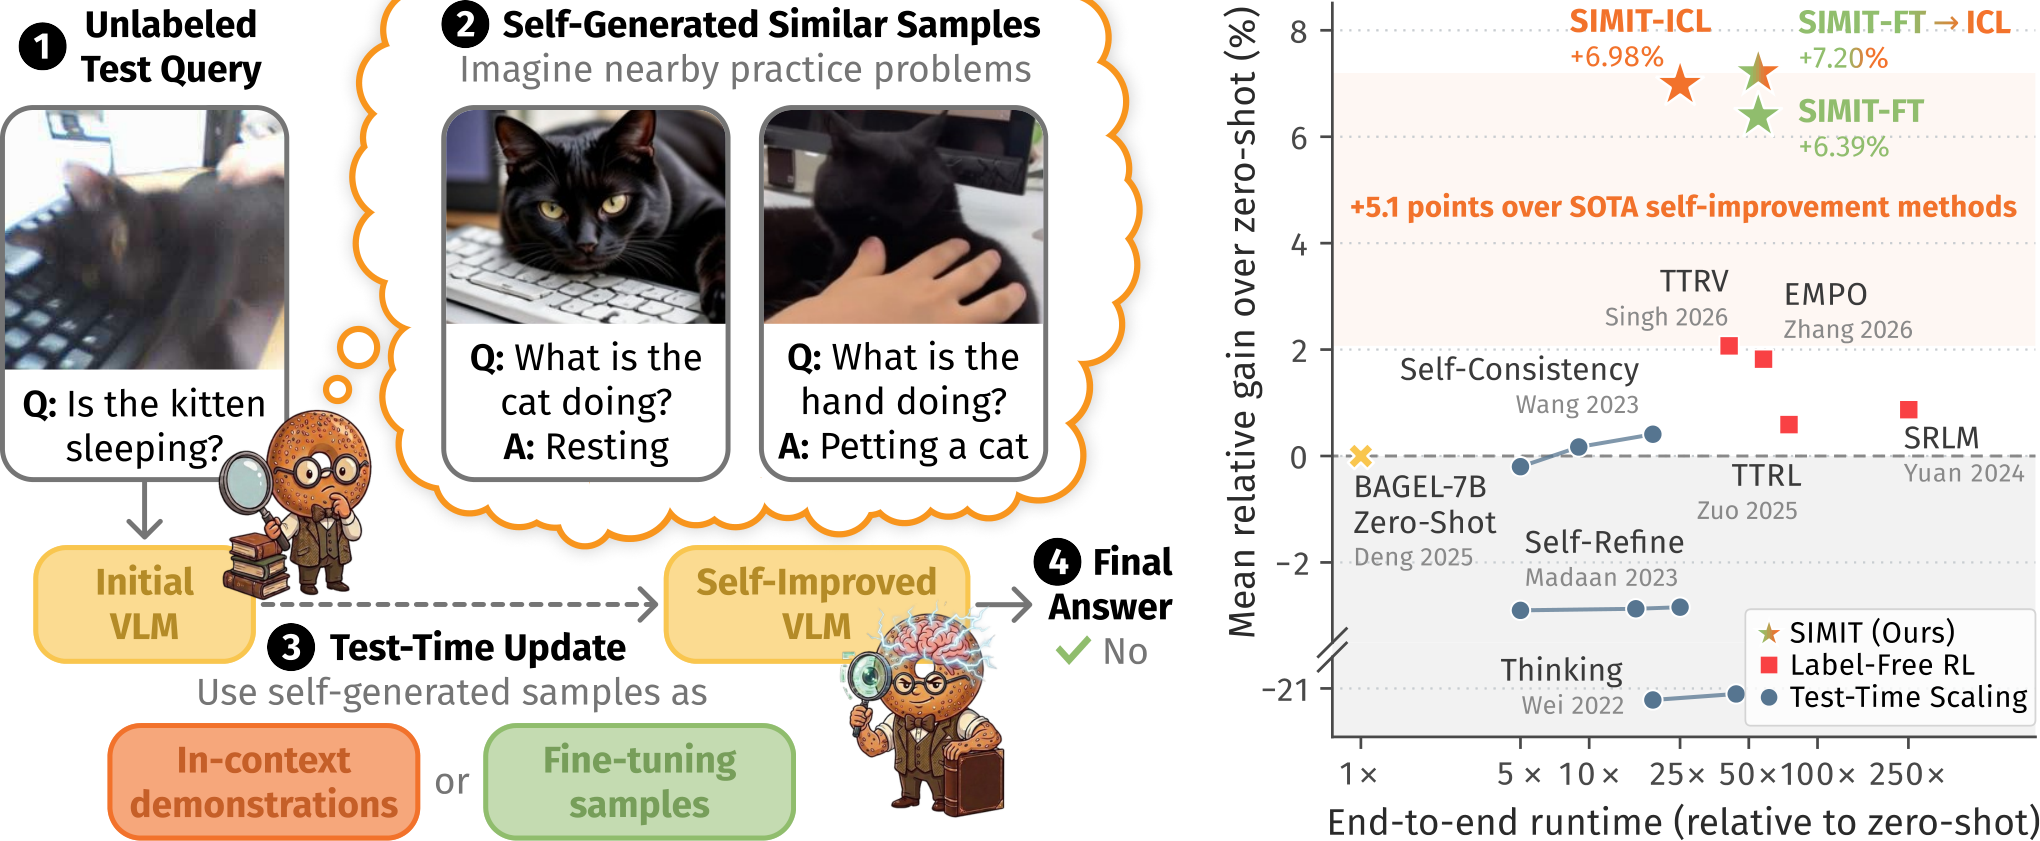
Figure 1 — SIMIT 전체 프레임워크 및 성능 향상 요약
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문은 모델이 스스로 생성한 Question-Answer-Image 삼중항을 활용하여 In-Context Learning(ICL) 또는 Fine-Tuning(FT)을 수행하는 파이프라인을 제안합니다 [Figure 2]. 우선 Adaptive Budget Allocation으로 샘플 생성 수를 결정하고, Triplet Synthesis를 통해 질문과 의도된 답변을 먼저 고정한 뒤 이를 뒷받침하는 이미지를 생성합니다. 특히 구조화된 시각 자료(차트, 다이어그램 등)를 위해 Skill Library를 도입하여 생성 품질을 높였으며, Verification과 Difficulty Filtering을 통해 고품질의 학습 데이터만을 선별합니다 [Figure 3]. 17개 멀티모달 벤치마크 실험 결과, SIMIT-FT→ICL 방식은 BAGEL-7B 기반 제로샷 베이스라인 대비 평균 +7.20%의 상대적 성능 향상을 기록하며 SOTA를 달성했습니다 [Table 1]. 또한, 기존 LFRL(Label-Free Reinforcement Learning) 기법들이 모델의 편향을 강화하는 것과 달리, SIMIT는 처음에 잘못 예측한 쿼리를 수정하는 능력이 월등히 뛰어나며, 합성된 데이터의 오류율 또한 베이스라인 대비 약 1/3 수준으로 낮습니다 [Figure 6, Figure 7].
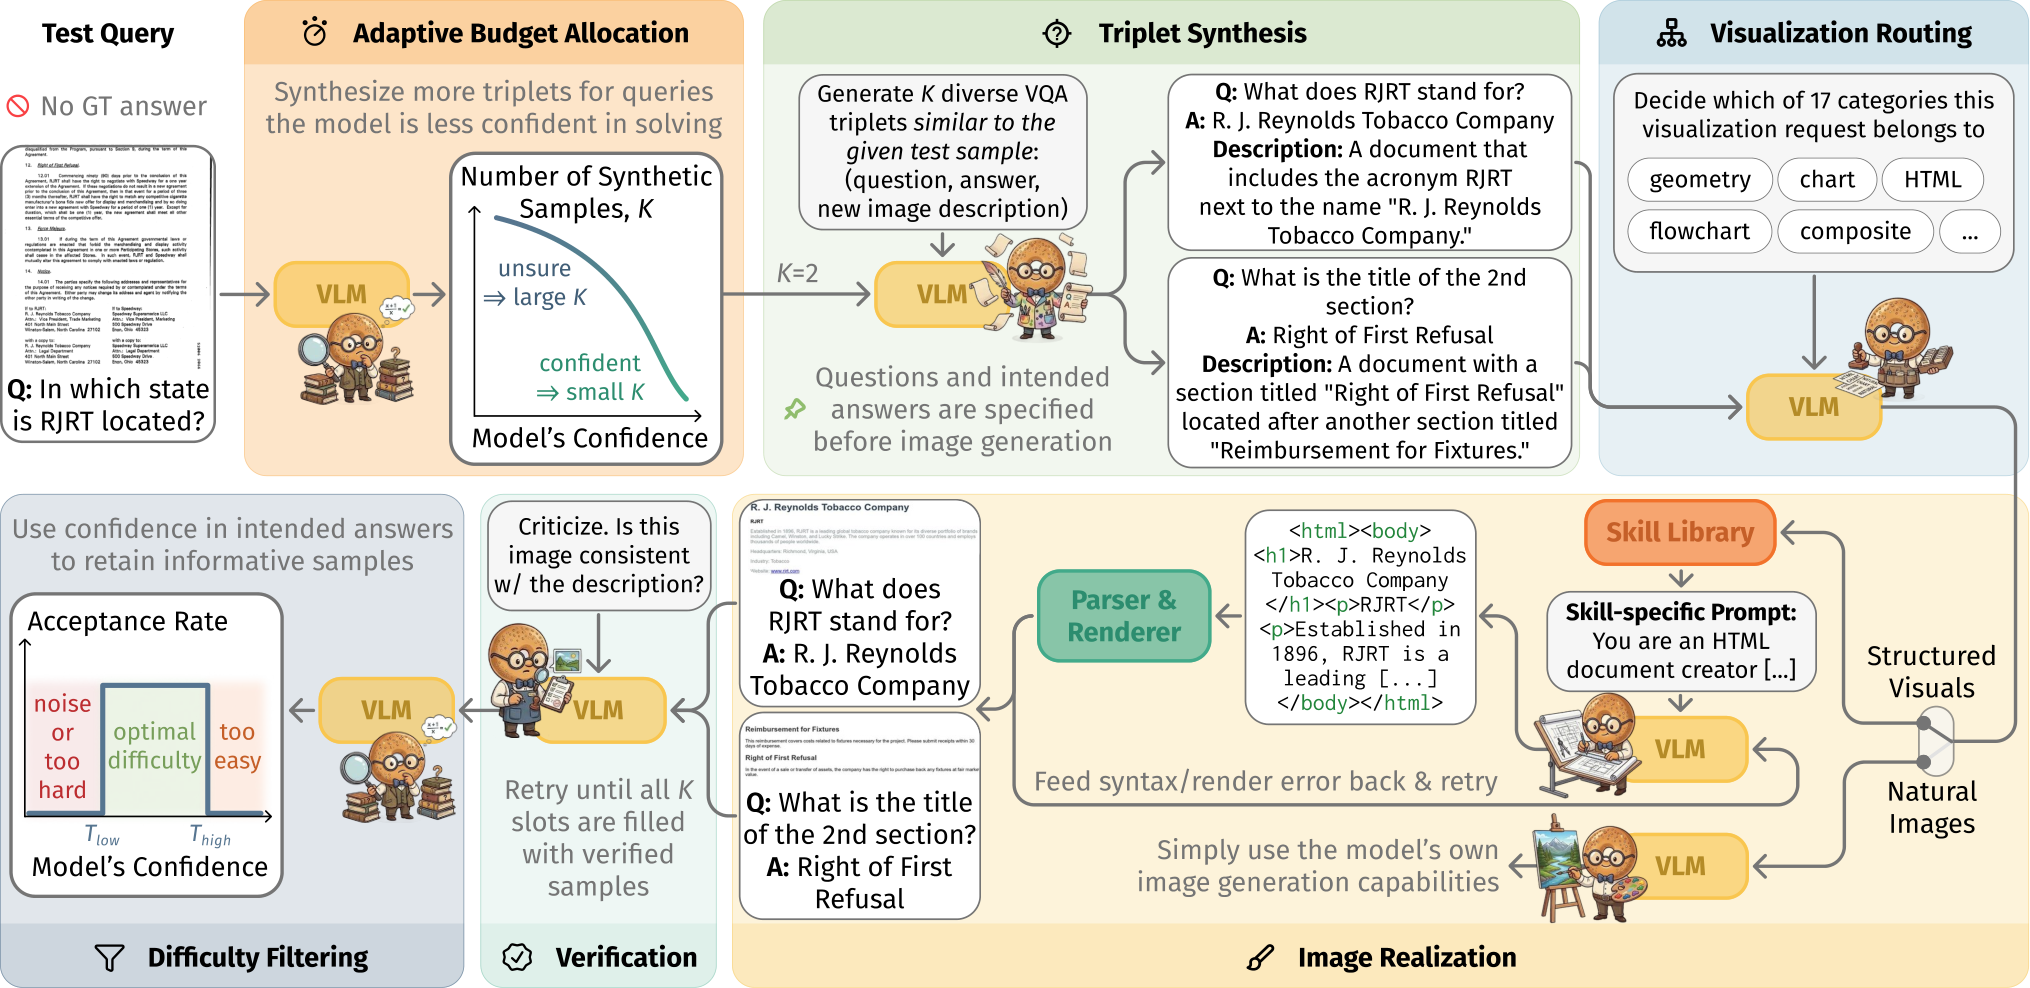
Figure 2 — SIMIT 데이터 합성 파이프라인
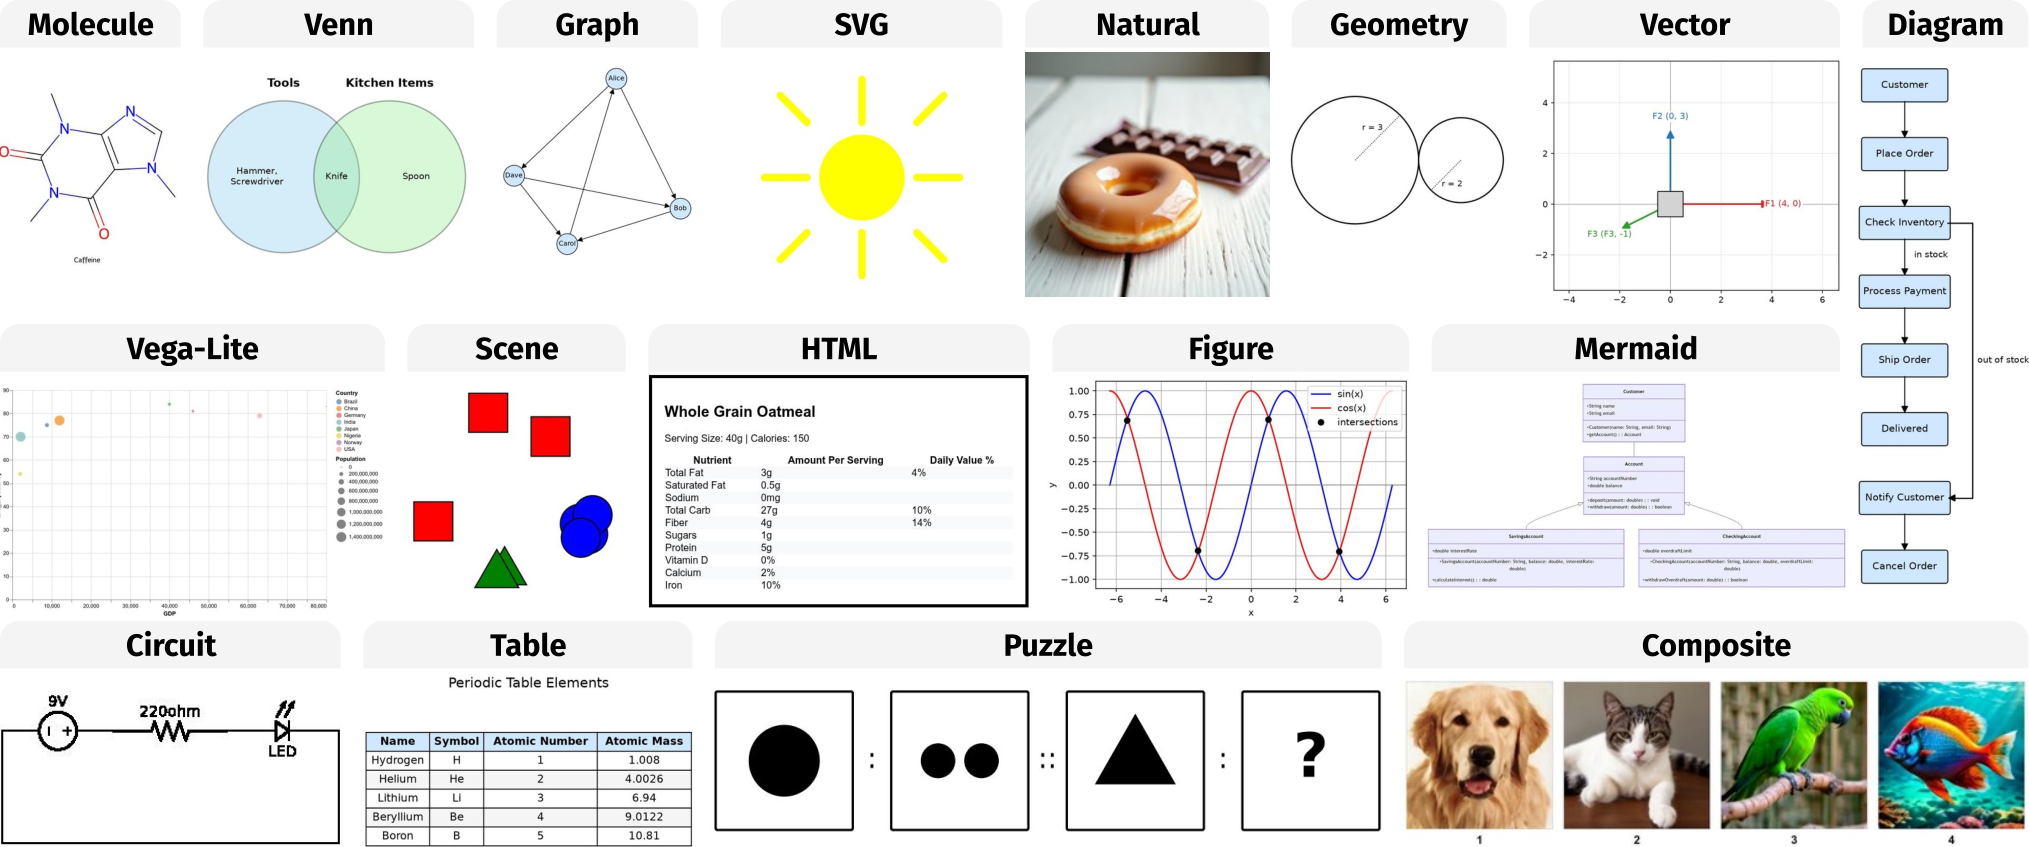
Figure 3 — SIMIT가 생성한 다양한 시각적 예시
4. Conclusion & Impact (결론 및 시사점)
본 논문은 VLM이 외부의 도움 없이도 자신의 상상력을 활용해 고품질의 합성 데이터를 직접 제작하고 학습함으로써 스스로 발전할 수 있음을 입증했습니다. 이 연구는 모델의 지식을 태스크별로 실시간 최적화할 수 있는 강력한 프레임워크를 제시하며, 데이터 부족 문제와 일반화의 한계를 극복하는 새로운 방향을 열었습니다. 향후 연구에서는 더 복잡한 시각적 구조를 처리하는 스킬 확장과 파라미터 업데이트 효율성 개선이 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] How Far Can Synthetic Data Take Thai OCR?
- [논문리뷰] Free Geometry: Refining 3D Reconstruction from Longer Versions of Itself
- [논문리뷰] MM-Zero: Self-Evolving Multi-Model Vision Language Models From Zero Data
- [논문리뷰] Test-Time Spectrum-Aware Latent Steering for Zero-Shot Generalization in Vision-Language Models
- [논문리뷰] Where Do Vision Language Models Fail at 3D Reasoning?
Review 의 다른글
- 이전글 [논문리뷰] Reviso: Not All Visual Evidence Deserves Equal Attention in Video Captioning
- 현재글 : [논문리뷰] SIMIT: Self-Improving Vision-Language Models via Imagination at Test-Time
- 다음글 [논문리뷰] SWE-Trail: History-Guided Trajectory Collection for Coding Agent Training
댓글