[논문리뷰] Mage-VL-Cowork: A Full Training Recipe to Learn Hybrid Computer Use From Evolved Harnesses
링크: 논문 PDF로 바로 열기
메타데이터
저자: Xiaoyi Zhang, Haoqing Wang, Xinjie Zhang, et al.
## 1. Key Terms & Definitions (핵심 용어 및 정의)
- Hybrid Computer-Use Agent (CUA): 시각적 GUI interaction과 코드/터미널 실행을 단일 정책 내에서 통합하여 수행하는 에이전트입니다.
- Mage-CUA-Forge: 재사용 가능한 생성 워크플로우를 활용하여 데스크탑/웹 태스크와 환경을 자동 합성하는 파이프라인입니다.
- Harness Evolution: teacher 모델의 도구 인터페이스, 프롬프트, 환경 설정을 최적화하여 더 고품질의 훈련 데이터를 생성하도록 하는 방법론입니다.
- Progressive Five-Stage Curriculum: Midtraining, SFT, RL을 포함하는 5단계의 점진적 학습 과정을 통해 성능을 극대화하는 훈련 전략입니다.
## 2. Motivation & Problem Statement (연구 배경 및 문제 정의) 본 논문은 기존의 Computer-use agents가 GUI 채널에만 과도하게 의존하여 발생하는 비효율성과 낮은 정확도 문제를 해결하고자 합니다. 기존의 방식은 스크린샷 내 요소 grounding에 수천 개의 토큰을 소모하며, 복잡한 작업을 처리할 때 터미널 도구 활용 능력이 부족하다는 한계가 있습니다. 특히 frontier 모델이라 하더라도 최적화되지 않은 harness 환경에서는 비효율적인 channel routing을 보여주어, 이를 distillation한 학생 모델의 성능 또한 제한됩니다 [Figure 1]. 따라서 저자들은 GUI와 터미널 채널을 모두 유연하게 활용하는 하이브리드 능력을 학습시킬 필요가 있다고 판단했습니다.
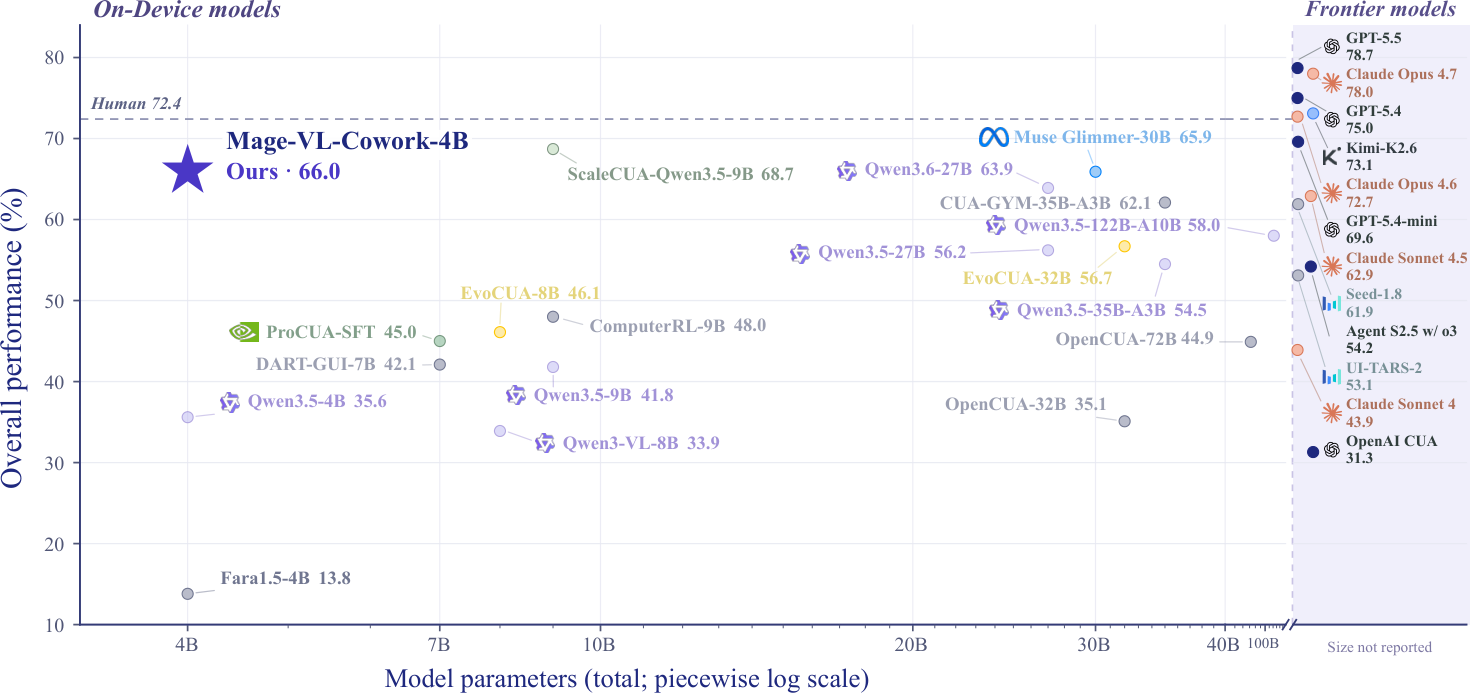
Figure 1 — 모델 크기별 성능 비교
## 3. Method & Key Results (제안 방법론 및 핵심 결과) 본 연구는 Mage-VL-Cowork를 제안하며, 4B 파라미터 모델임에도 OSWorld-Verified 벤치마크에서 66.0%의 점수를 달성하여 상위 모델들을 능가하는 성능을 보였습니다. 훈련 파이프라인은 5단계 커리큘럼(GUI-Oriented Midtraining, GUI Agent SFT, Coding & Terminal SFT, Hybrid CUA SFT, Online Hybrid RL)으로 구성되며, 단계별 훈련을 통해 성능을 20.44%p 점진적으로 개선하였습니다 [Table 1]. 또한, Mage-CUA-Forge를 도입하여 6,915개의 skill을 기반으로 293,806개의 태스크를 효율적으로 생성하였으며, 기존의 per-task 생성 방식 대비 반복 비용을 82.6% 절감했습니다. Harness evolution을 통해 최적화된 데이터로 훈련한 모델은 12.5%p의 추가적인 성능 향상을 보였으며, GUI와 터미널 행동을 상황에 맞게 최적으로 라우팅하는 능력을 성공적으로 습득했습니다 [Figure 2], [Figure 3].
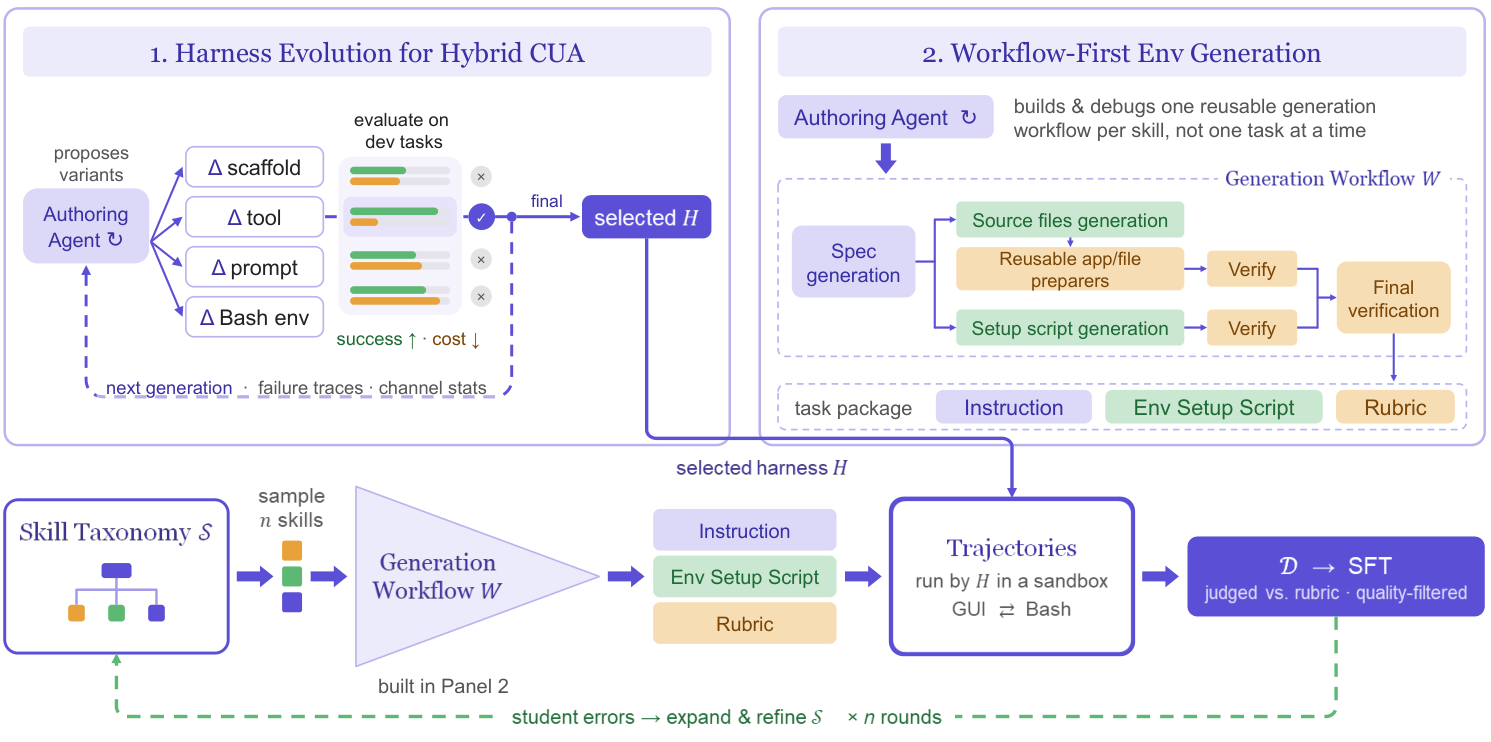
Figure 2 — 데이터 생성 파이프라인
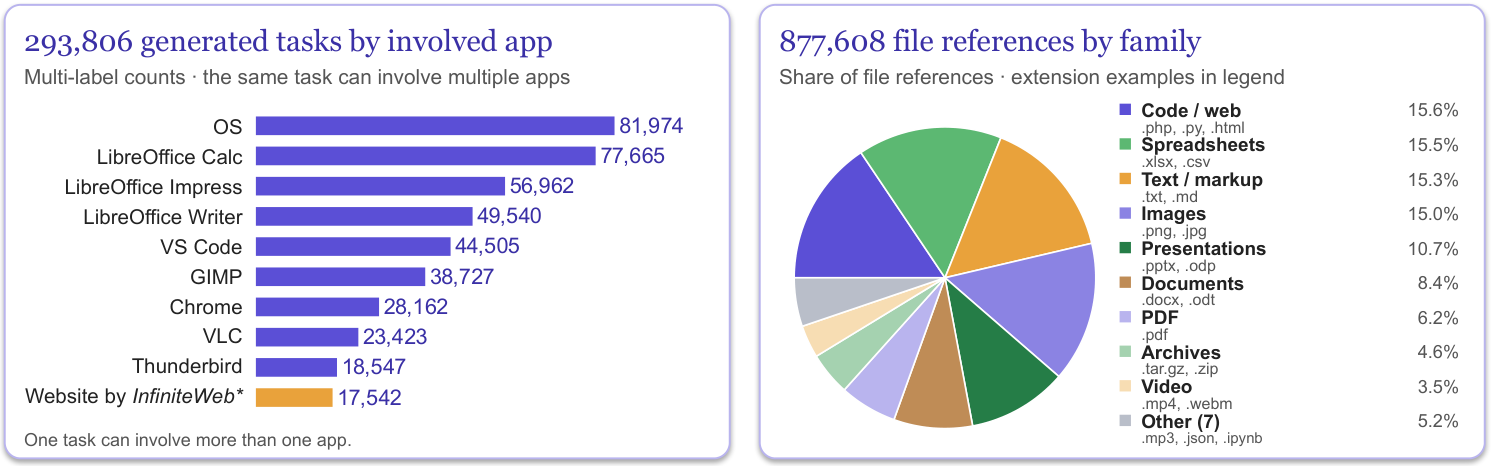
Figure 3 — 데이터셋 커버리지 통계
## 4. Conclusion & Impact (결론 및 시사점) 본 논문은 End-to-end 방식의 점진적 학습 커리큘럼과 고도로 최적화된 데이터 생성 워크플로우를 통해 소형 4B 모델로도 강력한 하이브리드 컴퓨터 사용 능력을 달성할 수 있음을 입증했습니다. 이 연구는 대규모 모델에 의존하던 기존의 컴퓨팅 에이전트 패러다임을 효율적인 on-device 지능으로 전환하는 중요한 계기가 될 것입니다. 또한, Harness evolution 기법은 향후 다양한 에이전트 시스템에서 고품질의 합성 데이터를 생성하는 핵심 방법론으로 활용될 것으로 기대됩니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] NorthCUA Technical Report: Turbocharging Computer-Use Agents through Experience at Scale
- [논문리뷰] Player-1: Learning to Play from Synthetic Experience
- [논문리뷰] GroundGUI: GUI Grounding by High-Quality Data and Distillation-to-Reinforcement Learning
- [논문리뷰] HybridCUA: Learning to Orchestrate GUI and CLI for Computer-Use Agents
- [논문리뷰] Echoverse: Deep, Evolving Environments for Training Computer-Use Agents at Scale
Review 의 다른글
- 이전글 [논문리뷰] LOLPlay: Benchmarking Real-Time Visual Agents in League of Legends
- 현재글 : [논문리뷰] Mage-VL-Cowork: A Full Training Recipe to Learn Hybrid Computer Use From Evolved Harnesses
- 다음글 [논문리뷰] MoLRSI: A Recursive Self-Improving AI agent for Molecular Discovery
댓글