[논문리뷰] Identically Trained Language Models Break on Different Jailbreaks
링크: 논문 PDF로 바로 열기
저자: Chi-Wei Chang, Mu-Tien Kuo, Kuan-Wei Lee, Meng-Hsun Tsai
1. Key Terms & Definitions (핵심 용어 및 정의)
- MZ twins: 같은 base model(동일 pretraining run)을 공유하고 post-training seed만 다른 두 모델의 쌍이다. 일란성(monozygotic) 쌍둥이에서 따온 명칭이다.
- Same-recipe pair / Cross-recipe pair: 같은 data recipe를 쓰되 pretraining seed가 다른 쌍을 same-recipe pair라 부른다. data recipe와 pretraining run이 모두 다른 쌍은 cross-recipe pair다.
- Vulnerability profile: 각 prompt에 대해 20개 sample 중 coherent sample의 non-refusal rate(WildGuard 판정)를 모아 만든, 모델별 per-prompt 취약성 벡터다.
- Corrected correlation: 두 모델 vulnerability profile 간 Pearson r을 Spearman's correction(r/√ρaρb)으로 sampling noise를 보정한 값이다. ρ는 odd/even sample split reliability에 Spearman–Brown step-up을 적용해 구한다.
- Ancestry gap: rMZ − rS로 정의되며, pretraining run을 공유하는 것이 추가로 기여하는 상관을 뜻한다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 하나의 checkpoint에서 측정한 jailbreak 취약성이 그 모델의 data와 safety training의 속성인지, 아니면 특정 pretraining run의 우연적 산물인지를 묻는다. 기존 jailbreak benchmark(HarmBench, JailbreakBench 등)와 red-teaming, refusal direction 연구는 단일 checkpoint만 평가하면서도, 그 결과를 pretraining data와 safety training의 속성처럼 해석해 왔다. 선행 연구는 fine-tuning seed, sampling seed, 또는 pretraining 마지막 1% 구간의 차이가 safety 행동을 바꾼다는 점은 보였다. 그러나 pretraining run 전체를 바꾸었을 때 같은 jailbreak에 무너지는지는 아무도 검증하지 않았다. 이 질문에 답하려면 동일 data recipe에서 여러 pretraining run이 필요하고 post-training도 통제해야 한다. 저자들은 이를 위해 DataDecide suite를 활용한 대규모 설계를 구성했다 [Figure 1].
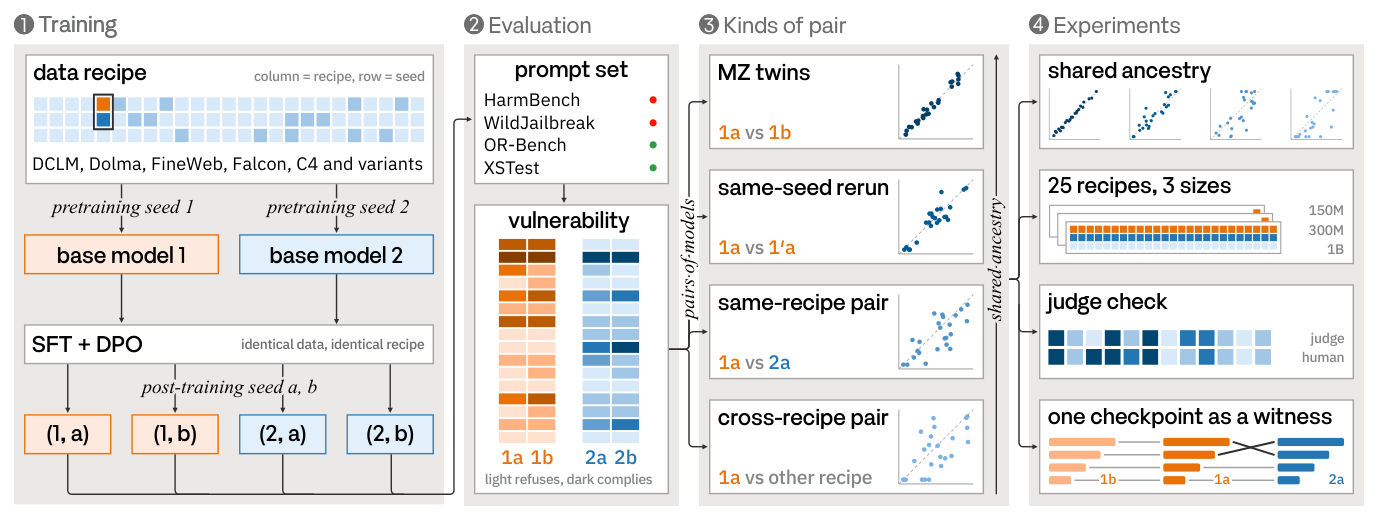
Figure 1 — MZ twins / same-recipe / cross-recipe pair 설계 전체를 보여주는 프레임워크 다이어그램
3. Method & Key Results (제안 방법론 및 핵심 결과)
실험 설계. 핵심 결과는 jailbreak 취약성이 data recipe보다 pretraining run에 훨씬 강하게 좌우된다는 것이다. 저자들은 DataDecide의 25개 data recipe × 3개 pretraining seed(1B)를 base model로 삼았다. 각 base model에 Tülu 3 SFT + DPO(OLMo 2 1B recipe)를 2개 post-training seed로 적용해 150개 모델을 만들었다. 평가에는 7개 공개 소스에서 decontamination을 거친 3,212개 adversarial-harmful prompt를 썼고, prompt마다 20개 응답을 생성해 WildGuard로 판정했다. 보조 judge로는 Qwen3Guard를 사용했다. 추가로 동일 seed로 pretraining을 두 번 재수행한 same-seed rerun과, initialization 또는 data order만 공유하는 partial rerun을 학습했다. 주요 예측은 사전 등록(pre-registration)했다.
주요 결과.
- 상관 구조: MZ twins의 corrected correlation은 0.984, same-recipe pair는 0.811, cross-recipe pair는 0.779였다. ancestry gap은 0.173 [0.167, 0.179]로, data recipe 효과(0.032)의 5.4배에 해당한다. 이 순서는 25개 recipe 모두에서 성립했다 [Figure 2]. 150M과 300M에서도 gap은 각각 0.204, 0.211로 유지되었다.
- 취약성 빈도(rate): prompt별 상관과 달리, 모델이 얼마나 자주 뚫리는지는 data recipe가 분산의 49%를 설명했다.
- Same-seed rerun: 같은 seed로 다시 학습한 모델은 원본과 0.844의 상관을 보여 same-recipe pair(0.814) 쪽에 훨씬 가까웠다. initialization만 또는 data order만 공유하는 경우에는 추가 상관이 탐지되지 않았다. 따라서 MZ twins의 일치는 seed가 아니라 한 번의 특정 학습 run(GPU nondeterminism 포함)을 공유한 데서 나온다.
- Human label 검증: 저자 라벨에서도 MZ − same-recipe 차이가 0.156 [0.036, 0.294]로 유지되어 judge artifact가 아님을 확인했다. 다만 WildGuard는 refusal을 과소 판정해 precision이 약 0.53–0.60이다.
- 실무적 함의: 한 checkpoint에서 최적이었던 attack template(91개 중)은 새 post-training seed에서는 67%, 새 pretraining seed에서는 27%만 최적 자리를 유지했다. data recipe를 모델 하나씩으로 비교하면 순위가 23.4% 뒤집혔다.
- Fingerprinting: vulnerability profile만으로 75개 run 중 자기 run을 75/75 식별했고, prompt 50개로도 98%를 식별했다. 반면 data recipe 식별률은 48%에 그쳤다 [Figure 3].
- Mechanistic 분석(Appendix): layer 13 last token에서 refusal-direction projection을 다른 run의 값으로 이식하면, MZ와 same-recipe 간 상관 격차의 약 49%가 메워졌다.
- 한계: SFT safety data를 다른 공개 data로 교체해도 ancestry gap(+0.178)은 유지되었다. 그러나 같은 run이라도 safety data를 바꾸면 상관이 0.558로 떨어졌으므로, 결론은 post-training이 고정된 조건으로 한정된다.
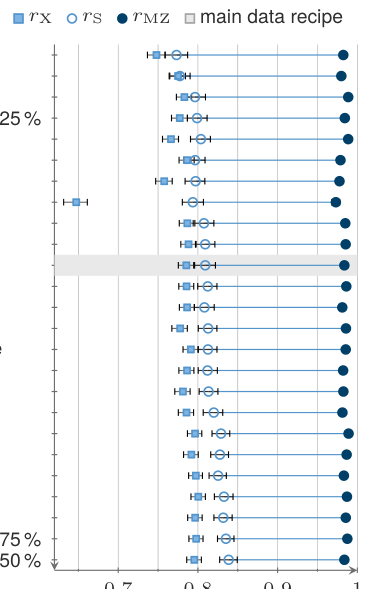
Figure 2 — 25개 recipe 전부에서 ancestry gap이 성립함을 보여주는 핵심 결과
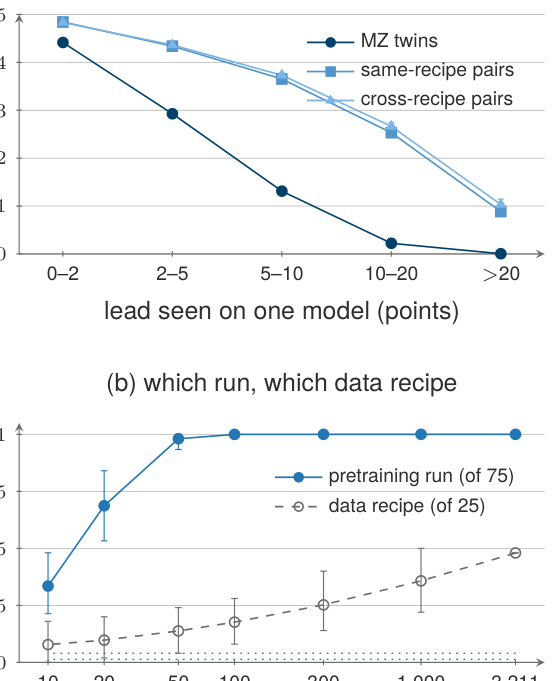
Figure 3 — attack ranking 불안정성과 fingerprint 식별 결과를 보여주는 실무적 시사점 그래프
4. Conclusion & Impact (결론 및 시사점)
같은 data와 같은 safety training으로 만든 모델이라도 pretraining run이 다르면 noticeably 다른 jailbreak에 무너진다. 단일 checkpoint에서 발견된 jailbreak는 data recipe보다는 그 특정 run에 대한 증거로 읽어야 한다. 이는 jailbreak benchmark와 red-teaming 결과를 일반화하는 관행에 직접적인 경고가 된다. 새 pretraining run은 별도의 red-teaming이 필요할 수 있고, data recipe 비교에는 최소 3개 base model(SE 약 2 point)을 쓰는 것이 바람직하다. 실험은 1B 이하 규모, DataDecide/Tülu 3 계열로 한정되지만, 공개된 코드·모델·per-prompt label은 더 큰 규모의 후속 검증을 가능하게 한다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Policy Is Not Capability: Some Safety Benchmarks Measure Which Definition of 'Unsafe' You Trained On
- [논문리뷰] When Does Combining Language Models Help? A Co-Failure Ceiling on Routing, Voting, and Mixture-of-Agents Across 67 Frontier Models
- [논문리뷰] Follow the Gradient: Tracing Safety Degradation Back to Training Data
- [논문리뷰] Targeted Neuron Modulation via Contrastive Pair Search
- [논문리뷰] Models That Know How Evaluations Are Designed Score Safer
Review 의 다른글
- 이전글 [논문리뷰] HeLM: Hierarchical Explicit Language Memory for Non-Markovian Manipulation
- 현재글 : [논문리뷰] Identically Trained Language Models Break on Different Jailbreaks
- 다음글 [논문리뷰] Information Games: Strategic Crowding and Firm Repositioning in Language-Model Space
댓글