[논문리뷰] How Many Exposures Does a World Model Need? Learning Unseen Game Mechanics at Test Time
링크: 논문 PDF로 바로 열기
저자: Ku Onoda, Haruto Kawano, Shota Takashiro, Kohei Hayashi (Third Intelligence, Inc. / The University of Tokyo)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Mechanic: 상태와 action에 대한 binary condition(c_m)과, 그 condition이 참일 때 대상 object에 일어나는 change(e_m)를 묶은 조건부 rule입니다. 예로는 tile 위에 올라간 piece의 회전이나 move마다 줄어드는 step counter가 있습니다. 게임의 transition function은 그 step에서 fire한 mechanic들의 효과를 합친 것으로 정의됩니다.
- Exposure: 특정 step 이전까지 해당 mechanic이 fire한 횟수(k)입니다. 모델과 무관하게 정해지므로 서로 다른 방법을 같은 exposure에서 비교할 수 있습니다.
- MechEval: ARC-AGI-3 게임 program에 직접 심은 annotator입니다. 20개 게임에서 69개 recurring mechanic의 fire 여부를 기록하고, 각 mechanic이 바꾸는 cell만으로 예측을 채점합니다(mechanic accuracy).
- EtC (Exposures to Criterion): learning curve가 그 이후의 모든 exposure에서 80% 이상을 유지하기 시작하는 첫 k입니다. 마지막 exposure에서도 80% 미만이면 n.r. (not reached)로 표시합니다.
- WARC (World model for ARC-AGI-3): VARC를 기반으로 만든 35M-parameter Vision Transformer입니다. 다른 게임으로 pretraining한 뒤, 새 게임에서는 transition 하나마다 next frame을 먼저 예측하고 이어서 전체 parameter를 update합니다(test-time training).
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문의 핵심 질문은 "world model이 처음 보는 환경의 mechanic을 예측하려면 exposure가 몇 번 필요한가"입니다. 저자들은 이 질문에 답할 측정 체계(MechEval)와 test bed(WARC)를 함께 제안합니다. DreamerV3 같은 기존 model-based agent는 환경 하나당 10⁴~10⁸ 번의 interaction으로 world model을 학습합니다. 반면 ARC-AGI-3처럼 처음 보는 게임에서는 적은 interaction만으로 rule을 익혀야 합니다.
저자들은 두 가지 gap을 지적합니다.
- 비교 protocol의 부재: in-context inference, gradient 기반 update 등 adaptation 방식이 다양한데, 이를 공통 조건에서 비교한 연구가 없습니다.
- 측정 지표의 부재: adaptation 자체를 따로 떼어 측정하는 방법이 없습니다. Agent의 return에는 model learning, exploration, planning이 뒤섞여 있습니다.
전체 frame 기준 accuracy도 지표로 쓰기 어렵습니다. 직전 frame을 그대로 복사하기만 해도 cell의 98.8%를 맞히기 때문입니다. 게임 단위 평균은 자주 등장하는 mechanic에 지배된다는 문제도 있습니다. 그래서 저자들은 mechanic별로, exposure별로, 바뀌는 cell만 채점하는 protocol을 설계했습니다 [Figure 1].
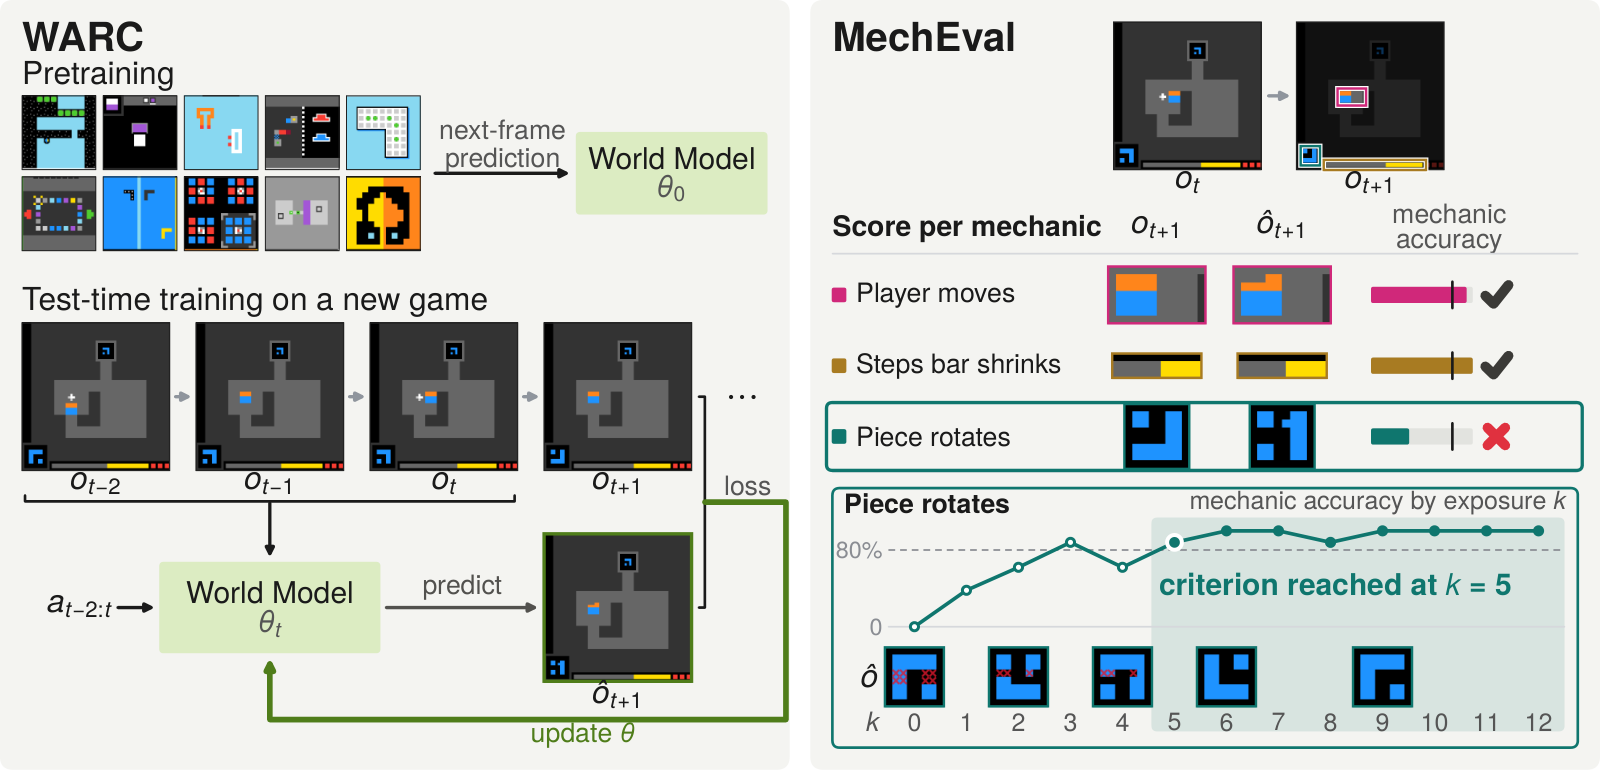
Figure 1 — WARC와 MechEval 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
WARC는 pretraining된 ViT가 매 transition 직후 gradient update를 하도록 만든 구조입니다. 이 단순한 설계만으로 held-out 게임에서 mechanic 5개 중 4개를 criterion에 도달시킵니다.
방법론
- 입력과 출력: 최근 h=3개 frame(64×64 grid, 16색)과 action을 받아, cell마다 16색에 대한 분포를 출력합니다. 학습 loss는 cell별 cross-entropy의 합(negative log-likelihood)입니다.
- Tokenization: 3개 frame을 2×2 cell × 3 frame 크기의 3D patch로 함께 patchify하고, action으로 모든 block을 conditioning합니다. 게임을 식별하는 task token은 없으므로, 새 게임에 대해 배운 내용은 모두 weight에 저장됩니다.
- Stream learning: transition마다 20번의 gradient step을 밟습니다. Minibatch(크기 8)는 최근 transition 10개, 무작위로 뽑은 과거 transition 20개(replay), 그리고 이들의 3가지 rotation augmentation에서 구성합니다. Optimizer는 pretraining 때와 같은 Muon + AdamW를 constant learning rate로 사용합니다.
- 평가 protocol: 모든 모델이 279개 human recording의 action을 똑같이 따라가며, update 직전에 예측한 결과로 채점됩니다. 덕분에 exploration과 분리된 순수한 dynamics learning을 측정할 수 있습니다.
- Agent 구성: closed-loop 실험에서는 고정된 graph explorer가 action 후보를 내고, WARC가 예측한 outcome의 novelty로 순위를 매깁니다. 이 조합이 WARC-Agent입니다.
핵심 결과
- Mechanic accuracy: 전체 exposure 기준 WARC는 69.1%입니다. WARC (frozen) 18.4%, Episodic retrieval 32.9%, WARC (scratch) 35.0%, DreamerV3 25.9%보다 높습니다.
- EtC와 n.r.: WARC의 median EtC는 74, n.r. 비율은 18.8%입니다. DreamerV3는 n.r. 90.8%, false-edit rate 3.07%로 부정확한 edit가 많았습니다.
- Generalization: 한 recording으로 adaptation한 뒤 같은 게임의 다른 recording을 update 없이 예측하게 했습니다. 이전에 보지 못한 상황(unseen)의 예측도 10~19 exposure 구간에서 key mechanic은 약 80%, click mechanic은 약 70%까지 올라갔습니다. 즉 단순 memorization이 아니라 rule을 학습하고 있습니다. 예를 들어 위쪽 이동을 한 번 본 뒤 첫 왼쪽 이동을 맞혔습니다 [Figure 4].
- 부작용: 이동 rule을 익힌 뒤에는 벽에 막힌 이동도 통과하는 것으로 예측하는 경향이 있습니다. 처음 막힌 이동에서 바뀌지 말아야 할 cell을 유지한 비율이 58%로, frozen 모델의 89%보다 낮았습니다.
- Ablation:
- Pretraining을 빼면 전체 accuracy가 −34.1pt 떨어집니다.
- 5 transition마다 update하면 첫 4 exposure 구간에서 −10.5pt 떨어집니다.
- LoRA (rank 64)는 full update와 거의 같은 성능을 냈습니다(−1.4pt).
- 반면 modulation layer만 update하면 −9.4pt로 부족했습니다.
- Recurrent state(WARC (GRU))는 update 없이 mechanic의 16%만 criterion에 도달시켜, gradient update를 대체하지 못했습니다.
- Pretraining scaling: 게임 수를 늘리면 exact-frame error가 꾸준히 줄었지만, 게임당 recording 수는 2개를 넘으면 효과가 작았습니다.
- Closed-loop: 25개 public 게임에서 WARC-Agent는 RHAE를 0.149 → 0.455로 약 3배 높였습니다. Graph + WARC (frozen)는 0.181에 그쳤고, level 1 clear 비율은 34.4% → 46.0%로 올랐습니다. 실제 play에서도 explorer가 반응하는 tile과 아직 방문하지 않은 maze 영역으로 이동하는 모습이 확인됩니다 [Figure 6].
- 기타: Oracle world model을 쓰면 RHAE가 1.392까지 올라가므로 world model이 개선될 여지가 아직 큽니다. Kaggle hidden-game leaderboard 점수는 0.20이었습니다.
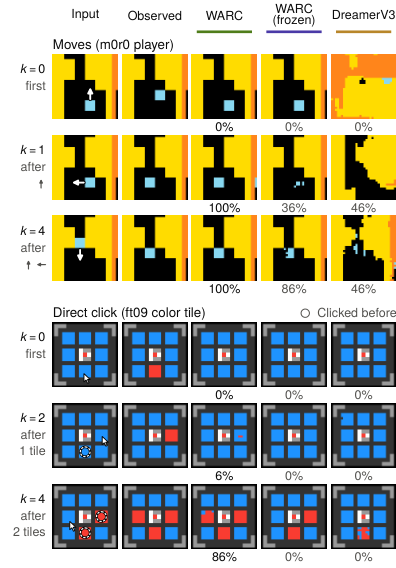
Figure 4 — 새 상황 일반화 예시
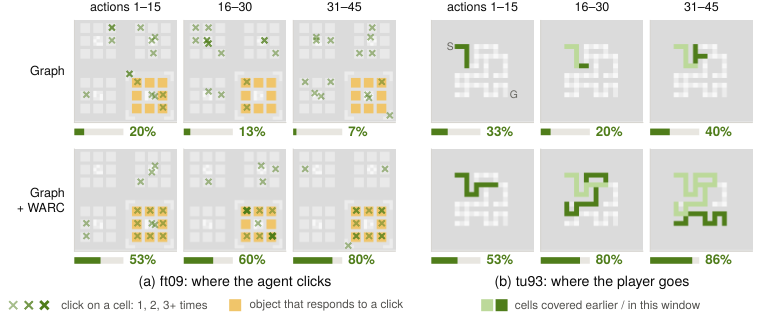
Figure 6 — Explorer 행동 비교
4. Conclusion & Impact (결론 및 시사점)
이 연구의 결론은, 다른 게임으로 pretraining하고 transition마다 gradient update를 하면 world model이 단 한 번의 play 안에서 새 mechanic의 대부분을 학습한다는 것입니다. Criterion에 도달한 mechanic 중 절반은 약 80 exposure 이내에 도달했습니다. 기존 world model이 쓰는 10⁴~10⁸의 interaction보다 훨씬 적은 양입니다.
학습 속도를 결정한 요소는 다음 두 가지였습니다.
- 다양한 게임으로 한 pretraining
- per-transition gradient update
현재 pretraining 규모에서는 recurrent state를 이용한 in-context adaptation이 이를 대체하지 못했습니다.
학계 관점에서 MechEval은 다음과 같은 의미가 있습니다.
- agent return 대신 "어떤 mechanic을 몇 번의 exposure 만에 학습하는가"를 측정하는 새로운 evaluation 축입니다.
- next frame을 예측하는 모델이라면 무엇이든 채점할 수 있습니다. LLM agent가 작성한 simulator program도 포함됩니다.
- robotics simulator처럼 mechanic의 fire 여부를 logging할 수 있는 환경이라면 확장할 수 있습니다.
다만 한계도 있습니다.
- 결과는 deterministic하고 discrete한 64×64 grid 게임에서만 검증되었습니다. Continuous하거나 stochastic한 dynamics에서도 통하는지는 확인되지 않았습니다.
- 게임의 goal은 모델링하지 않았습니다.
- 더 높은 점수를 얻으려면 더 빨리 학습하는 world model과 함께, 각 게임의 goal을 겨냥하는 action selector가 필요하다고 저자들은 결론짓습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] Horizon-Scalable Q-Learning
- 현재글 : [논문리뷰] How Many Exposures Does a World Model Need? Learning Unseen Game Mechanics at Test Time
- 다음글 [논문리뷰] How Much Training-Inference Mismatch Can On-Policy Distillation Tolerate?
댓글