[논문리뷰] SWAM: Scaling World Action Models with Cross-Modal Alignment
링크: 논문 PDF로 바로 열기
저자: Yu Zhou, Xinyuan Xia, Xuankun Yang, Yinghao Yang, et al. (Shanghai Jiao Tong University, Shanghai Innovation Institute, Noematrix Ltd. 등; 교신저자 Yanwei Li)
1. Key Terms & Definitions (핵심 용어 및 정의)
- WAM (World Action Model): language를 condition으로 받아 미래 video와 action을 함께 예측하는 모델입니다. 이 논문의 WAM은 pretrained video model(Wan2.2-TI2V-5B)을 기반으로 만들어졌으며, video prediction과 action prediction을 같은 시간 구간에서 함께 학습합니다.
- Language–Video / Language–Video–Action Alignment: 앞의 것은 video pretraining 단계에서 얻은 language description과 visual dynamics 사이의 대응 관계입니다. 뒤의 것은 여기에 action supervision을 더해 manipulation 과정과 실제로 실행된 action을 연결한 대응 관계입니다.
- UMI Demonstrations: handheld gripper(RoboPocket)로 사람이 직접 물체를 조작하며 수집한 데이터입니다. video와 action trajectory가 함께 기록됩니다. 저자들은 in-house로 411,754개 trajectory, 15,284.9시간을 수집했습니다.
- MoT (Mixture-of-Transformers) 기반 Dual-stream 구조: video DiT branch와 action DiT branch가 residual stream을 따로 유지하고, shared masked attention으로 연결되는 구조입니다. 정보는 video에서 action 방향으로만 흐릅니다. text cross-attention은 video branch에만 있습니다.
- Easy (C2C) / Hard (C2R): 평가 설정입니다. 모델은 Clean demonstration으로만 post-training됩니다. Easy는 같은 Clean 조건에서, Hard는 background·lighting·clutter·table height·camera 위치를 무작위로 바꾼 Randomized 조건에서 평가합니다. Hard 설정으로 control generalization을 측정합니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문이 다루는 문제는 action learning을 도입할 때 video pretraining으로 얻은 language–video alignment가 손상될 수 있다는 점입니다. 이 alignment를 유지하면서 action까지 확장하려면 data와 supervision을 어떻게 설계해야 하는지에 대한 체계적인 지침이 부족합니다. 기존 WAM 연구(UniPi, VPP, Motus, DreamZero, LingBot-VA, Fast-WAM 등)는 주로 architecture와 training mechanism에 집중했습니다. 또한 video pretraining으로 얻은 language–video alignment를 이미 확보된 기반으로 간주해 왔습니다. 그 결과 general video, egocentric video, UMI, robot data 같은 서로 다른 경험과 supervision 형태가 control generalization에 각각 어떤 역할을 하는지 불분명했습니다. 오픈소스 robot dataset에도 문제가 있습니다. 많은 trajectory가 같은 단순 task instruction을 공유합니다. 예를 들어 저자들이 살펴본 145,430개 trajectory에는 instruction이 592개뿐이었습니다. 이 때문에 trajectory 수준의 세밀한 language supervision이 부족했습니다. 저자들은 이 질문들을 체계적으로 검증하기 위해 약 47,000시간 규모의 multisource data pool을 구축했습니다 [Figure 2].
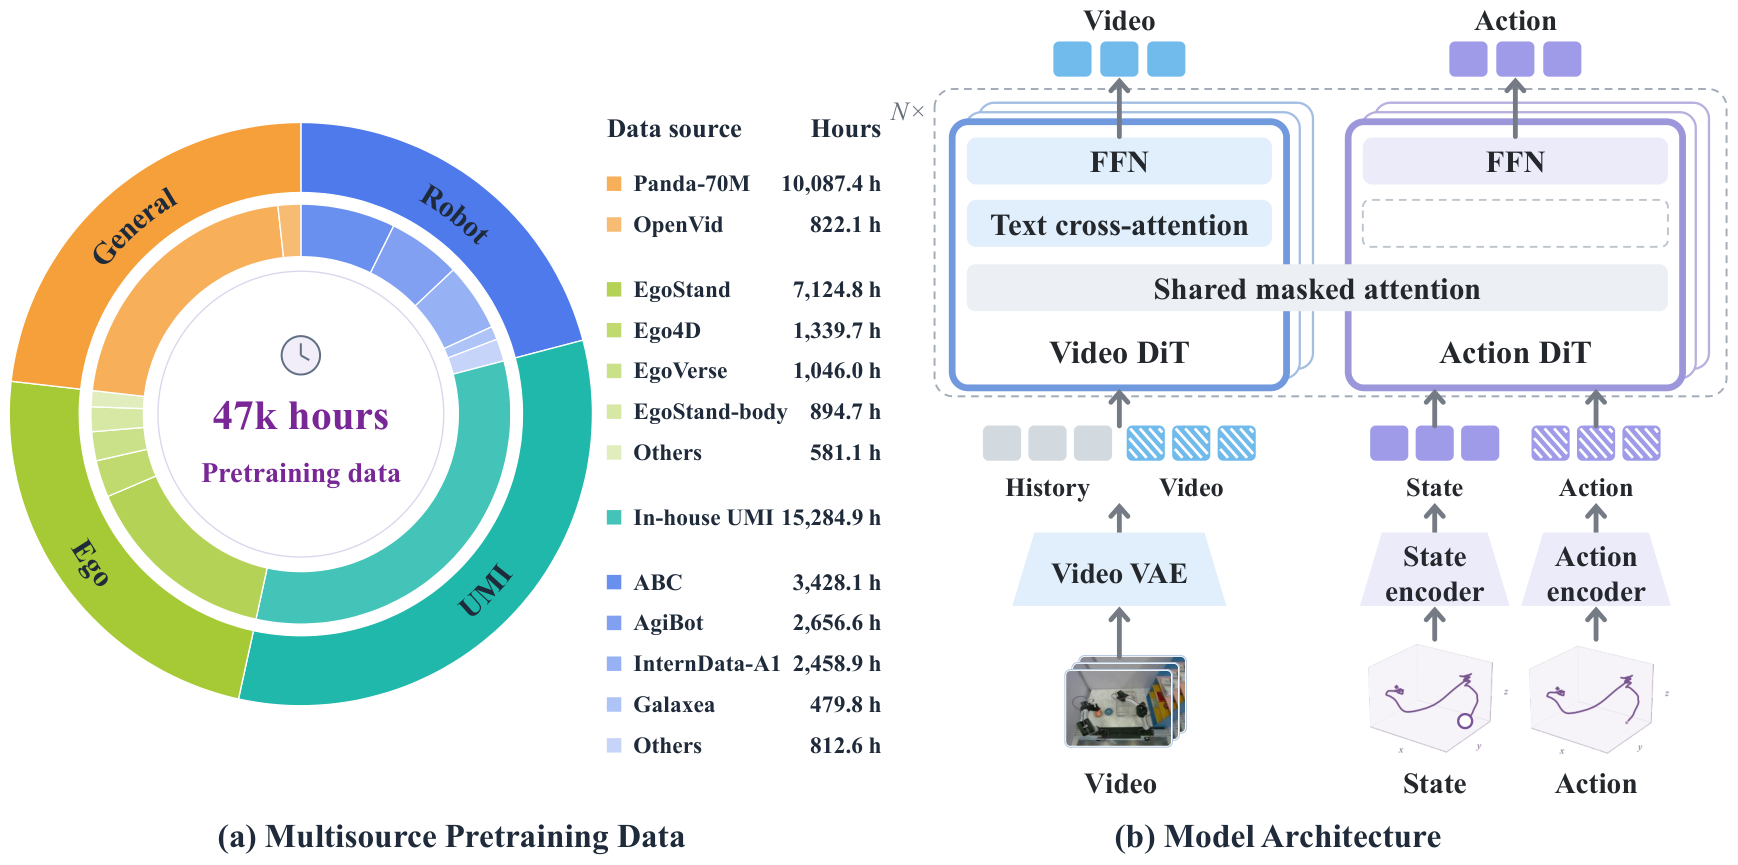
Figure 2 — 데이터 구성 및 모델 개요
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 SWAM을 제안합니다. SWAM은 multisource 경험을 language–video, language–video–action, joint learning의 세 수준에서 정리한 WAM pretraining recipe입니다.
방법론
- Data pool: general video 10,909.6h(Panda-70M, OpenVid), egocentric video 10,986.3h(EgoSuite, Ego4D, EgoVerse), UMI 15,284.9h, robot data 9,836.0h(AgiBot, InternData-A1 등)로 구성됩니다. 전체 약 4.4M episode입니다 [Figure 2].
- Architecture: video branch는 Wan에서, action branch는 random initialization에서 시작합니다. 각 chunk는 video latent frame 2개와 action step 48개로 이루어집니다. 앞서 설명한 MoT 기반 Dual-stream 구조를 쓰며, action branch는 text cross-attention 없이 video feature를 통해서만 language 정보를 받습니다. 학습 시에는 teacher forcing, inference 시에는 chunk 단위 causal 생성을 사용합니다 [Figure 3].
- Training objective: video와 action에 대한 flow matching loss를 같은 가중치로 더합니다(L = L_video + L_action). 모든 sample이 video loss에 기여하고, 유효한 action label이 있는 sample만 action loss에 기여합니다. 덕분에 action이 없는 video도 같은 학습에 함께 사용할 수 있습니다.
- Language annotation: Qwen 3.8 Max와 Seed 2.1 Pro로 subtask segmentation을 수행하고, 세 수준(Brief, Medium, Detailed)의 caption과 scene·lighting 정보를 생성합니다.
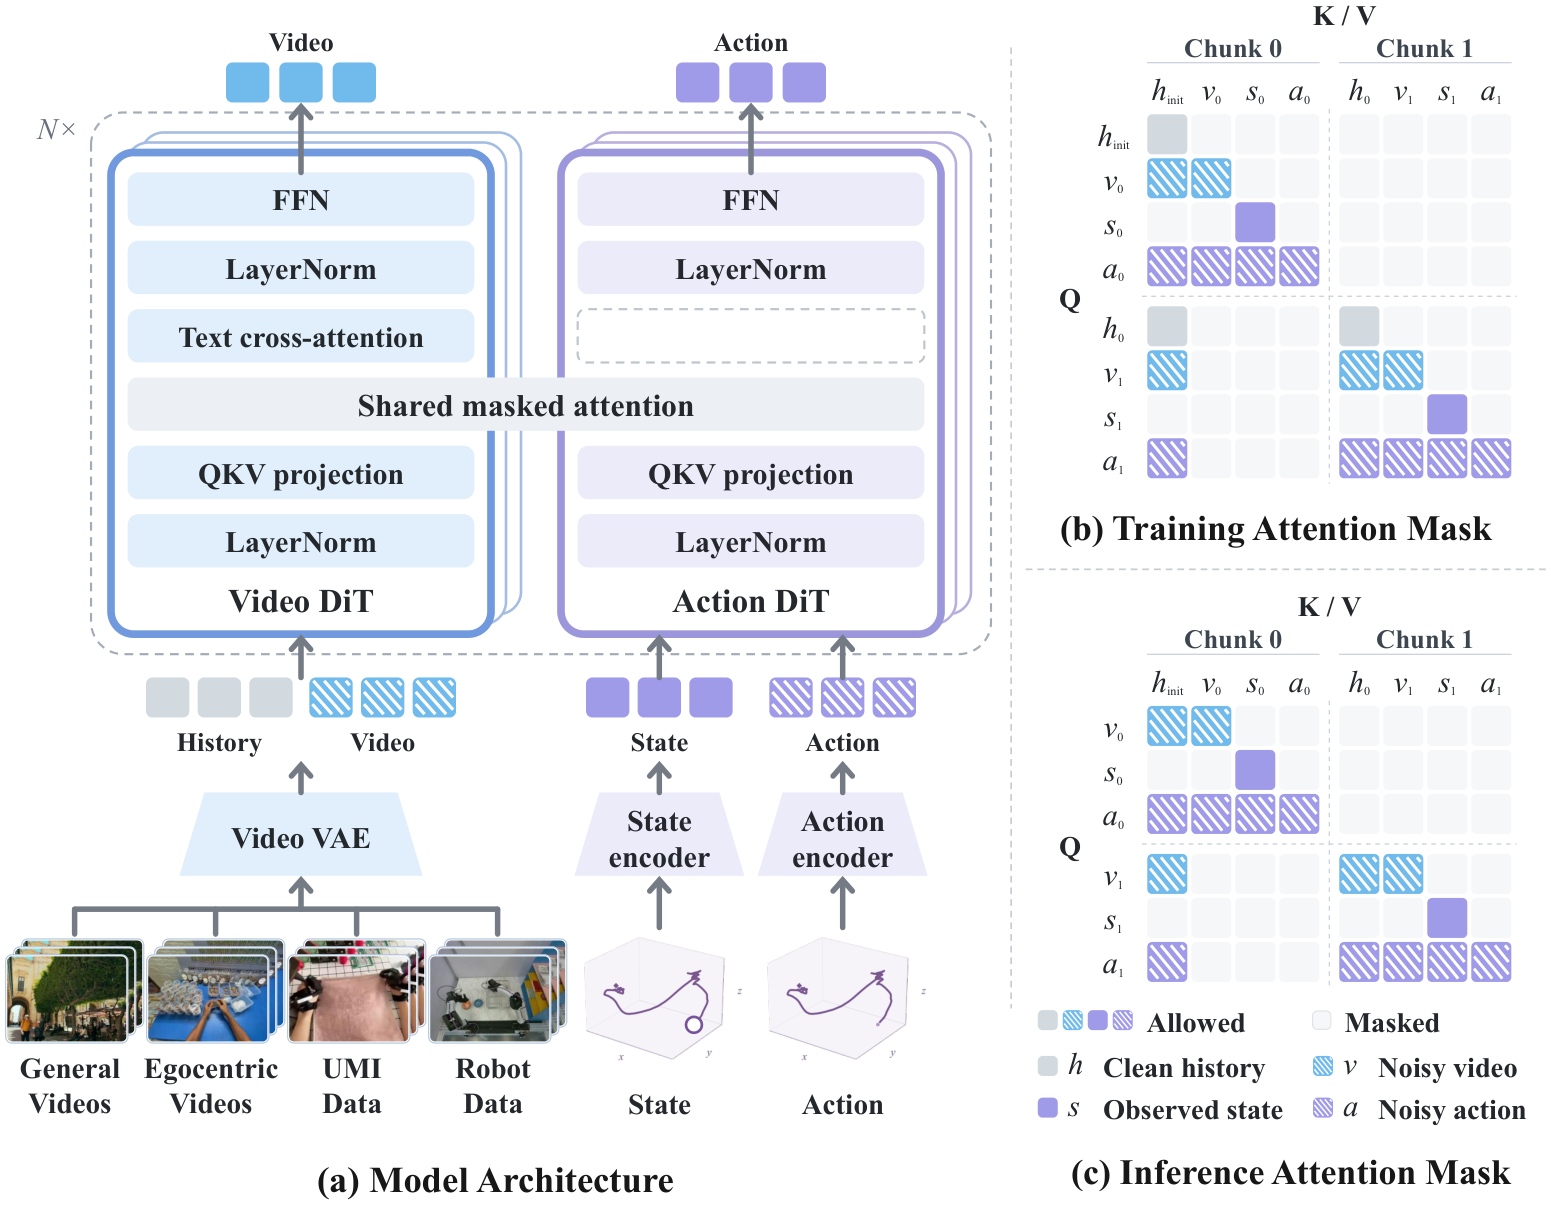
Figure 3 — WAM 구조와 attention mask
핵심 결과 (RoboTwin 2.0, 50 tasks)
- Language supervision:
- Subtask 단위에서 caption이 상세해질수록 Hard SR이 높아졌습니다(Brief 47.20% → Medium 49.60% → Detailed 53.52%). Env. 정보를 추가하면 55.04%까지 오릅니다.
- caption과 video 구간의 대응을 무작위로 섞으면 52.00%로 떨어졌습니다.
- robot data caption을 Detailed + Env.로 바꾸면 Original(50.80%) 대비 56.16%를 달성했습니다.
- UMI action supervision: UMI의 action-label coverage를 0%에서 100%로 늘리면 Hard SR이 46.72% → 51.28%로 올랐습니다(+4.56%p). UMI는 사람이 수집한 데이터이므로 embodiment가 다르지만, 이렇게 cross-embodiment human 경험도 효과적임을 확인했습니다.
- Data mixing: 20k step으로 budget을 고정했을 때 Ego:UMI = 1:1에서 Hard SR이 53.84%로 가장 높았습니다. General video로 25k step transitional pretraining을 추가하면 56.48%로 올랐습니다.
- Architecture:
- 저자들의 language conditioning pathway를 쓴 구조가 Hard 57.36%를 기록했습니다. Single-stream(52.56%), 일반 Dual-stream(52.48%)보다 높습니다.
- CLIP, DINOv2, SigLIP2, Qwen3-VL 같은 외부 image feature를 추가하면 오히려 39.76–42.96%로 떨어졌습니다.
- Scaling:
- pretraining 없이 post-training만 하면 Hard SR이 34.56%였습니다. Ego+UMI로 75k step을 학습하면 59.60%, robot data 25k step을 추가하면 61.52%가 됩니다.
- real-world Hard 설정에서는 training video hours를 22.5k에서 90k로 늘리자 SR이 33.33% → 48.89%, PSR이 46.90% → 61.43%로 꾸준히 올랐습니다.
- Main comparison:
- RoboTwin에서 Hard 61.56%로 가장 강한 baseline인 OpenWAM(48.70%)보다 12.86%p 높았습니다. Avg.도 74.83%로 가장 높습니다. 다만 Easy는 88.10%로 OpenWAM(89.30%)보다 약간 낮습니다.
- real-world(bimanual Flexiv Rizon 4, 3개 task) Hard에서 SR 40.00%(OpenWAM 23.33%), PSR 50.36%(π0.5 37.78%)로 모두 1위였습니다 [Figure 7].
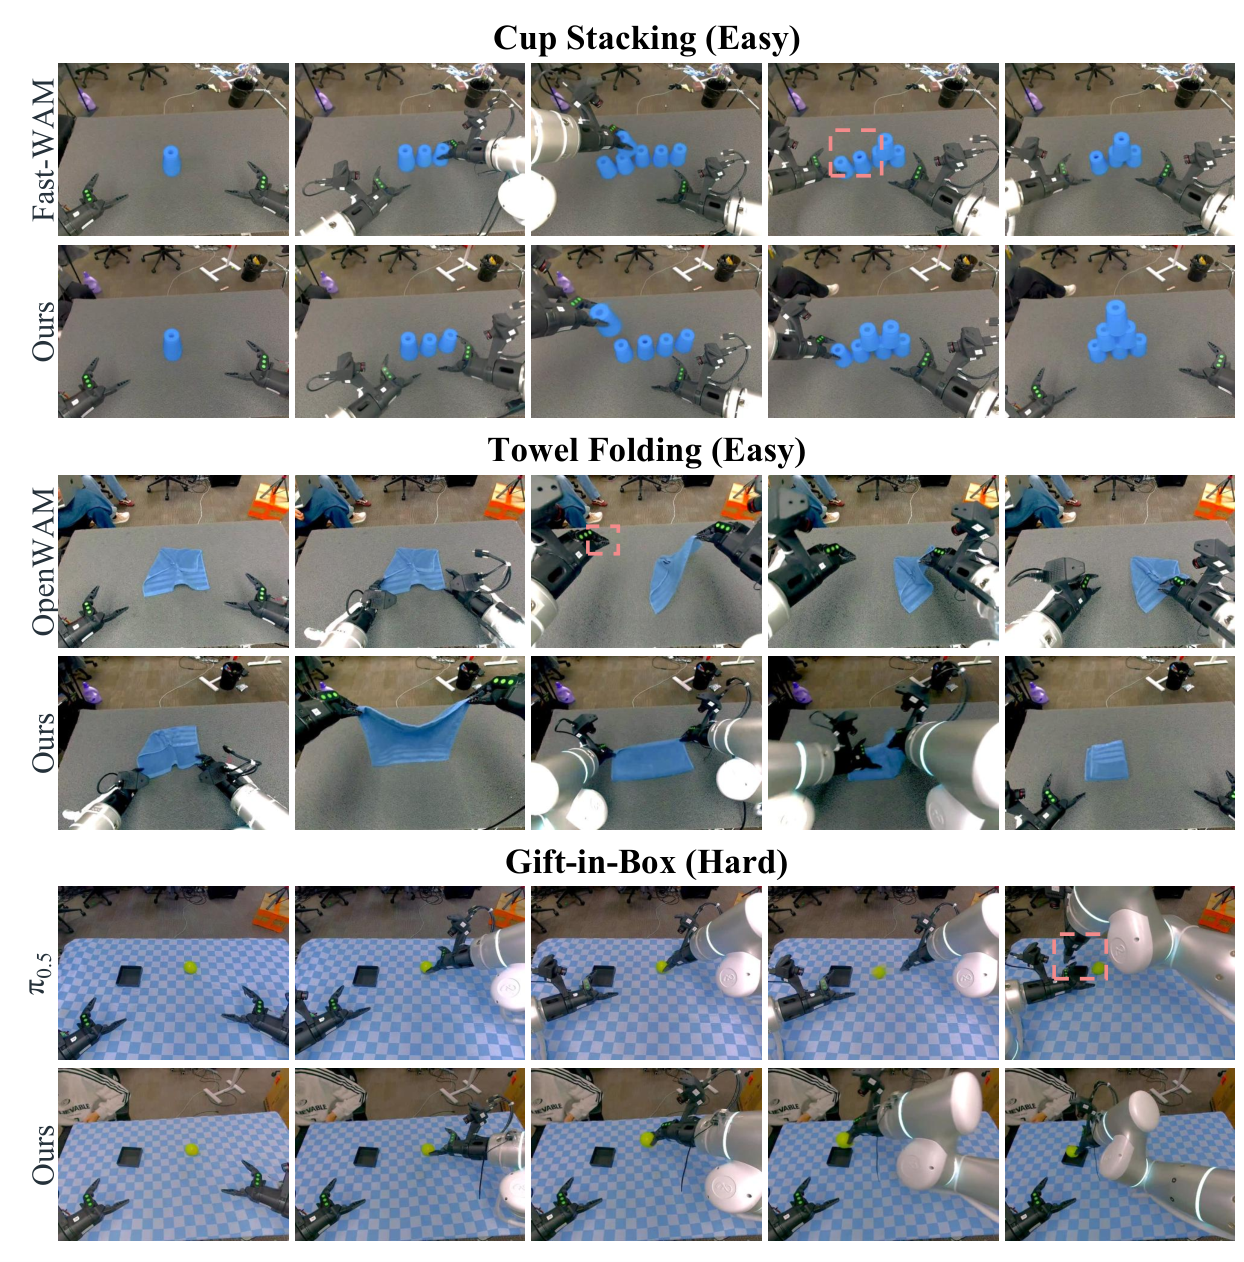
Figure 7 — 실제 로봇 실행 비교
4. Conclusion & Impact (결론 및 시사점)
이 논문의 결론은 pretrained language–video 능력을 보존하는 것과 이를 language–video–action으로 확장하는 것이 함께 이루어질 때 WAM의 control generalization이 좋아진다는 것입니다.
- 상세하고 정확하게 대응되는 language description은 video prior의 forgetting을 줄입니다.
- UMI 기반 human manipulation 경험은 visual domain이 robot과 달라도 효과적인 action supervision이 됩니다.
- multisource 학습의 이득은 data mixing ratio와 architecture(language conditioning pathway)에 따라 달라집니다. 선택한 recipe에서는 pretraining을 늘릴수록 성능이 계속 올랐습니다.
시사점
- handheld UMI 장치로 수집할 수 있는 human demonstration이 robot data의 scaling 한계를 보완하는 확장 가능한 data source임을 실증했습니다.
- 산업계와 학계의 data collection, annotation 설계에 실용적인 지침을 줍니다.
- data, training code, model weight를 공개해 재현성과 후속 연구를 지원합니다.
한계
- 저자들은 복잡한 reasoning, 명시적인 multi-stage planning, long-horizon task 지원이 제한적이라고 밝혔습니다.
- 향후 memory mechanism과 hierarchical planning을 연구할 계획입니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] GE-Act 2.0: Pretraining and Scaling a World-Action Model for Robotic Manipulation
- [논문리뷰] InternW0-Δ: A World Action Model Bridging Predictive Dynamics and Actions with 20K+ Hours of Open Data
- [논문리뷰] Open-HumanScale: An Open Recipe for Scaling Human and Robot Experience for Embodied Foundation Models
- [논문리뷰] GigaWorld-Policy-0.5: A Faster and Stronger WAM Empowered by AutoResearch
- [논문리뷰] Acting Through Registers
Review 의 다른글
- 이전글 [논문리뷰] SIRIS: Can LLMs Tell When Simulation Errors Matter in AI-Driven Systems Research
- 현재글 : [논문리뷰] SWAM: Scaling World Action Models with Cross-Modal Alignment
- 다음글 [논문리뷰] Sage-Taiyi: A Metacognitive Architecture for Scientific Discovery
댓글