[논문리뷰] Bits or permutations? Spending a fixed inference budget on weight precision or on option-order averaging in small local language models
링크: 논문 PDF로 바로 열기
저자: Mohammed Nayeem Khan, Logesh L, Aliyas Ahmad Misri
1. Key Terms & Definitions (핵심 용어 및 정의)
- RTN (Round-to-Nearest) with absmax scales: decoder의 모든 linear layer(q, k, v, o, gate, up, down)의 weight를 input dimension 기준 64개 group으로 나눕니다. group마다 fp16 scale
s = max|w| / (2^(b-1) - 1)를 두고 반올림하는 simulated quantization입니다. 실제 packing이나 low-bit kernel은 사용하지 않습니다. - Flip rate: option 순서를 바꾼 두 order 쌍 중 선택된 option이 달라지는 비율입니다. forward orbit(원래 순서의 4개 cyclic shift)과 reversed orbit(역순의 4개 cyclic shift) 사이에서 측정합니다.
- Slot skew: 선택된 slot(A~D) 분포와 uniform 분포 사이의 total variation distance입니다. 모델이 내용과 무관하게 특정 answer letter를 선호하는 정도(slot prior)를 나타냅니다.
- Matched-SNR noise control: group별 RTN rounding error의 RMS와 같은 크기의 Gaussian noise로 rounding error를 대체한 대조군입니다. rounding 자체의 효과와 일반적인 weight error의 효과를 분리하기 위해 사용합니다.
- Cost (weight bytes read × passes): machine-independent 비용 단위입니다. cell (b, K)의 비용은
K (b + 0.25) / 16이며 fp16 1 pass = 1입니다. 예를 들어 6-bit 1 pass는 0.391, 4-bit 1 pass는 0.266입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 local LLM 사용자가 고정된 inference budget을 weight precision(bit 수)에 쓸지, option-order averaging(여러 번의 reordered pass)에 쓸지를 정량적으로 답하고자 합니다. 질문은 두 가지입니다.
- Q1: low-bit quantization이 accuracy 손실로 설명되는 수준을 넘어 order sensitivity와 slot prior를 키우는가?
- Q2: 같은 비용에서 "더 강하게 quantize하고 K개 order를 평균"하는 것이 "더 많은 bit로 1회 답변"보다 나은가?
기존 연구는 두 갈래로 나뉘어 있습니다. selection bias 연구(Zheng et al., Pezeshkpour & Hruschka, Ok et al.)는 option 순서 민감도를 다뤘고, quantization 연구(Proskurina et al., Zhou et al.)는 confidence와 degradation을 다뤘습니다. 저자들의 title-level 검색에서는 두 주제를 결합한 연구가 발견되지 않았습니다. 또한 permutation self-consistency 계열 연구는 추가 pass 비용을 당연한 대가로 취급하며, 이를 weight precision과 같은 단위로 비교하지 않았습니다. 따라서 bit와 permutation을 하나의 비용 단위로 환산하는 framework가 필요합니다 [Figure 1].
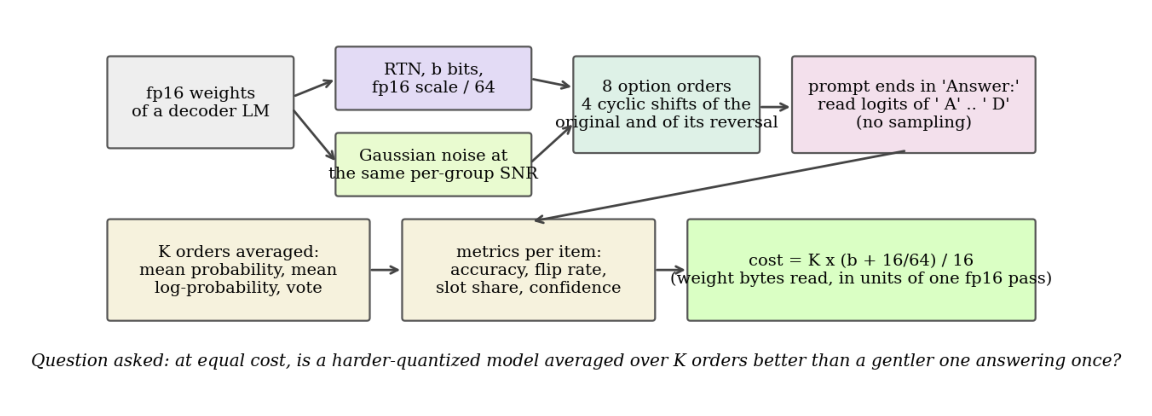
Figure 1 — 전체 실험 파이프라인과 비용 정의를 보여주는 프레임워크 다이어그램
3. Method & Key Results (제안 방법론 및 핵심 결과)
본 논문의 결론은 6-bit weight를 쓰고 남은 budget을 최대 4개 order 평균에 투자하라는 단순한 decision rule로 요약됩니다.
실험 설정
- 모델: Qwen3-0.6B, Qwen3-1.7B
- 정밀도: fp16 reference와 RTN 8/6/4/3-bit, 그리고 4/3-bit SNR에 맞춘 Gaussian noise control
- 데이터: ARC-Easy, ARC-Challenge, MMLU, HellaSwag 각 300문항
- 측정 방식: 각 문항을 8개 order(forward/reversed orbit 각 4개 cyclic shift)로 제시합니다. "Answer:" 이후 위치에서 letter A~D의 logit을 읽어 accuracy, flip rate, slot skew, ECE를 계산합니다.
- 통계: 모든 비교는 item-level paired bootstrap(1,000 resample)으로 수행합니다.
- 추가 분석: 저자들은 fp16 답변을 확률 r로 uniform random option으로 대체하는 accuracy-matched baseline을 둡니다. 이를 통해 accuracy 손실만으로 설명되는 flip을 분리합니다.
Q1 결과: quantization과 order sensitivity
- 정확도 변화: 6-bit는 fp16 대비 +1.8(0.6B), +0.9(1.7B) point로 손실이 없습니다. 저자들은 이 상승의 원인을 설명하지 않으며, 6-bit가 모델을 개선한다고 주장하지도 않습니다. 8-bit는 -0.7, -0.4 point입니다. 4-bit에서는 0.6B가 -14.3, 1.7B가 -5.6 point 손실을 보이며, 3-bit에서는 두 모델 모두 chance 수준(25.4%, 26.6%)입니다 [Table 2].
- Slot skew: 4-bit에서 0.6B는 0.15 → 0.53, 1.7B는 0.07 → 0.12로 상승하며, 이는 accuracy-matched baseline(0.06)을 크게 넘습니다.
- Noise control: matched-SNR noise도 slot skew 0.15/0.37(0.6B, 2 draws), 0.19(1.7B)를 만들어 냅니다. 따라서 rounding 고유의 slot prior가 있는지는 inconclusive입니다.
- Flip rate: bit가 줄수록 상승하지만, 4-bit에서 baseline 대비 excess는 -5.1(0.6B), -5.3(1.7B) point입니다. 즉 이 baseline 기준으로는 flip 증가가 accuracy 손실로 설명됩니다.
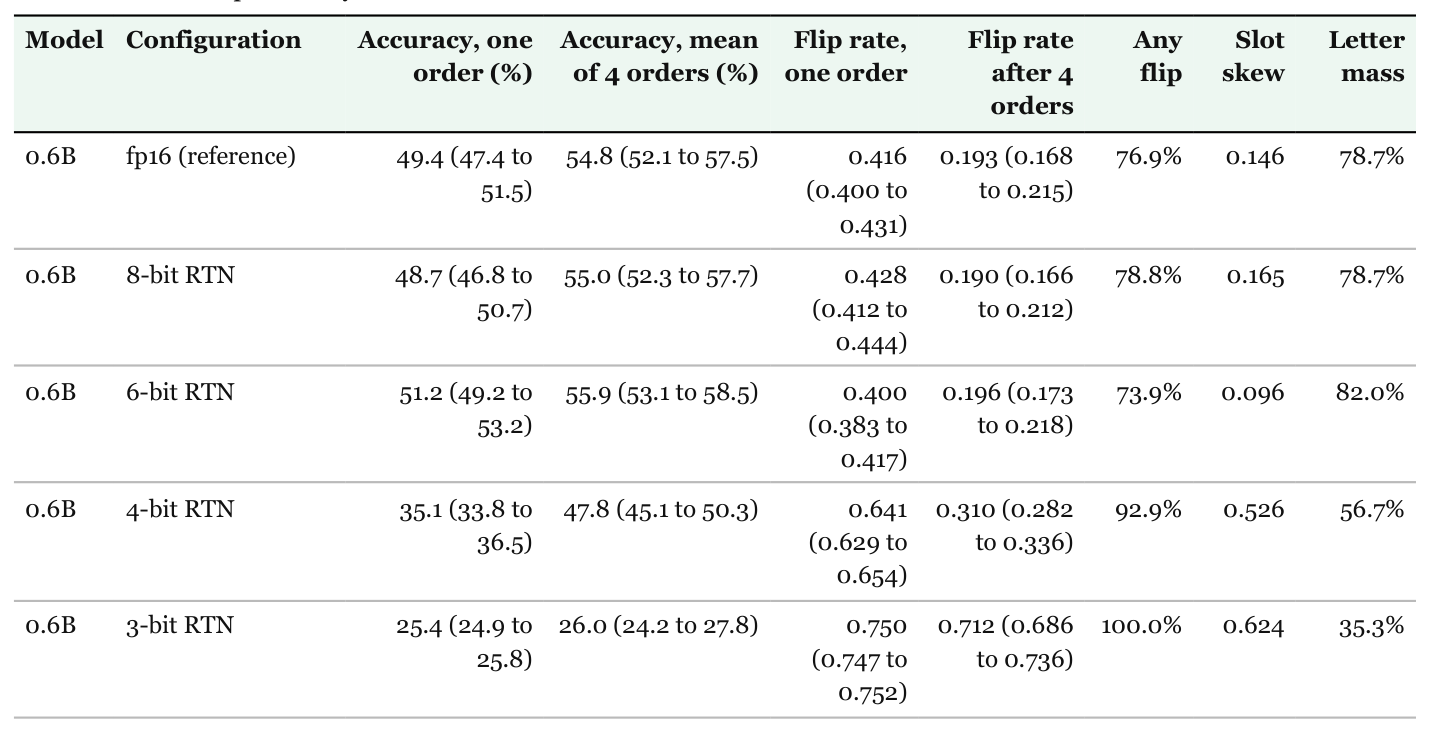
Table 2 — bit 수별 accuracy, flip rate, slot skew 및 4-order averaging 효과를 담은 핵심 결과 표
Order averaging 효과
- 4개 cyclic order 평균은 0.6B에서 fp16 +5.3, 4-bit +12.6 point를 회복합니다. 1.7B에서는 각각 +3.8, +4.9 point입니다 [Table 2].
- 4-bit 0.6B의 ECE는 0.332 → 0.087로 감소합니다.
- order agreement의 AUROC는 4-bit에서도 0.65/0.78을 유지하여, label 없이 정답 여부를 판단하는 신호로 single-pass confidence보다 낫습니다.
Q2 결과: 비용 대비 비교
- cost-matched 쌍에서 extra order가 이기는 경우는 각 모델 10개 중 2개뿐이며, 모두 many-order cell이 8/6-bit인 경우입니다. 예를 들어 6-bit×2 vs fp16×1은 +4.1(0.6B), +3.2(1.7B) point입니다.
- 반면 4-bit×2 vs 8-bit×1은 -8.3, -2.1 point로, 이 bit 범위에서는 더 많은 bit가 유리합니다.
- accuracy-cost frontier는 두 모델 모두 6-bit K=1~4와 가장 저렴한 3/4-bit single pass로 구성됩니다 [Figure 14].
- Bit equivalent로 환산하면, 4-bit에서 K=4는 약 5.6-bit 1회 pass와 같은 정확도입니다. 이에 드는 weight byte 비용은 bit를 늘리는 경우 1.37배, order를 4개로 늘리는 경우 4배이므로, bit를 더 저장할 수 있다면 bit가 더 저렴합니다.
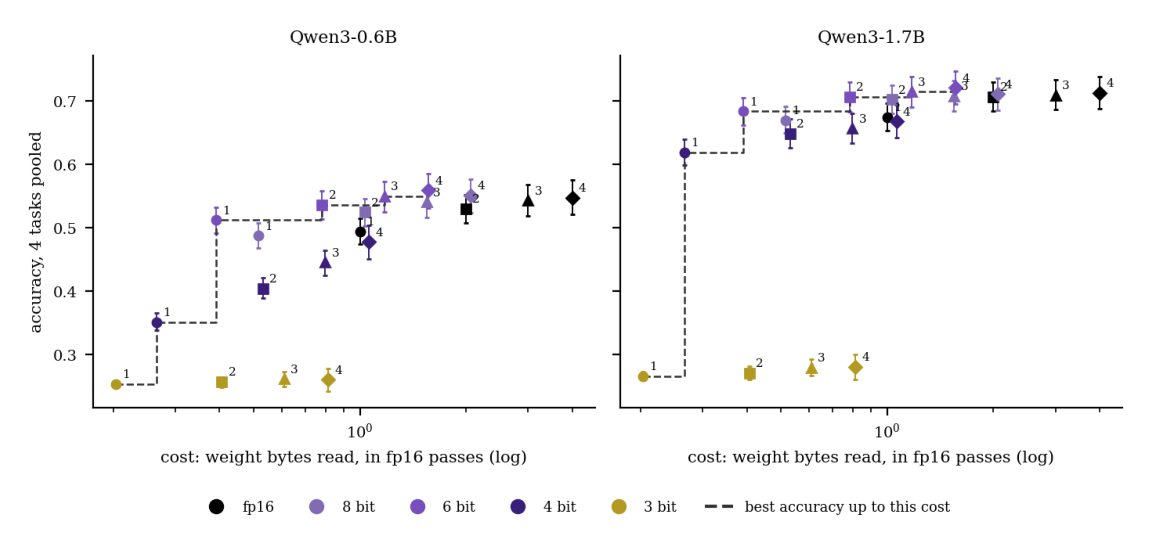
Figure 14 — bit와 permutation 간 exchange rate 및 6-bit frontier를 보여주는 핵심 그래프
Decision rule (cross-fitted)
- budget B ≥ 0.391이면 6-bit와 K = floor(B/0.391) (최대 4)를 선택합니다.
- 그 미만이면 4-bit 1 order를 선택합니다.
- 두 모델과 두 half 모두에서 같은 선택이 나왔습니다.
4. Conclusion & Impact (결론 및 시사점)
본 논문은 small local LLM에서 weight bit와 permutation averaging을 하나의 비용 단위로 비교한 첫 시도로 제시되며, 결론은 "6-bit weight + 최대 4 order 평균"입니다.
- Slot prior 증가와 noise control의 한계: low-bit quantization은 slot prior를 크게 키우지만, matched-SNR noise도 유사한 효과를 낼 수 있습니다. 따라서 이 효과를 rounding 고유의 현상으로 확정하지는 못했습니다.
- Order averaging의 실용적 가치: order averaging은 accuracy 회복, calibration 개선, label-free confidence 신호 제공이라는 효용이 있습니다. 특히 K개 order를 batch로 처리해 weight read를 공유할 수 있다면 averaging을 적극 권장합니다.
- 산업적 시사점: on-device 배포에서는 quantization과 test-time compute를 함께 설계해야 하며, 단순한 정확도 지표 외에 slot skew를 별도 진단 지표로 모니터링할 필요가 있습니다.
- 일반화의 한계: 결과는 두 소형 모델, 가장 단순한 RTN quantizer, first-token logit protocol, cost proxy에 한정됩니다. 저자들은 더 큰 모델이나 GPTQ/AWQ 같은 quantizer로의 일반화를 주장하지 않습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
Review 의 다른글
- 이전글 [논문리뷰] dNaViT: Discrete Codes are General-Purpose Visual Representations
- 현재글 : [논문리뷰] Bits or permutations? Spending a fixed inference budget on weight precision or on option-order averaging in small local language models
- 다음글 [논문리뷰] CARTBench: Rubric-Based Evaluation of Shopping Advice for Complex and Ambiguous Requests with Timelines
댓글