[논문리뷰] Module-Aware Optimization for Graph Neural Networks
링크: 논문 PDF로 바로 열기
저자: Guy Hadad, Haggai Roitman, Moshe Eliasof, Bracha Shapira
1. Key Terms & Definitions (핵심 용어 및 정의)
- Graph-propagated input ($X_g = SH$): GNN layer의 weight matrix $W$가 실제로 작용하는 입력입니다. 정규화된 propagation operator $S$를 node representation $H$에 적용해 얻습니다. update $\Delta W$의 실제 효과는 $|\Delta W|_F$가 아니라 $X_g\Delta W$로 결정됩니다.
- Graph-induced covariance ($C_g = X_g^\top X_g / n$): graph-propagated input의 covariance입니다. 출력 공간의 normalized Frobenius geometry를 parameter space로 pullback한 metric이며, 고에너지 eigenspace 방향의 update는 representation을 크게 섭동시킵니다.
- Graph-aware Orthogonalization: trace-normalized·regularized covariance $\bar{C}_g$를 사용합니다. momentum $M$을 $\bar{C}_g^{\tau/2}$로 graph metric에 매핑한 뒤 Newton–Schulz(NS)로 orthogonalize하고, $\bar{C}_g^{-\tau/2}$로 되돌리는 과정입니다. $\tau \in [0,1]$이 graph-awareness 강도를 조절하며, $\tau=0$이면 vanilla Muon과 같습니다.
- Graph-aware Step Normalization ($s_g$): raw covariance $C_g$를 기준으로 update direction의 RMS representation-level 섭동 $\sqrt{\mathrm{tr}(D^\top C_g D)/|D|_F^2}$을 계산합니다. 이 값으로 step을 나눠 실제 출력 변화량을 통제합니다.
- Validation-loss Time-to-Target: AdamW가 달성한 최소 mean validation loss를 target으로 두고, 각 optimizer가 이 target에 처음 도달하는 epoch 수와 누적 wall-clock 시간을 비교하는 평가 프로토콜입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문의 핵심 문제는 기존 optimizer가 GNN weight update를 parameter space에서만 정규화한다는 점입니다. 이 때문에 graph propagation으로 인한 representation-level update amplification을 통제하지 못합니다.
- AdamW의 한계: coordinate-wise moment로 update를 조정하므로, graph propagation이 증폭하는 방향과 감쇠하는 방향을 구분하지 못합니다.
- Muon의 한계: weight matrix 구조를 활용해 orthogonalized update를 사용하지만, orthogonalization 자체는 input-agnostic합니다. dense feature든 token이든 graph-propagated representation이든 동일한 Euclidean matrix geometry를 적용합니다.
- 이론적 근거: vanilla Muon step의 섭동은 $\frac{1}{\sqrt{n}}|X_g\Delta W|F \le \alpha\sqrt{\lambda{\max}(C_g)}|D|F$로 상한이 주어집니다. Proposition 1은 이 $\sqrt{\lambda{\max}(C_g)}$ 증폭이 loose bound가 아니라 실제로 달성 가능한(feasible) polar direction이 존재함을 보입니다.
- 구조적 원인: hub-dominated graph처럼 propagation이 anisotropic geometry를 만드는 경우, Euclidean 공간에서 잘 정규화된 동일한 update가 representation space에서는 크게 증폭될 수 있습니다 [Figure 1].
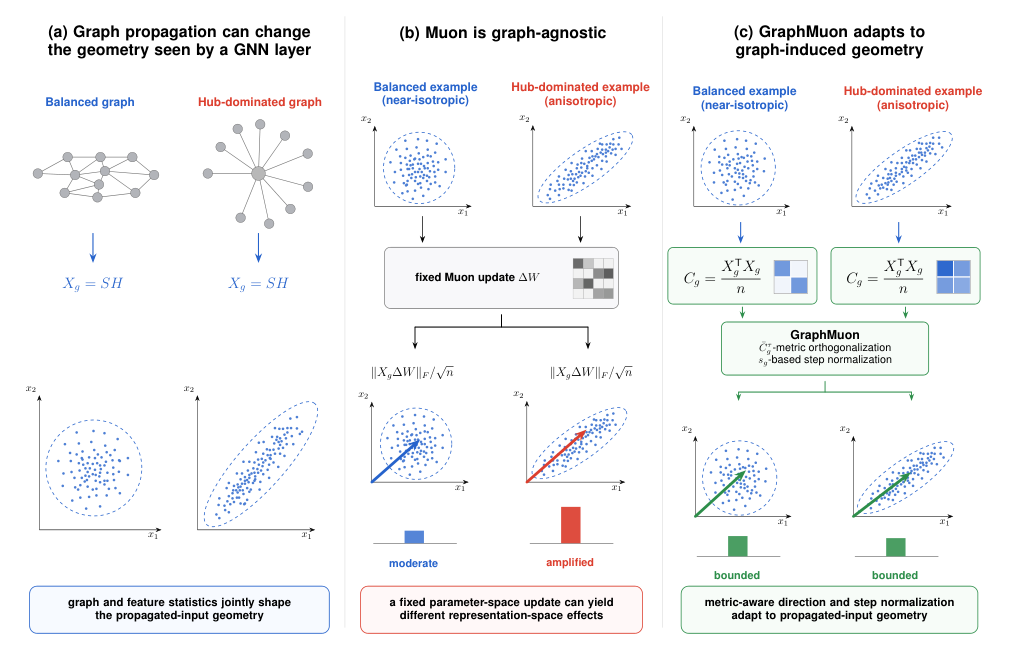
Figure 1 — 문제 정의와 GraphMuon의 핵심 아이디어(graph-metric orthogonalization, s_g 기반 step normalization)를 보여주는 개념 다이어그램
따라서 GNN optimizer는 matrix-aware인 동시에 graph-aware여야 한다는 것이 저자들의 주장입니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
저자들은 Muon의 polar update를 graph-induced metric으로 일반화한 GraphMuon을 제안합니다. 두 가지 구성 요소로 이루어집니다.
방법론
- Graph-aware Orthogonalization: $D_{g,\tau} = \bar{C}_g^{-\tau/2},\mathrm{NS}_K(\bar{C}_g^{\tau/2}M_t)$를 계산합니다. Theorem 2는 이 방향이 $D^\top \bar{C}_g^\tau D = I$ 제약 하의 graph-metric Procrustes problem의 해임을 증명합니다. 즉 ad hoc rescaling이 아니라 Muon polar update의 graph-metric analogue입니다.
- Graph-aware Step Normalization: update를 $\eta r D/s_g$로 스케일링합니다. Theorem 1에 따라 $\frac{1}{\sqrt{n}}|X_g\Delta W|F \le \alpha|D|F$가 성립하며, $\epsilon{scale}=0$이면 등호가 성립하므로 $\lambda{\max}(C_g)$ 의존성이 제거됩니다.
- 효율적 구현: 다음 기법으로 추가 비용을 줄입니다.
- forward pass에서 계산된 $H_{prop}$을 재사용
- m=2048 node subsampling으로 covariance 추정
- $d_{in}>512$일 때 diagonal approximation 사용
- eigendecomposition caching
- 오버헤드: ogbn-products 규모 설정에서 Muon 대비 per-step 시간은 2.8%(1.411s vs 1.372s), 추가 메모리는 약 0.005 GB에 그칩니다.
핵심 결과
- 대규모 OGB 벤치마크 [Table 1]: GraphMuon은 AdamW 대비 다음과 같은 wall-clock speedup을 달성했습니다.
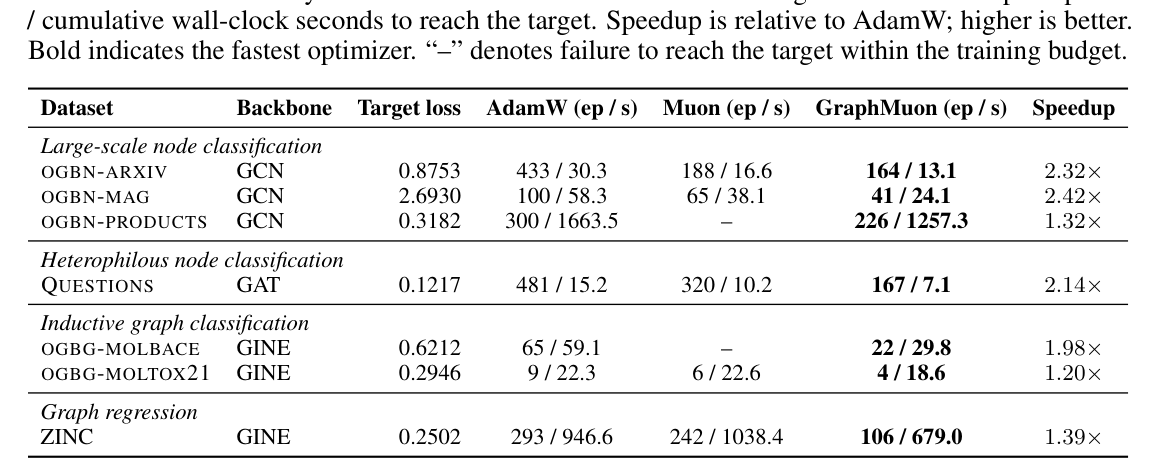
Table 1 — OGB 대규모 벤치마크 및 graph-level task에서의 핵심 speedup 결과
| Dataset | Speedup | 95% CI |
|---|---|---|
| OGBN-ARXIV | 2.32× | [2.01, 2.69] |
| OGBN-MAG | 2.42× | [2.29, 2.53] |
| OGBN-PRODUCTS | 1.32× | [1.19, 1.37] |
Muon은 OGBN-PRODUCTS와 OGBG-MOLBACE에서 target에 도달하지 못했습니다.
- 다른 task로의 확장 [Table 1]: QUESTIONS(GAT) 2.14×, OGBG-MOLBACE 1.98×, OGBG-MOLTOX21 1.20×, ZINC(GINE) **1.39×**를 기록했습니다.
- 15개 dataset–architecture 설정 전체:
- 모든 설정에서 AdamW보다 적은 epoch으로 target에 도달했습니다.
- wall-clock 기준으로는 13/15에서 가장 빨랐고, arithmetic-mean speedup은 **4.62×**입니다.
- 최대 speedup은 ogbn-mag/GAT 16.85×, ogbn-arxiv/GraphGPS **16.07×**입니다.
- Citeseer/GCN(0.82×)과 ZINC/GraphGCN(0.95×)에서는 epoch 수가 적은데도 wall-clock 기준으로는 더 느렸습니다.
- 예측 성능: 5개 설정 중 4개에서 최고 test 성능을 보였습니다.
- ogbn-mag/GraphGPS Acc 0.3296
- BACE ROC-AUC 0.7927
- ZINC MAE 0.1897
- ogbn-arxiv/GAT에서는 AdamW와 동등한 수준입니다.
- Ablation [Table 3]: vanilla Muon 대비 speedup 기준으로, step normalization 단독(arxiv 8.34×)이 orthogonalization 단독(5.39×)보다 기여가 큽니다. 두 요소를 결합하면 다음과 같이 가장 높은 성능을 냅니다.
- ogbn-arxiv 9.02×
- ogbn-mag 3.60×
- ogbn-products 1.90×
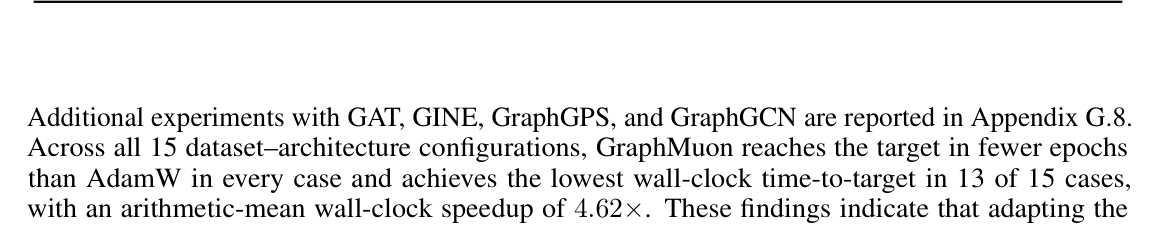
Table 3 — graph-aware orthogonalization과 step normalization 각 구성 요소의 기여도 분석
4. Conclusion & Impact (결론 및 시사점)
GNN의 effective update size는 $|\Delta W|_F$가 아니라 graph-propagated representation 섭동 $|X_g\Delta W|_F/\sqrt{n}$입니다. GraphMuon은 이를 direction(graph-metric polar)과 scale(step normalization) 양쪽에서 통제해 GNN 학습을 일관되게 가속합니다.
이 방법은 $C_g$가 안정적이고 anisotropic하며 informative할 때 가장 효과적입니다. 반대로 작은 graph나 node 수가 hidden dimension 대비 적은 inductive graph-level task에서는 covariance 추정이 noisy해져 AdamW가 여전히 경쟁력을 가집니다. 저자들은 effective rank나 covariance stability 등을 이용해 $\tau$를 적응적으로 조절하는 방향을 향후 연구 과제로 제시합니다.
이 연구는 optimizer geometry가 parameter tensor의 shape뿐 아니라 그것이 속한 module의 forward map에 맞춰져야 한다는 module-aware optimization 원칙을 GNN에서 구체화했습니다. architecture 차원의 graph-adaptive 설계(GraphNorm, GRANOLA 등)를 optimizer 수준으로 확장했다는 점에서도 의의가 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Why Muon Outperforms Adam: A Curvature Perspective
- [논문리뷰] Muon Makes the First Mixture-of-Experts Layer Harder to Balance
- [논문리뷰] Unifying Graph Neural Networks Through a Common Layer Equation
- [논문리뷰] Same Architecture, Different Capacity: Optimizer-Induced Spectral Scaling Laws
- [논문리뷰] The Loss Does Not See the Basis, but Adam Does
Review 의 다른글
- 이전글 [논문리뷰] Mixed Signals: Weight-Space Programming for EEG and ECG
- 현재글 : [논문리뷰] Module-Aware Optimization for Graph Neural Networks
- 다음글 [논문리뷰] PolyRoute: A Twelve-Language and Code-Mixed Benchmark for Typed-Decision Routing, with Baselines and a Leaderboard
댓글