[논문리뷰] PolyRoute: A Twelve-Language and Code-Mixed Benchmark for Typed-Decision Routing, with Baselines and a Leaderboard
링크: 논문 PDF로 바로 열기
저자: Mohammed Nayeem Khan, Sarun Kumar K S (Intel Corporation)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Typed-Decision Encoder: 질문과 텍스트를 하나의 sequence로 묶어 single forward pass로 처리하는 encoder입니다. 각 option 앞의 placeholder(MASK) hidden state를 option head가 읽어 option별 score와 softmax 확률을 출력하며, token 단위 generation은 하지 않습니다.
- Native / Code-Mixed Split: 평가용 held-out split은 두 개입니다. Native split은 12개 언어 322개 메시지로 구성되고, code-mixed split은 Hinglish, Spanglish, Arabizi 156개 메시지로 구성됩니다.
- Consensus Subset: gold label(Qwen3.8-27B)과 독립 labeller(gemma4-31b)가 일치한 313개 항목입니다. 저노이즈 보조 지표로 사용됩니다.
- Withheld-Language Track (Reduced Exposure): Tamil, Bengali, Korean, Arabic의 native rows를 제외하고 fine-tuning한 variant입니다. Base rows에 399개 generic multilingual rows가 포함되어 있어 'zero-shot'이 아니라 'reduced exposure'로 정의됩니다.
- Smallest Detectable Difference: α=0.01, 80% power에서 paired McNemar test가 검출할 수 있는 최소 accuracy 차이입니다. 근사식은 ≈3.42√(d/n)이며, d는 두 system의 discordance rate입니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
이 논문은 typed-decision encoder가 English 밖에서 어떻게 동작하는지를 고정된 yardstick으로 측정하는 multilingual routing benchmark를 제안합니다. 대상 model family(Laya)는 두 checkpoint와 이를 고르는 Router를 함께 배포합니다.
- English ModernBERT-large root: 421M parameters
- Multilingual checkpoint: 322M parameters, 256k vocabulary
하지만 어떤 언어에 어떤 checkpoint를 신뢰할지, task-specific fine-tuning이 얼마나 기여하는지는 ad-hoc spot check로만 판단되어 왔습니다.
기존 benchmark는 이 질문에 바로 답하기 어렵습니다.
- XNLI, XTREME, MASSIVE, GLUECoS 등은 일반 task 또는 generation 기반 평가에 맞춰져 있습니다.
- 그래서 placeholder 기반 option scoring 인터페이스를 직접 평가하기 어렵습니다.
저자들은 질문을 billing / technical / other의 3-way department routing으로 단순화했습니다. 이렇게 하면 측정 대상이 질문의 난이도가 아니라 언어 자체가 됩니다. 입력 구조와 one-pass scoring 방식은 [Figure 1]에 나와 있습니다. 또한 작은 test split의 statistical resolution 한계를 명시적으로 정량화하는 것도 동기 중 하나입니다.
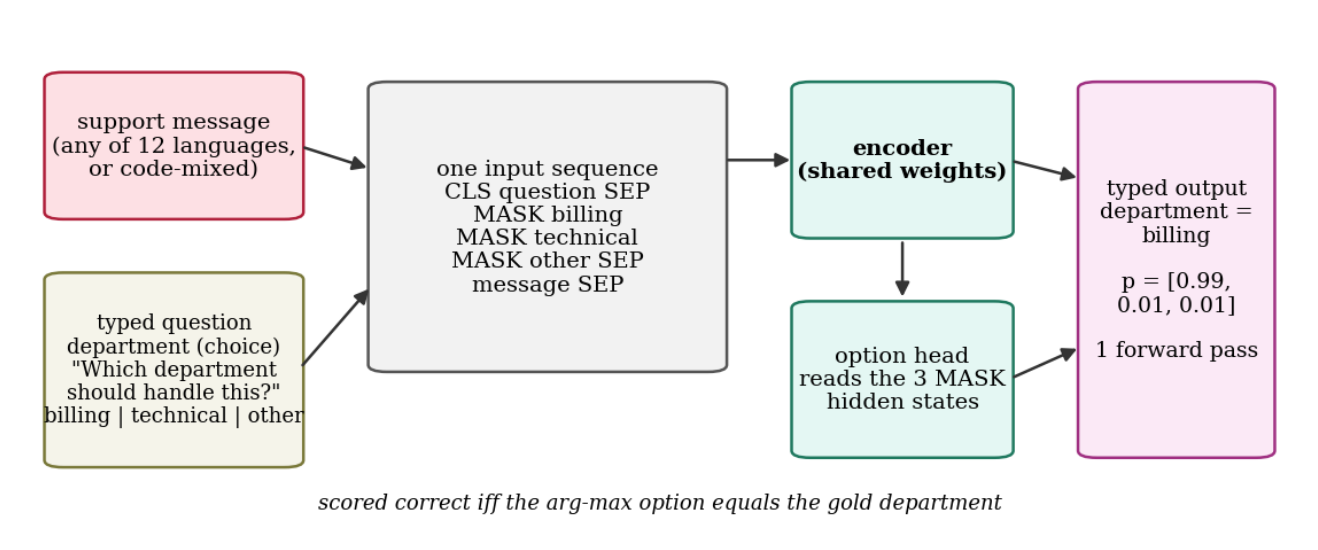
Figure 1 — Typed-decision encoder의 입력 구성과 one-pass option scoring 방식을 보여주는 핵심 구조 다이어그램
3. Method & Key Results (제안 방법론 및 핵심 결과)
PolyRoute는 LLM 기반 생성, blind self-consistency filtering, 독립 model family audit의 3단계로 구축되었습니다.
데이터 구축
- Qwen3.8-27B(temperature 0.9)가 언어×department별로 메시지를 생성했습니다.
- 같은 모델이 label을 숨긴 채 다시 분류하여 일치한 항목만 남겼습니다. 1,420개 중 1,289개(90.8%)가 유지되었습니다.
- gemma4-31b가 blind relabeling한 결과 97.2% [94.8–98.5]가 일치했습니다. 가장 낮은 언어는 Spanish(86%)였고, 'other' class 일치율은 92.0%로 가장 낮았습니다.
Leakage audit
- Character 5-gram Jaccard 기준 test–train 최대 similarity는 0.33(median 0.08)입니다.
- Exact duplicate는 0건입니다.
평가 설계
- Track A(as released), B(dedicated native rows 없음), C(native-row tuning), Reference로 구분합니다.
- Metric은 Wilson interval accuracy, language-macro accuracy, worst language, macro-F1, NLL, ECE입니다.
주요 결과 [Table 10]
- Track A: English root 61.2%, typed-decisions checkpoint 62.7%, shipped multilingual 77.3%.
- Fine-tuned multilingual system: 93.8–96.6% (best: all native rows, 96.6%, ECE 0.011).
- TF-IDF + LR(all rows)는 91.9%로, routing이 lexically 쉬운 task임을 보여줍니다.
- gemma4-31b classifier는 97.2%로 가장 높지만, 4개 fine-tune과 p<0.01에서 구분되지 않습니다.
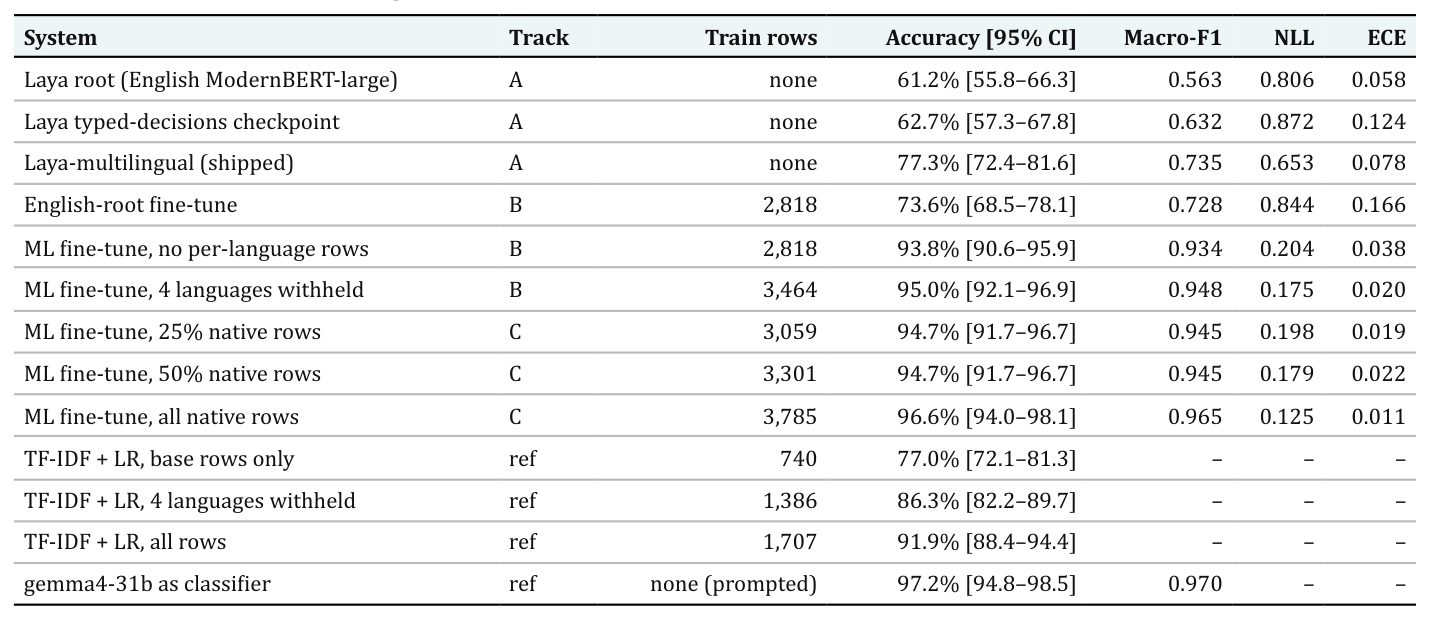
Table 10 — 13개 system의 accuracy, macro-F1, NLL, ECE를 비교하는 핵심 leaderboard 결과
Per-language 분석 [Figure 10]
- Root는 Arabic 32% ~ Japanese 83% 범위입니다.
- Shipped multilingual은 Indic group에서 가장 약합니다(63%).
- Tokenizer fertility와 accuracy의 Spearman 상관은 ρ=-0.34(root), -0.17(multilingual)로, n=12에서 유의하지 않습니다.
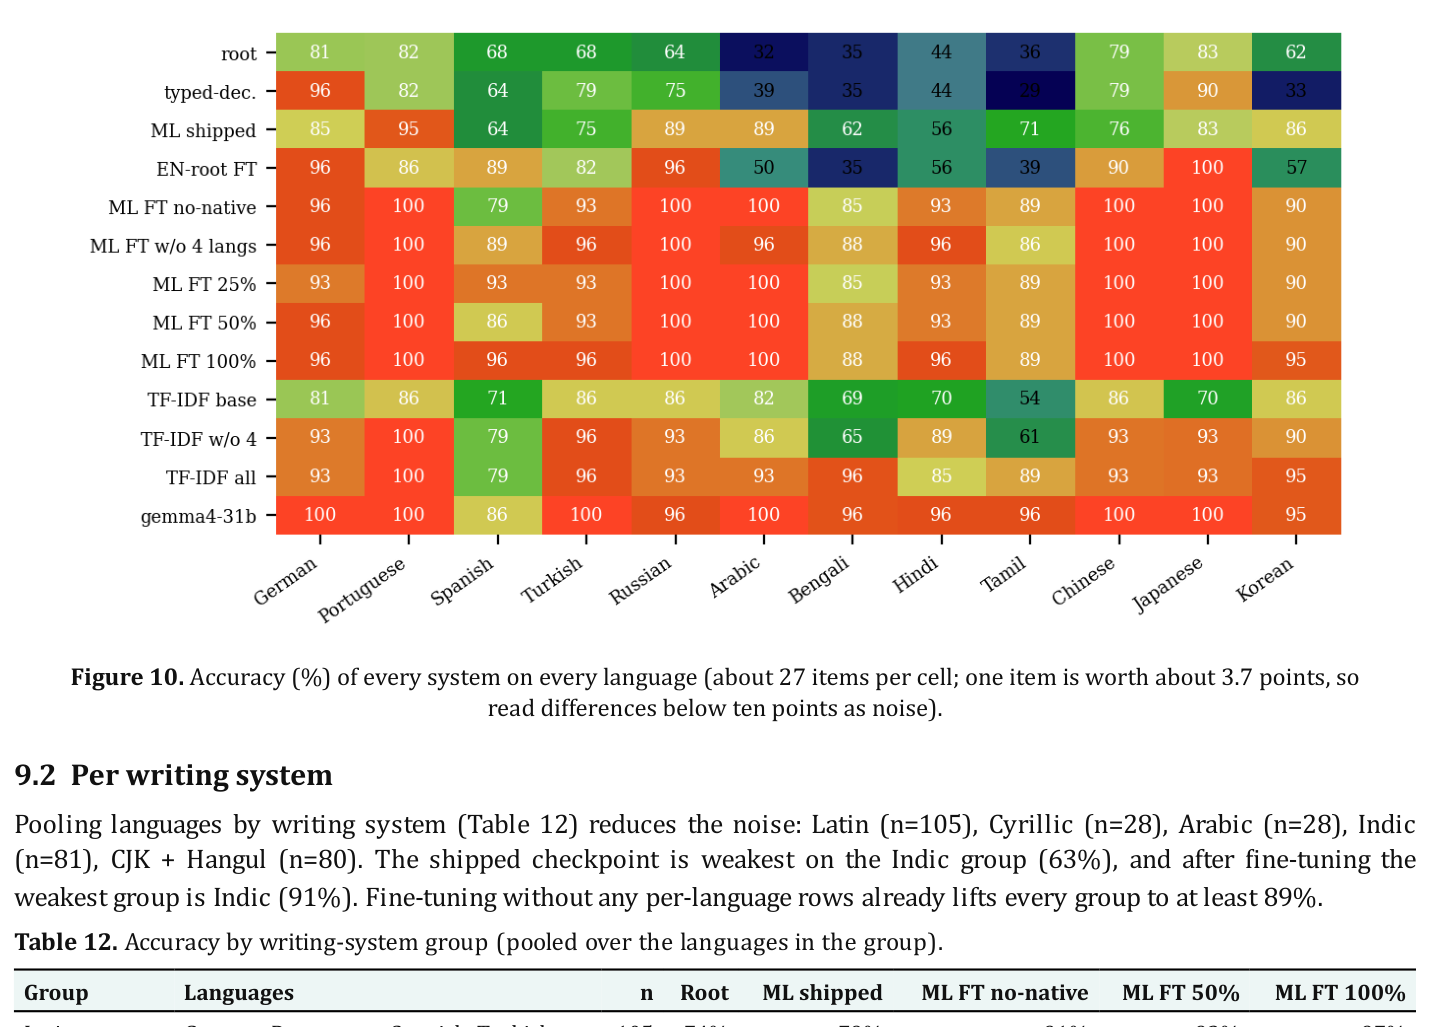
Figure 10 — 언어별·system별 성능 차이와 fine-tuning에 따른 language gap 축소를 보여주는 heatmap
Withheld-language transfer (4개 언어 기준)
- Shipped 76.7%, no per-language rows 91.3%, withheld fine-tune 90.3%, all-language fine-tune 93.2%.
- Transfer의 대부분은 base rows의 task fine-tuning에서 옵니다.
- Native-row learning curve(0→967 rows)의 추가 이득은 +2.8 points 수준이며 유의하지 않습니다.
Code-mixed split
- English root(84.6%)가 shipped multilingual(79.5%)보다 명목상 앞서지만 유의하지 않습니다(p=0.134).
- English-root fine-tune은 code-mixed에서 96.2%, native에서 73.6%로, 두 split이 서로 다른 능력을 측정함을 보여줍니다.
Stress test 및 resolution
- Option name을 rotation하면 best fine-tune이 6.5%로 급락합니다. 모델이 description보다 option name을 따른다는 뜻입니다.
- Option order를 바꿨을 때 예측이 바뀌는 비율은 root 37.3%, best fine-tune 1.6%입니다.
- 78개 system pair 중 55개만 p<0.01로 분리됩니다.
- 상위 system 간 resolvable difference는 약 3.6–4 points입니다.
4. Conclusion & Impact (결론 및 시사점)
PolyRoute는 typed-decision encoder의 multilingual 성능을 provenance가 문서화된 형태로 측정합니다. 핵심 결론은 다음과 같습니다.
- Multilingual encoder의 task fine-tuning이 native data 양보다 주된 lever입니다.
- 상위 system들은 약 4 points 이내에서 이 split으로 구분할 수 없습니다.
산업적으로는 배포 전 언어별 gap을 audit하고, Router 경유 시 실제 성능(77.3%)을 fine-tuned 모델과 비교하는 실용적 기준을 제공합니다. 학술적으로는 다음 실천을 모범적으로 보여줍니다.
- TF-IDF 같은 cheap baseline과의 비교
- Statistical power 명시
- Reduced exposure와 zero-shot의 구분
- Code-mixed split과 native split의 분리 보고
다만 모든 text와 label이 LLM 생성물이고 native speaker 검수가 없습니다. 따라서 실제 traffic 성능 추정이나 language ranking 용도로는 사용할 수 없으며, 저자들은 human-written test split을 다음 버전으로 계획하고 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] Joint or Per-Option? Compact Encoders for Closed-Set Decisions from 17 Million to 1 Billion Parameters
- [논문리뷰] Bits or permutations? Spending a fixed inference budget on weight precision or on option-order averaging in small local language models
- [논문리뷰] IndicTalk: A Large-Scale Persona-Based Multilingual Conversational Corpus for Indic Languages
Review 의 다른글
- 이전글 [논문리뷰] Module-Aware Optimization for Graph Neural Networks
- 현재글 : [논문리뷰] PolyRoute: A Twelve-Language and Code-Mixed Benchmark for Typed-Decision Routing, with Baselines and a Leaderboard
- 다음글 [논문리뷰] Precision on Demand: Escalating Weight Bits at Uncertain Decoding Steps in a Small Local Model
댓글