[논문리뷰] Experience-Handoff Reinforcement Learning for Recursive Self-Improvement
링크: 논문 PDF로 바로 열기
저자: Doyoung Kim, Byeongguk Jeon, Kailin Zhang, Sherry Yang (New York University, KAIST AI)
1. Key Terms & Definitions (핵심 용어 및 정의)
- Experience Handoff: 한 시도(attempt)에서 얻은 환경 정보를 이후 시도로 전달하는 과정입니다. 전달 방식은 두 가지입니다. 하나는 scalar reward를 통해 weight에 흡수하는 방식이고, 다른 하나는 reflection, note, playbook 같은 텍스트 artifact를 다음 rollout의 입력으로 넘기는 방식입니다.
- EHRL (Experience-Handoff RL): harness 전체 실행의 최종 outcome을 objective로 삼아, actor뿐 아니라 harness 안의 모든 model call(reflection, curation 등)을 함께 학습하는 RL 프레임워크입니다.
- ACE harness / Playbook: Agentic Context Engineering의 task-local 변형입니다. 하나의 model이 세 가지 role을 수행합니다.
- actor: task를 수행합니다.
- reflector: trajectory에서 insight를 추출합니다.
- curator: ADD/UPDATE/REMOVE 연산으로 playbook(자연어 tip 목록)을 편집합니다.
- Handoff Value: curator가 만든 후보 playbook P′를 fresh actor rollout으로 실제 실행해 task verifier가 매긴 reward입니다. learned reward model 없이 handoff artifact를 검증 가능하게 채점합니다.
- RSI@K: frozen weight 상태에서 K번의 순차적 handoff iteration을 수행하고, 그중 최고 reward를 기록하는 평가 protocol입니다. 같은 K개의 actor episode를 독립적으로 쓰는 pass@K와 비교됩니다.
2. Motivation & Problem Statement (연구 배경 및 문제 정의)
본 논문은 "model이 task outcome만으로 행동하는 법과 미래의 자신이 물려받을 experience를 작성하는 법을 동시에 학습할 수 있는가"라는 문제를 다룹니다.
두 기존 접근은 각각 한쪽만 갖추고 있습니다 [Figure 1].
- Outcome-only RL (GRPO, PPO): 학습은 되지만, trial 전체를 하나의 scalar로 압축하면서 error log, tool output, 발견된 제약 조건 같은 fine-grained 정보를 버립니다.
- Reflexion, ACE 같은 RSI harness: 풍부한 텍스트 experience를 전달하지만, 이를 작성하는 model은 frozen 상태입니다. 따라서 handoff artifact의 품질은 학습되지 않으며, 작은 open model에서는 RSI 효과가 미미합니다.
- GEPA, Meta-harness 같은 harness optimization: model 주변의 prompt와 code를 바꿀 뿐, model 자체의 experience 작성 능력은 개선하지 않습니다.
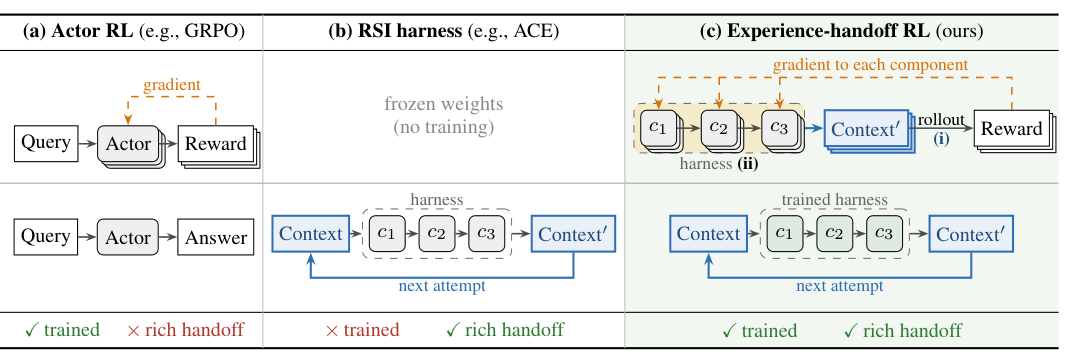
Figure 1 — 기존 두 접근(outcome-only RL, frozen harness)과 제안 프레임워크의 차이를 보여주는 개념 다이어그램
또한 GRPO로 actor만 학습한 checkpoint를 harness에 넣는 일반적인 관행에는 문제가 있습니다. AppWorld에서 8번 시도 후 성능이 같은 checkpoint의 독립 sampling(pass@8)보다 낮았습니다. 즉 playbook 편집이 task 적응에 기여하지 못했습니다.
end-to-end chain에 단일 reward를 부여하면 credit assignment 문제도 생깁니다. seed trajectory, reflection, edit, 후속 rollout 중 어느 것이 원인인지 구분할 수 없습니다.
3. Method & Key Results (제안 방법론 및 핵심 결과)
ACE-RL은 fixed ACE harness 안에서 actor, reflector, curator를 하나의 shared policy로 GRPO-style update를 통해 공동 학습합니다. 핵심 구성 요소는 다음과 같습니다.
(1) Verifiable reward for handoff artifacts
- 각 curator edit u는 Apply(P,u)로 생성된 후보 playbook을 fresh rollout으로 실행한 reward V̂(P′)를 받습니다.
- reflection은 자신에서 파생된 admissible edit들의 평균 value를 받습니다.
- actor rollout은 자신의 task reward를 받습니다.
- inadmissible edit(playbook을 바꾸지 않는 edit 포함)은 reward 0입니다.
(2) Role별 comparison group을 갖는 sparse sampling tree [Figure 3]
- N=4 seed rollout을 생성합니다.
- 균일하게 선택한 하나의 seed에 대해 M=2 reflection을 생성합니다.
- 균일하게 선택한 하나의 reflection에 C=3 edit을, 나머지 reflection에는 1개의 edit을 생성합니다.
- 후보별로 1개의 evaluation rollout을 수행하고, 이 rollout은 actor group에 합류합니다.
- 결과적으로 task당 actor rollout은 최대 8개로 GRPO와 동일한 budget입니다.
- advantage는 각 role의 same-input group 안에서 정규화됩니다. 그래서 실패한 seed에서도 positive reflection이 나올 수 있습니다.
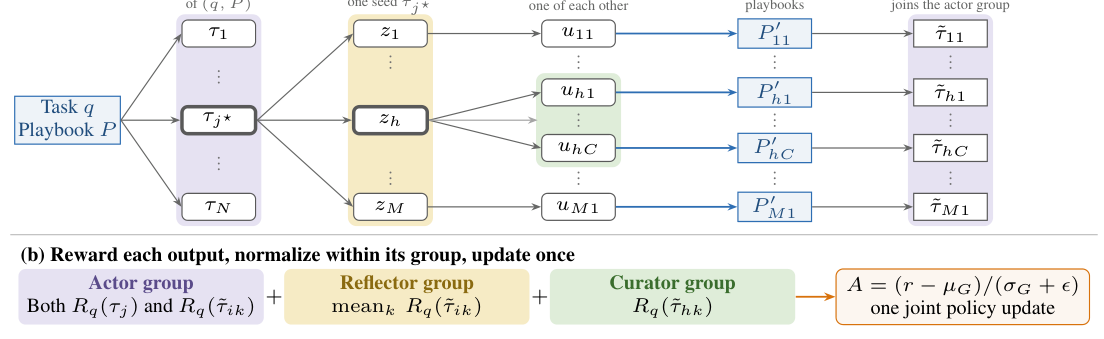
Figure 3 — actor/reflector/curator별 comparison group과 handoff reward 계산 방식을 설명하는 핵심 방법론 그림
(3) 이론적 근거와 운영 장치
- Appendix는 full-tree estimator가 EHRL gradient의 unbiased estimator임을 보입니다.
- chain-wise 설계와 비교하면, per-role group은 credit의 target이 아니라 variance를 바꿉니다. 구체적으로 seed term을 제거합니다.
- playbook은 seed reward 이상인 후보 중 최고 value 후보로 갱신되고, F=3 encounter마다 reset됩니다.
주요 결과 (equal training compute) [Table 2]
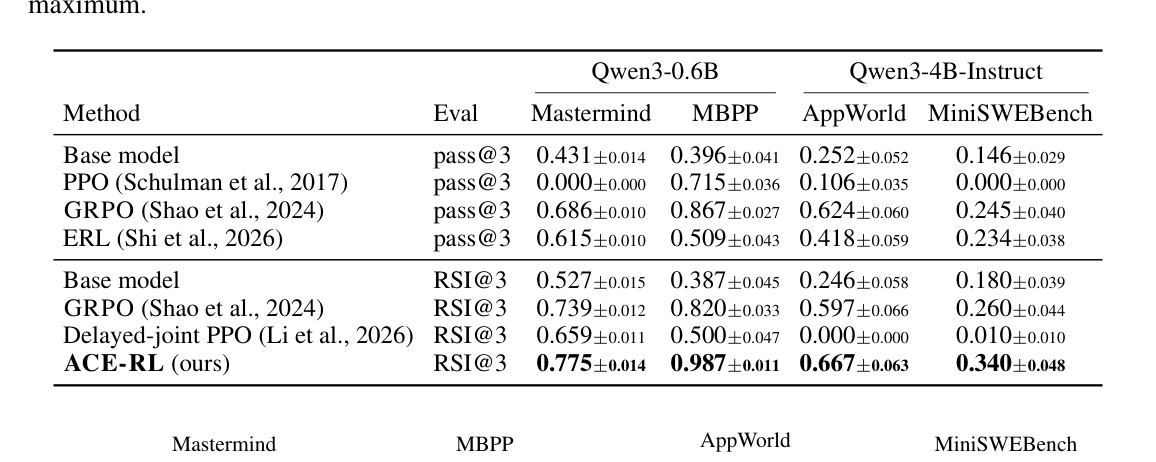
Table 2 — 4개 benchmark에서 ACE-RL과 baseline의 핵심 정량 결과 비교
| Benchmark | ACE-RL RSI@3 | GRPO pass@3 |
|---|---|---|
| Mastermind | 0.775 | 0.686 |
| MBPP | 0.987 | 0.867 |
| AppWorld | 0.667 | 0.624 |
| MiniSWEBench | 0.340 | 0.245 |
- ACE-RL은 4개 benchmark 모두에서 최고 성능을 기록했습니다.
- paired gain은 +0.089 / +0.120 / +0.042 / +0.095입니다.
- GRPO를 harness에 넣은 경우(RSI@3): ACE-RL이 각각 +0.037, +0.167, +0.070, +0.080 앞섰습니다.
- Delayed-joint PPO (critic 기반 end-to-end chain credit): 초기에 peak를 찍은 뒤 붕괴했습니다. AppWorld 0.000, MiniSWEBench 0.010이며, critic의 explained variance는 0.95 이상이었습니다.
- PPO: Mastermind와 MiniSWEBench에서 0으로 수렴했습니다.
- ERL: 4개 benchmark 모두에서 GRPO보다 낮았습니다.
- Training horizon 이후 일반화: K=8에서 ACE-RL RSI@8은 0.81 / 0.99 / 0.81 / 0.40, GRPO pass@8은 0.78 / 0.91 / 0.68 / 0.30이었습니다. 학습 시 cutoff(K=3) 이후에도 우위가 유지됩니다.
- Edits-discarded control (playbook의 기여분 측정): AppWorld K=2에서 +0.105±0.041, MiniSWEBench K=3에서 +0.090±0.040이었습니다. 다만 Mastermind에서는 K≥5부터 효과가 사라졌습니다.
- Compute: ACE-RL의 update FLOPs는 GRPO 대비 step당 **1.01–1.21×**입니다. 이 수치에는 generation 비용이 포함되지 않습니다.
4. Conclusion & Impact (결론 및 시사점)
ACE-RL은 harness의 handoff artifact를 실행 결과로 검증하고 role별 comparison group을 부여하는 방식으로, model이 행동과 experience 작성을 동시에 학습할 수 있음을 보였습니다. 이 결과는 GRPO의 actor-rollout budget 안에서 actor-only RL, ERL, critic 기반 end-to-end 학습보다 높은 held-out 성능으로 이어졌습니다.
이 연구는 "agent 학습은 현재 rollout의 행동뿐 아니라 미래 rollout이 물려받을 model-written experience까지 최적화해야 한다"는 관점을 제시합니다. 또한 hand-built harness에 actor-only RL 모델을 끼워 넣는 업계의 일반 관행이 train–inference mismatch를 일으킨다는 점을 실증했습니다.
다만 다음과 같은 한계가 있습니다.
- 실험은 ≤4B model에 한정됩니다.
- method당 single run입니다.
- playbook은 task-local입니다.
- 일부 MBPP 평가는 scored assertion이 노출된 환경에서 수행되었습니다.
frontier scale 확장과 cross-task transfer는 열린 과제로 남아 있습니다.
⚠️ 알림: 이 리뷰는 AI로 작성되었습니다.
관련 포스트
- [논문리뷰] SkillRise: Agentic Reinforcement Learning for Cross-Task Skill Evolution
- [논문리뷰] FC-SWE: Failure-Conditioned RL for Long-Horizon Software Engineering Agents
- [논문리뷰] Harness^2: Recursive Agent Harnessing for an Open World
- [논문리뷰] RSIAgent: Autonomous Exploration for Recursive Self-improvement in New Environments
- [논문리뷰] Recurrent Harness for Agentic Continual Learning
Review 의 다른글
- 이전글 [논문리뷰] Evidence-Guided Recovery for AI Agents with Ambiguous Tool Outcomes and Partial Execution
- 현재글 : [논문리뷰] Experience-Handoff Reinforcement Learning for Recursive Self-Improvement
- 다음글 [논문리뷰] Factored One-sided Adam-Moment for Practical and Scalable SOAP
댓글